 Русский
 English
Cryptocurrencies:
8108 /
Markets: 110010
Market Cap: $ 2 672 208 789 495 /
24h Vol: $ 63 550 705 753 /
BTC
Dominance: 60.020185459929%
Новости
[Перевод] Фаззер против ИИ-агента на V8: 37 и 45 уязвимостей за полгода, общих — четверть
Кратко
Мы в Project Zero сравнили два автоматических инструмента, которыми Google постоянно ищет уязвимости в V8, JavaScript-движке Chrome. Fuzzilli — генеративный фаззер для JavaScript-движков, BigSleep — система поиска багов на основе LLM. За последние полгода BigSleep нашёл больше уязвимостей, чем Fuzzilli (45 против 37), а совпали из найденных багов 25%. Такой способ подсчёта склонен занижать пересечение, поэтому мы дополнительно поставили эксперименты, чтобы оценить теоретическое пересечение на уязвимостях, найденных с 2023 года. По этим экспериментам оно составило около 60%. Какая бы из оценок ни была точнее, заметная часть уязвимостей нашлась только с помощью LLM или только фаззингом. То, что LLM за такой короткий срок научились находить столько уязвимостей, очень обнадёживает, но фаззинг и LLM пока дополняют друг друга. Мы советуем разработчикам ПО применять к своему коду и фаззинг, и агентный анализ: так до пользователей доберётся меньше уязвимостей.
Введение
Фаззинг давно и успешно применяют для поиска багов в проектах вроде Chrome или V8. Но в последнее время мощные LLM, способные читать код, рассуждать о нём и писать его, коренным образом меняют и разработку, и безопасность ПО. В хорошо профаззенных проектах находят сотни, а иногда и тысячи новых багов и уязвимостей, и возникает естественный вопрос: как новые LLM соотносятся с «традиционными» фаззерами? Начинают ли они их вытеснять или два подхода дополняют друг друга? Чтобы ответить, мы рассмотрим три главных вопроса:
Сколько багов находит каждый подход в реальных условиях?
Насколько пересекаются результаты двух подходов?
Какова «форма» багов, которые находит одна система и не находит другая?
В этом посте мы ограничимся двумя конкретными системами: Fuzzilli, фаззером JavaScript-движков, и BigSleep, агентной системой поиска багов. Обе работают в продакшене и автоматически ищут баги в свежем коде, поэтому их можно сравнивать почти напрямую. Fuzzilli работает непрерывно на множестве инстансов, и первые из них обычно подхватывают новые изменения в течение нескольких часов. BigSleep сейчас запускается раз в сутки: ему дают задание просмотреть новые коммиты и для каждого найденного бага написать тесткейс, доказывающий проблему (proof-of-concept). Обе системы сообщают о багах через Clusterfuzz: он выполняет базовую сортировку падений и заводит баг-репорты в трекере Chrome.
Целью мы тоже взяли только V8 — высокопроизводительный движок JavaScript и WebAssembly со сложной и зрелой инфраструктурой тестирования и фаззинга. Fuzzilli как раз специализированный инструмент для поиска багов в таких движках. Баги здесь обычно запутанные, и это делает V8 интересным «полигоном»: можно сравнить, насколько каждый подход способен находить глубокие и сложные баги в хорошо протестированном ПО. Похожий анализ на более широком наборе целей, фаззеров и агентных систем оставляем на будущее.
Каждому из трёх вопросов посвящён свой раздел. В каждом сначала кратко описан общий подход, затем подробно методика (часто списками, так что эти блоки можно пропустить, если детали не интересны), а потом разобраны результаты. В конце мы попробуем истолковать результаты и описать, где сейчас находятся фаззинг и ИИ относительно друг друга.
Часть 1. Статистика из продакшена
Эта часть анализируется проще всего, хотя и с оговорками, о которых чуть ниже. Идея в том, чтобы выгрузить задачи из баг-трекера Chromium (там ведутся и баги V8) и посчитать по ним статистику. Это особенно легко, потому что у каждой из двух систем есть свой отдельный хотлист. Анализ ограничен шестью месяцами, с апреля по сентябрь 2026 года: автоматический конвейер BigSleep заработал только в апреле этого года. Исходные данные взяты из двух запросов к трекеру:
Сырое число баг-репортов получается такое:
Fuzzilli: 316
BigSleep: 441
Небольшая победа BigSleep. Однако сюда входят баги всех типов, а BigSleep поначалу находил в V8 много проблем конфигурации и интеграции. Например, crbug.com/503869331: там ещё не работал как надо механизм блокировки небезопасных флагов. Это настоящие проблемы, но для нашего сравнения они менее важны: реального влияния на безопасность у них почти нет. Самый простой способ их отсечь — смотреть только на уязвимости, ограничив выдачу условием type:vulnerability:
Fuzzilli: 178
BigSleep: 95
Внезапно — явная победа фаззеров? Не совсем. В данных остаются проблемы, прежде всего дубликаты и репорты, по которым ничего делать не нужно (например, баги, закрытые как WAI, то есть «работает как задумано»). На первый взгляд, это легко исправить, добавив ещё одно условие вроде status:(fixed | verified). К сожалению, всё немного сложнее. Возьмём баг Fuzzilli crbug.com/511935486. События по нему, по сути, такие:
11 мая Clusterfuzz заводит баг и назначает его инженеру.
В тот же день Clusterfuzz закрывает баг, потому что тесткейс больше не воспроизводится.
То есть ни один разработчик к этому багу не прикоснулся. Скорее всего, это был дубликат другого бага, crbug.com/511210507, но Clusterfuzz этого не понял: сигнатура падения (её строят по стектрейсу) немного отличалась. Когда другой баг исправили, тесткейс перестал воспроизводиться в Clusterfuzz, и тот закрыл задачу.
Пожалуй, лучшее, что тут можно сделать, — смотреть на «рабочие» (actionable) баги: не помеченные как дубликат или WAI и получившие хотя бы один коммит с исправлением, который на них ссылается. Если затем оставить только баги типа Type-Vuln, отсеется много менее важных багов BigSleep, хотя они и были «рабочими». В итоге картина такая:
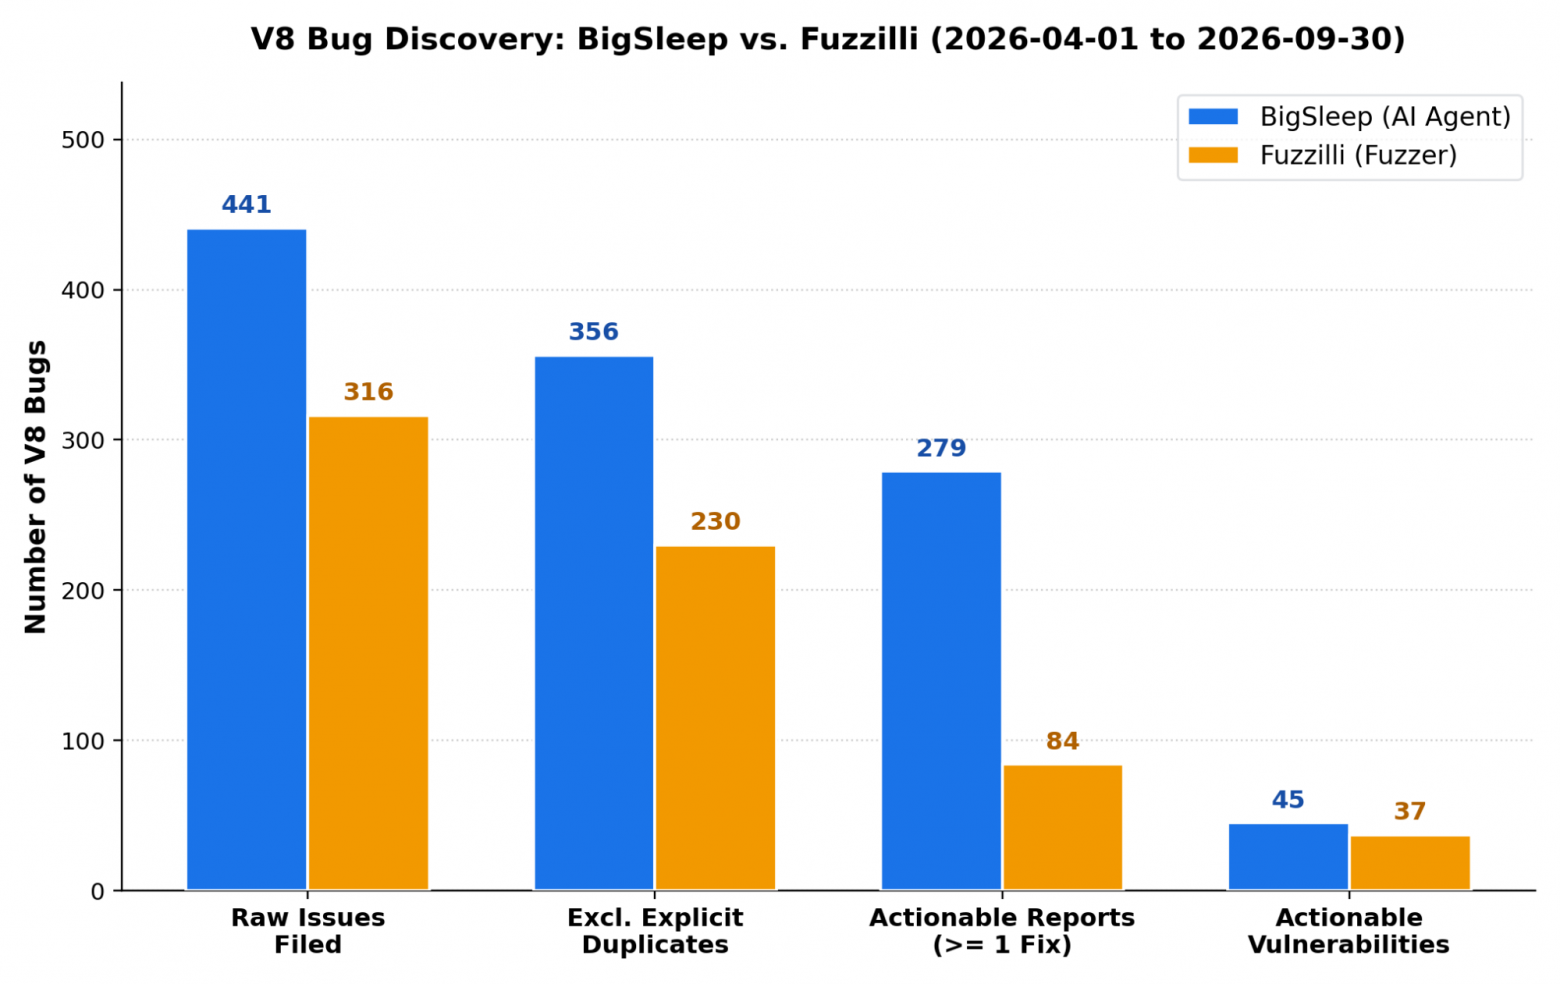
Так что по уязвимостям сейчас примерно ничья, с небольшим перевесом BigSleep: 45 против 37.
Отсюда естественно возникает вопрос о стоимости: во сколько обходится каждый подход и сколько стоит один найденный баг? К сожалению, на нынешнем этапе исследования такое сравнение провести сложно. Над эффективностью Clusterfuzz в своё время поработали, а над BigSleep сопоставимой работы пока не проводилось, и ни одна из систем специально не настроена на оптимальную цену за баг.
Часть 2. Пересечение
Следующий вопрос — насколько результаты двух подходов пересекаются. Мы подошли к нему с двух сторон. Сначала попытались найти ответ в баг-трекере, выявив баги, которые нашли обе системы. Затем поставили отдельный эксперимент: дали BigSleep попробовать заново найти старые баги Fuzzilli.
Пересечение по баг-трекеру
Идея в том, чтобы найти баги, обнаруженные обеими системами, то есть по сути искать дублирующиеся баг-репорты. Как и в первой части, чтобы картина получилась более-менее точной, нужно сделать несколько шагов:
Сначала ищем баги, заведённые одной системой и помеченные как дубликат бага, заведённого другой. Например, crbug.com/522410841 — дубликат crbug.com/522860268. Это явное пересечение.
Дальше нужно учесть, что многие «нерабочие» репорты (те, к которым не привязано ни одного исправления) часто оказываются дубликатами. Для таких репортов надо найти коммит, который их исправил, посмотреть, к какому багу привязан этот коммит, и считать эти два бага дубликатами. Связь может быть и многосторонней: баг X от BigSleep и баг Y от Fuzzilli могут оба оказаться дубликатами бага Z, о котором сообщил кто-то или что-то третье. Тогда это всё равно считается пересечением.
Затем нужно помнить, что многие дубликаты вообще не попадают в баг-трекер: их отсеивает ещё Clusterfuzz (и Fuzzilli, и BigSleep полагаются на него в базовой сортировке и заведении багов). Поэтому приходится обращаться к базе данных самого Clusterfuzz и искать дубликаты там.
Наконец, нужно решить, что делать с разными багами, которые исправлены одним и тем же CL, например с четырьмя багами, исправленными в crrev.com/c/7965120. У действительно разных багов такое бывает, но вероятнее, что это дубликаты (как в этом случае), и мы их так и считаем.
После всех видов дедупликации получается такая картина:
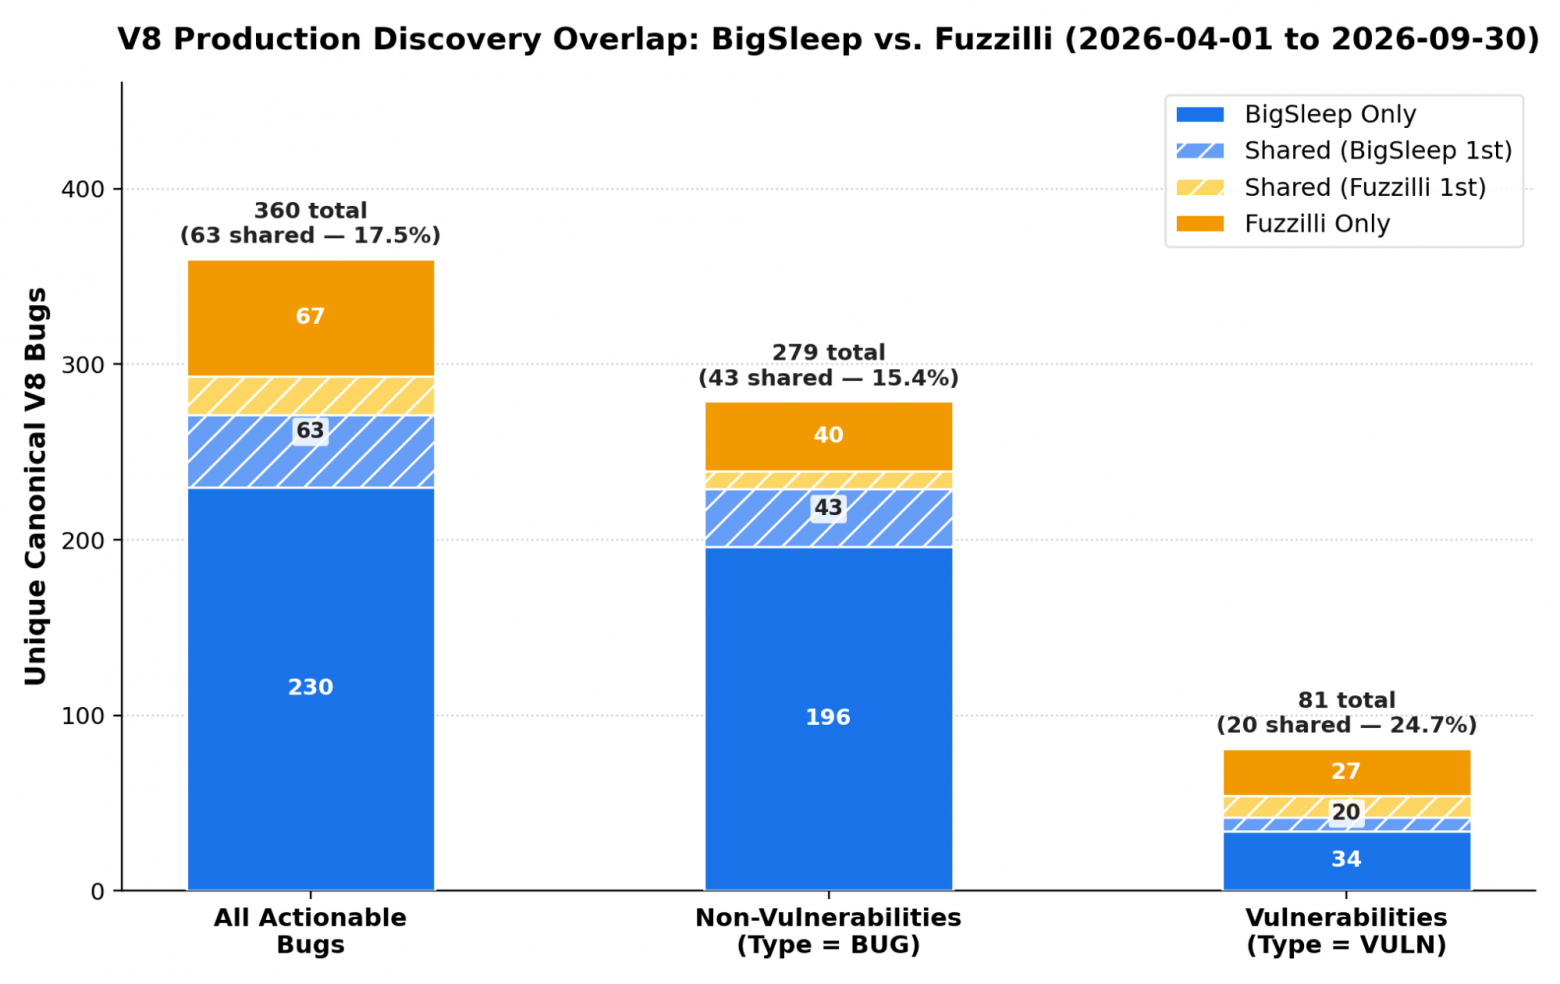
Если опять смотреть только на рабочие репорты об уязвимостях (вероятно, это лучшая мера), пересечение составляет примерно 25% (20 из 81), причём чуть больше половины из них сначала нашёл Fuzzilli, а потом BigSleep.
Эксперимент по пересечению
Второй способ измерить пересечение — поставить отдельный эксперимент и попытаться найти одной системой баги, которые в прошлом нашла другая. Конкретно мы пытались заново найти старые баги Fuzzilli с помощью BigSleep в конфигурации, максимально близкой к продакшену. Для каждого бага мы брали коммит, который (вероятно) его внёс, и просили агента проверить эти изменения так же, как в продакшен-CI.
Обратное направление, то есть поиск прошлых багов BigSleep с помощью Fuzzilli, настроить сложнее: фаззеру нельзя так же легко задать похожую «отправную точку». К тому же для многих таких багов исход эксперимента уже известен. Большинство «исторических» багов BigSleep (например, найденные в 2025 году) были обнаружены после того, как фаззеры вроде Fuzzilli уже месяцами, а то и годами фаззили уязвимые сборки. Так что в эксперименте фаззер их, скорее всего, тоже не нашёл бы (разве что в немногих случаях, когда Fuzzilli с тех пор научили поддерживать новые возможности языка). И в продакшене BigSleep сообщает о падениях с задержкой в 1–2 дня (сейчас он запускается раз в сутки), так что и там у фаззеров фора.
Подробнее эксперимент устроен так:
Начинаем со списка исторических багов Fuzzilli (с начала 2023 до середины 2026 года), выгруженного из хотлиста в баг-трекере. Это даёт около 1150 сырых багов.
Оставляем только
type:vulnerability: именно такие баги нас интересуют больше всего, а заодно уходит часть «шума», как и выше. Остаётся примерно 600 уязвимостей.Затем оставляем только баги, которые воспроизводятся в окружении агента. Здесь два условия:
Баг воспроизводится на x64-сборке оболочки d8 в режиме debug+asan, которую выкладывает публичная сборочная инфраструктура Chrome. Это важно, потому что многие баги воспроизводятся только в особых сборках, например зависят от архитектуры или требуют определённых возможностей, включаемых при компиляции.
Баг воспроизводится без специальных флагов. Проблема в том, что фаззеры часто выставляют собственные флаги: чтобы включить возможности, которые ещё в разработке (например,
--experimental-wasm-jspiв crbug.com/361123483), или чтобы включить режимы фаззинга, в которых определённые типы багов находятся легче (например,--deopt-every-n-timesв crbug.com/362784006). Но разрешить агенту ставить произвольные флаги на исторических сборках V8 мы не можем: в них не было режима «только безопасные флаги», и это давало бы много ложных падений. Подсказывать агенту, какие флаги использовать в конкретной задаче, мы тоже не хотим, ведь это была бы подсказка. Поэтому для простоты мы ограничились багами, которые воспроизводятся со стандартным набором флагов (--fuzzing,--jit-fuzzing,--expose-gc), и разрешили агенту ставить только их.
Получается 132 исторических бага.
Проводим дедупликацию, похожую на описанную выше, чтобы найти неявные дубликаты, и убираем их. В итоге остаётся 112 багов.
Чтобы сравнение было реалистичным, превращаем эти баги в «задачи на код-ревью», похожие на те, что использует продакшен-конвейер BigSleep. Для этого пытаемся найти коммит, который (вероятно) внёс баг, например бисекцией. Заметим, что это смещает сравнение не в пользу BigSleep по двум причинам:
Скорее всего, иногда мы находим не тот коммит, не связанный с багом, и задача становится сложнее или вообще невыполнимой.
На каждый баг у нас ровно один коммит, а в реальности агент мог бы обнаружить баг по другому, более позднему коммиту, затрагивающему похожую часть кода.
Запускаем агента на каждом коммите 25 раз. Агента просят найти баги, связанные с коммитом, и доказать их существование тесткейсом, который роняет уязвимую сборку. Попытка завершается, как только найдено падение, так что каждая попытка может сообщить не больше чем об одном баге. Конфигурация по сути та же, что использовалась в продакшен-BigSleep в то время, включая ту же модель: Gemini 3.6 flash.
Наконец, результаты обрабатываем, чтобы проверить, нашёл ли агент «тот самый» баг или какой-то другой. Для этого проверяем, что тесткейс роняет ревизию до исправления и не роняет ревизию после него. Способ неидеальный, но реализуется довольно просто.
Вот результаты эксперимента:
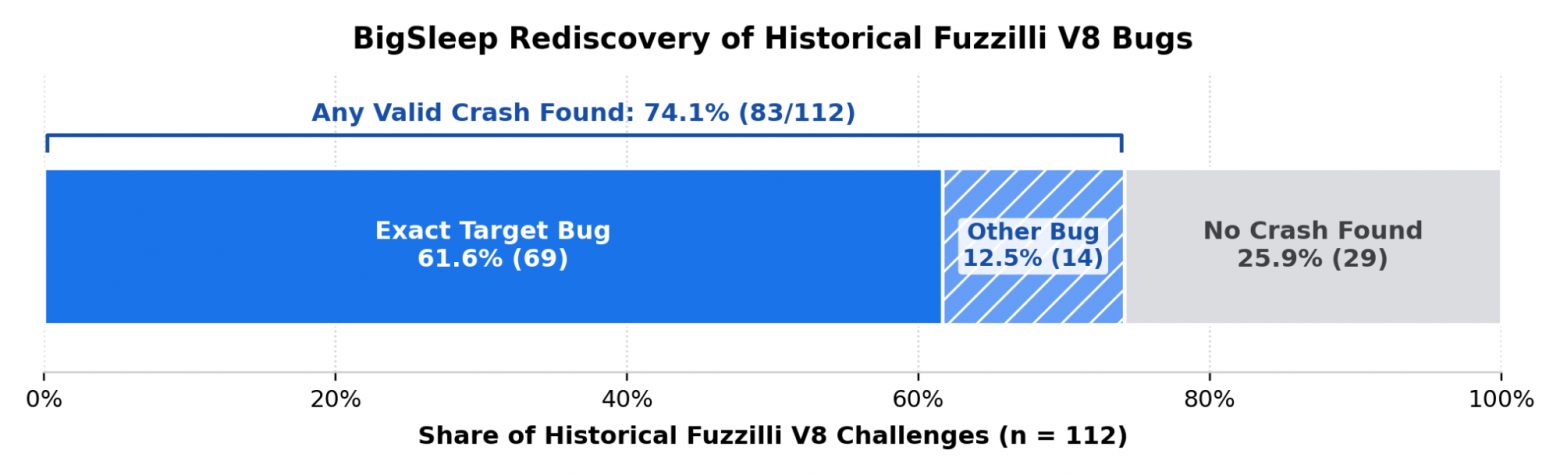
Стартуя только с коммитов, которые (вероятно) внесли баги, BigSleep смог заново найти примерно 62% исходных багов, а ещё примерно для 12% коммитов нашёл другой баг (к настоящему времени уже исправленный). Примерно на 26% коммитов он не нашёл никаких багов.
Запоминание
В подобных экспериментах беспокоит запоминание: LLM может помнить конкретные баги из данных (пред)обучения, и тогда ей легче «переоткрыть» их при оценке. Получить представление о масштабе эффекта можно, сравнив долю успехов на багах из разных периодов, например по полугодиям, за которые в наборе данных есть баги. Если бы запоминание было, мы ожидали бы более высокой доли успехов (как для одной попытки, так и для всего прогона) на багах, появившихся до даты среза обучающих данных модели. Вот результаты нашего эксперимента:
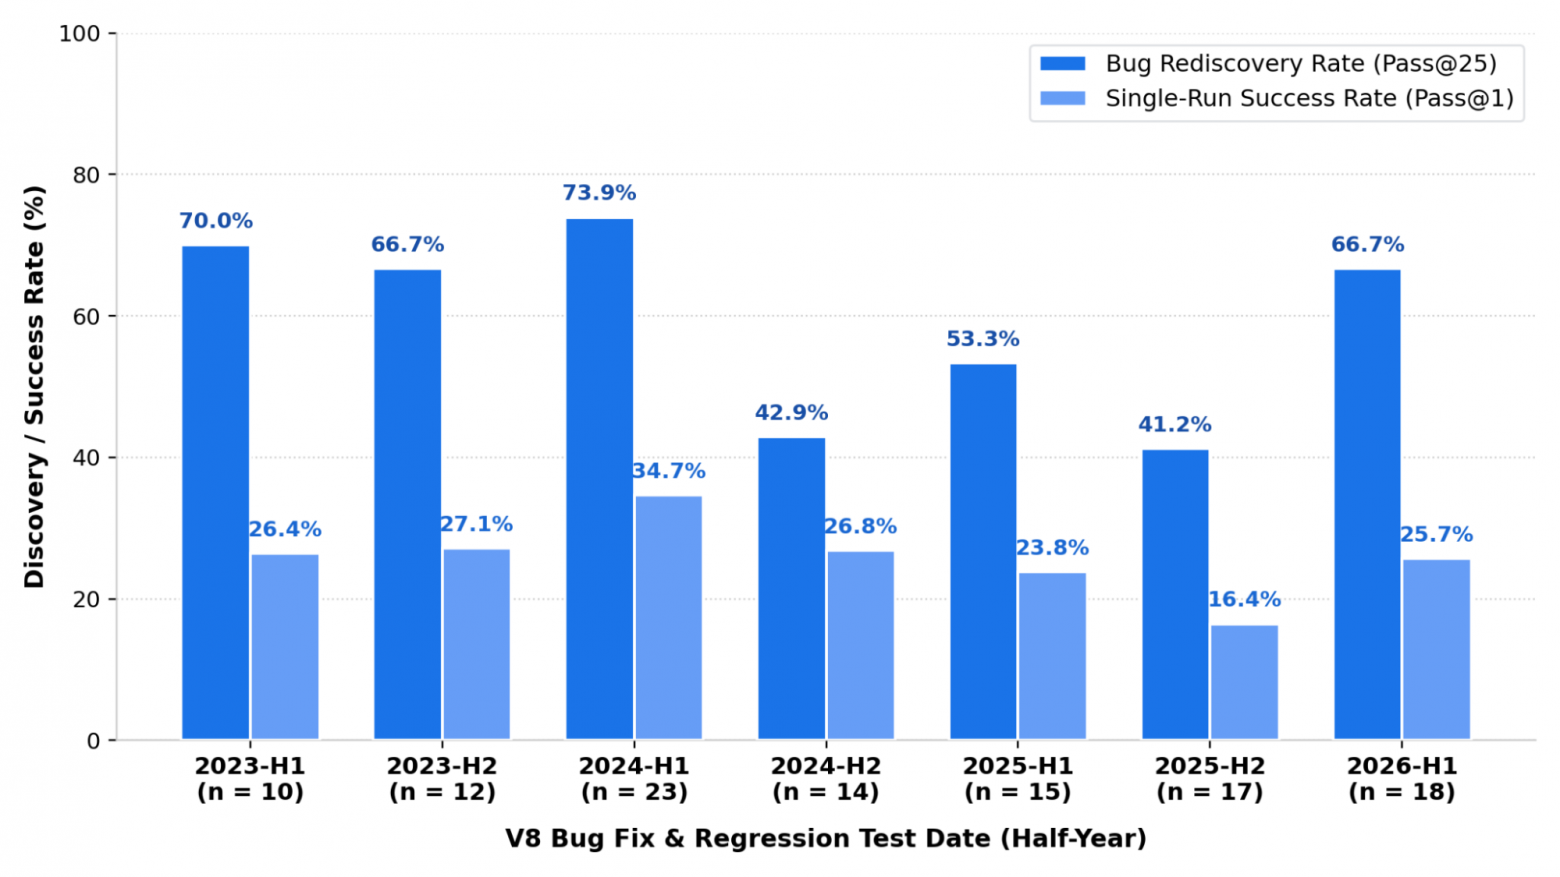
У модели из эксперимента (Gemini 3.6 flash) дата среза знаний — март 2026 года. Если учесть, что в начале 2026 года баги Chrome становились публичными примерно через 3 месяца, эффективный срез знаний по багам Fuzzilli приходится примерно на январь 2026-го. Судя по данным, статистически значимого запоминания на багах до 2026 года нет. Однако у других моделей или у будущих поколений моделей это может быть иначе, поэтому в похожих экспериментах мы советуем проверять это заново.
Сложность
Следующий вопрос: как пересечение зависит от «сложности» бага. В лучшем случае система вроде BigSleep легко находила бы то, что фаззерам даётся с трудом, и наоборот. Тогда бюджет, который раньше уходил на долгие сессии фаззинга, можно было бы перераспределить на другие задачи. Вот результаты такого анализа; «сложность бага» здесь измеряется временем, которое понадобилось Fuzzilli, чтобы его найти:
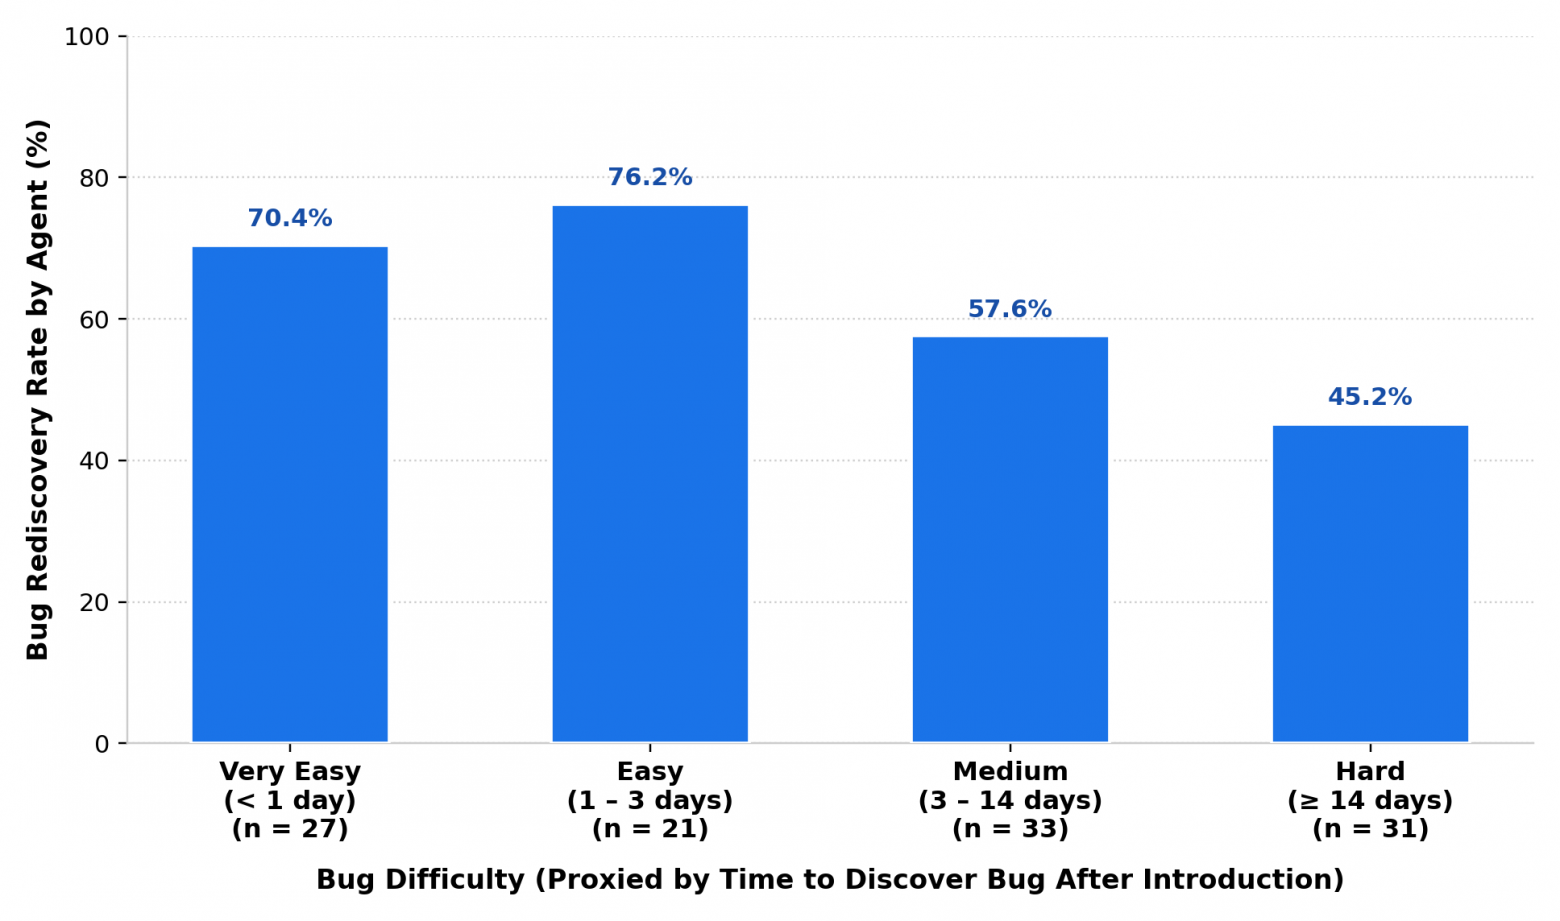
Результат статистически значимый (хотя и не слишком большой по величине), но указывает он в обратную сторону! Баги, которые трудно найти фаззеру, скорее всего, трудно найти и ИИ-агенту. Так что эти фаззеры пока, видимо, стоит не выключать.
Компоненты
Ещё можно разбить баги и долю их повторного обнаружения по компонентам:
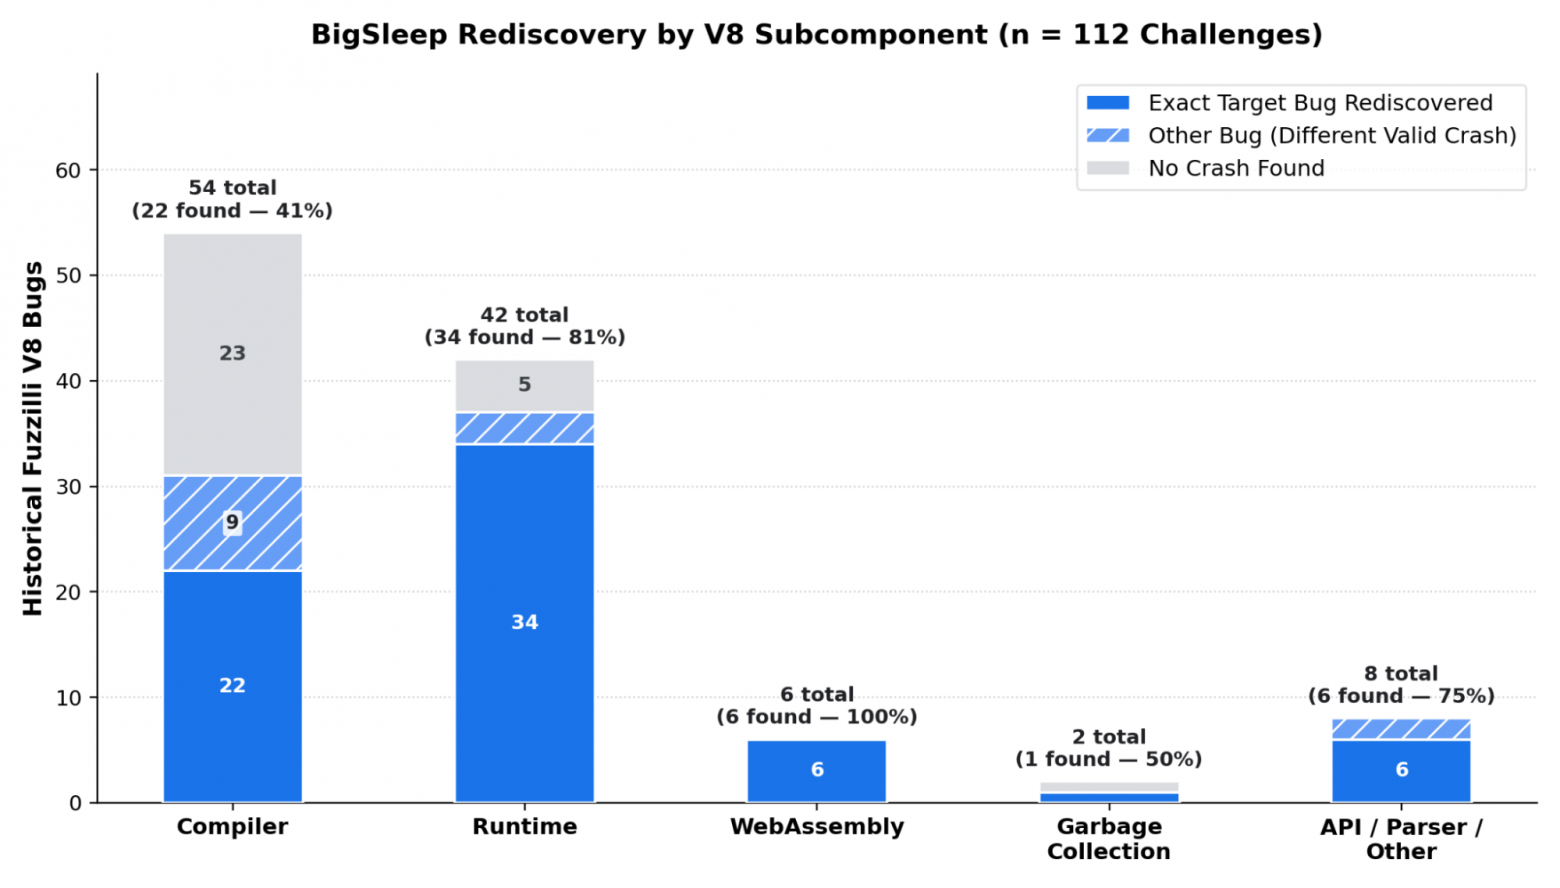
Интересно, что для багов в компиляторах пересечение заметно меньше. Именно на компиляторах Fuzzilli, вероятно, специализируется сильнее всего, и это может объяснять результат. Дальше, в третьей части, мы выдвинем ещё одну гипотезу о том, почему (некоторые) баги в компиляторах BigSleep может быть сложнее найти заново.
Промпты
Последний вопрос — насколько результаты ИИ-агента зависели от конкретного промпта. Чтобы это проверить, мы провели два быстрых дополнительных эксперимента с другими промптами, только на багах, которые до этого найти заново не удалось:
Вместо коммитов стартуем с уязвимого файла или функции. Возможно, отправная точка так проще, но постановка всё ещё довольно реалистичная: и то и другое можно получить, например, выделив изменённые файлы и функции из коммита.
Вместо того чтобы просить агента искать уязвимости, связанные с повреждением памяти (именно они нас больше всего интересуют), прямо говорим ему, что срабатывания assert’ов и подобные падения тоже годятся.
В этих двух экспериментах было всего 5 попыток на баг (вместо 25 в основном), и агент заново нашёл ещё 10 багов: 8 при другой отправной точке и 7 с переформулированным промптом (5 из них нашлись в обоих прогонах).
Если объединить эти результаты с основным экспериментом, получается такая картина:
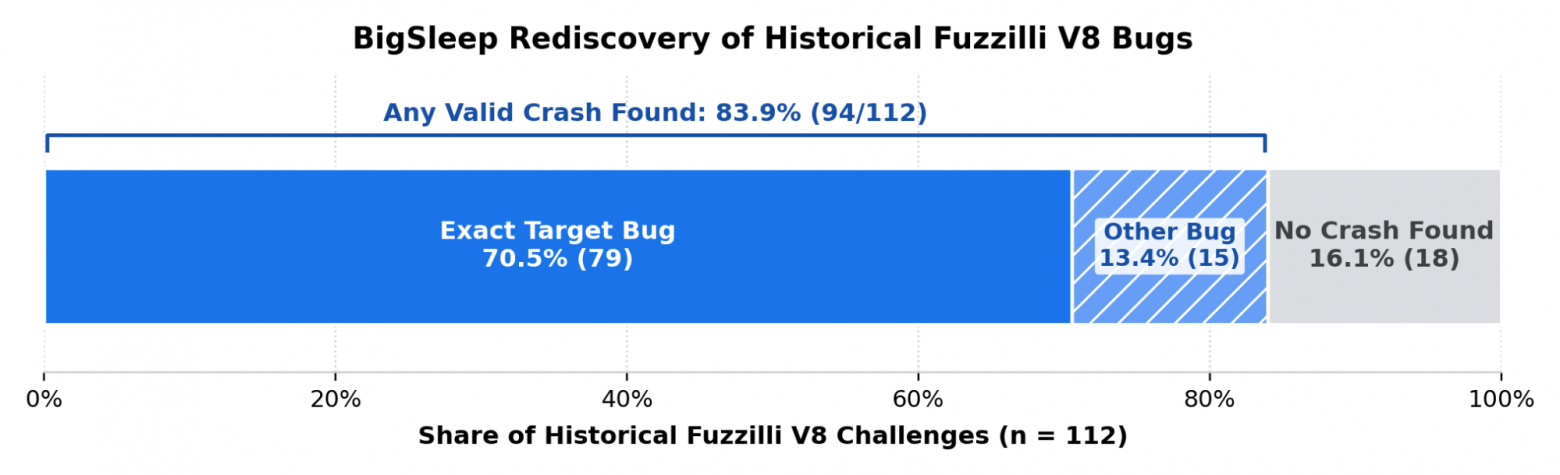
Доля найденных «правильных» багов вырастает примерно до 70%, а хоть какой-то баг находится примерно для 84% отправных точек. Справедливости ради, аналогичные доработки фаззера, вероятно, тоже повысили бы долю обнаружения некоторых багов, так что к результатам этого дополнительного эксперимента стоит относиться с осторожностью.
Итоги второй части
Главные результаты, полученные с двух сторон:
В продакшене пересечение заметное, но не большое — около 25%.
В нашем эксперименте пересечение составило около 60% исторических багов Fuzzilli (70% с дополнительными прогонами на других промптах).
Пересечение распределено неравномерно:
Баги, которые трудно найти фаззеру, скорее всего, трудно найти и агенту, так что пересечение больше на «лёгких» багах.
В JIT-компиляторах пересечение, похоже, меньше, а в остальной части движка — больше.
Судя только по эксперименту, можно было бы ожидать, что и в продакшене пересечение окажется больше. Однако, вероятно, этому мешает (мешало) несколько факторов:
Окно для пересечения ограничено: как только баг, о котором сообщила одна из систем, исправлен, у другой уже нет шанса найти его снова (баг перестаёт воспроизводиться в Clusterfuzz, и репорт отбрасывается).
Эксперимент охватывал только часть багов Fuzzilli — те, что воспроизводятся на стандартной x64-сборке d8 для фаззинга и без специальных флагов. В продакшене у каждой системы немного разные специализированные сборки и разные ограничения на флаги во время выполнения, и там пересечение может быть меньше.
Из-за сбоев в конвейере, например перегруженных серверов или багов в автоматизации, BigSleep в последние месяцы, вероятно, не просмотрел часть коммитов, и внесённые ими баги могли остаться незамеченными.
С момента запуска в апреле модель, на которой работает конвейер BigSleep, несколько раз обновлялась. Ранние модели, скорее всего, справлялись хуже, а будущие, как мы ожидаем, будут справляться лучше.
Часть 3. Форма багов
В этом разделе мы сначала разберём три примера багов, найденных только одной из двух систем. Затем попробуем сделать выводы по ним и по другим багам.
BigSleep: баг Chrome 449760249 (октябрь 2025)
Этот баг — хороший пример того, как BigSleep благодаря способности модели рассуждать нашёл вариант бага, который фаззер (вероятно) не смог бы вызвать за разумное время из-за его сложности. Заодно на нём хорошо видно, как в целом работает агентная система поиска багов.
Предыстория: TDZ и удаление проверок на hole
Прежде чем разбирать сам баг, нужно заглянуть во внутренности JavaScript, а именно в инициализацию переменных. В JavaScript переменные, объявленные через let или const, нельзя использовать до инициализации: попытка приведёт к исключению (ReferenceError: Cannot access 'foobar' before initialization). В терминологии V8 до инициализации такие переменные находятся во «временной мёртвой зоне» (temporal dead zone, TDZ). Внутри V8 записывает в переменные из TDZ особое значение-маркер the_hole и при обращении к переменной проверяет, не лежит ли там оно.
Чтобы эти проверки на hole меньше били по производительности, байткод-компилятор V8 реализует оптимизацию (за включённым по умолчанию флагом --ignition-elide-redundant-tdz-checks), которая находит избыточные проверки и удаляет их. Идея в том, чтобы найти «доминирующие» проверки: тогда можно гарантировать, что на всех возможных путях к текущей точке проверка на hole для данной переменной уже выполнена.
Это оптимизация, важная для безопасности: ошибочно удалённая проверка на hole приводит к утечке внутреннего значения the_hole в JavaScript-код, а такое состояние исторически удавалось эксплуатировать (хотя с тех пор для этого класса багов выпустили новые защитные меры).
Исходная уязвимость
Исходный баг (issue 40071027, его двумя годами раньше нашёл Fuzzilli!) касался циклов do-while с оператором break. В цикле do-while условие вычисляется после тела. Если в условии есть присваивание переменной, байткод-компилятор помечает переменную как инициализированную. Но если в первой же итерации в теле цикла выполнится break, условие не выполнится никогда. Изначально байткод-компилятор этого не учитывал, из-за чего проверка на hole ошибочно пропускалась и значение the_hole утекало.
Чтобы это исправить, реализацию BytecodeGenerator::VisitDoWhileStatement изменили так:
- VisitForTest(stmt->cond(), ...);
+ if (!loop_builder.break_labels()->empty()) {
+   HoleCheckElisionScope elider(this);
+   VisitForTest(stmt->cond(), ...);
+ } else {
+   VisitForTest(stmt->cond(), ...);
+ }
Патч создаёт HoleCheckElisionScope на время обработки кода условия, если в цикле есть операторы break. Это значит, что все изменения состояния TDZ у переменных отбрасываются, когда объект scope уничтожается. Поэтому код после цикла видит прежнее состояние TDZ (в данном случае это правильное поведение).
Как нашёлся вариант
Агент BigSleep начал анализ с патча к VisitDoWhileStatement и понял, что исправление решает, нужен ли защитный HoleCheckElisionScope, по loop_builder.break_labels()->empty(). Затем он стал выдвигать и проверять разные гипотезы о сценариях, в которых у цикла не зарегистрирован ни один break, но условие во время выполнения всё равно пропускается. Например, он предположил, что логику удаления проверок может сбить try-catch в сочетании с throw внутри цикла. Он изучил, как try-catch реализован в байткод-компиляторе, и заключил, что этот случай обрабатывается правильно.
В конце концов агент взялся за break с меткой, позволяющий сразу выйти из вложенных циклов. Он предположил, что такие break могут обрабатываться неправильно, и стал разбираться, как именно они обрабатываются, например изучая логику в BytecodeGenerator::VisitBreakStatement. На этот раз он, похоже, нашёл настоящий изъян: в случае вложенных break внутренний цикл, судя по всему, не получал информации о существовании оператора break! Поэтому агент сформулировал такую гипотезу об уязвимости:
Если break с меткой внутри цикла
do-whileнацелен на внешнюю область,LoopBuilderвнутреннего циклаdo-whileоб этом не уведомляется.Следовательно,
loop_builder.break_labels()->empty()остаётсяtrue.Поэтому при генерации кода для условия цикла
HoleCheckElisionScope, добавленный патчем, не используется.Во время выполнения условие пропускается, но байткод-компилятор уже ошибочно удалил последующую проверку на hole, и
the_holeутекает в JavaScript.
Затем агент начал писать тесткейс, чтобы доказать существование бага. Первая попытка с двумя вложенными циклами и меткой не удалась: байткод-компилятор добавлял ещё один защитный объект scope для блока с меткой. Чтобы это обойти, агент решил использовать оператор switch. При обработке switch байткод-компилятор с помощью HoleCheckElisionMergeScope вычисляет пересечение состояний инициализации по всем веткам. Агент добился того, чтобы переменная инициализировалась в ветке default, и логика слияния заключила, что переменная корректно инициализирована на всех путях.
Proof of Concept
После этого у агента было всё, чтобы написать тесткейс, демонстрирующий уязвимость. Вот PoC агента:
// Flags: --ignition-elide-redundant-tdz-checks
function trigger(cond) {
  {
    target: switch(1) {
      case 1:
        do {
          // Labeled break targeting the switch. The do-while LoopBuilder remains unaware.
          if (cond) break target;
        } while((x=1) && false); // Condition performs a check/assignment on x.
        break;
      default:
        x=1; // Ensure x is considered initialized across all switch branches for merging.
    }
    // Generator incorrectly believes x is checked/initialized. Elides TDZ check.
    x + 1;
    let x;
  }
 }
 trigger(true);
Вот как работает этот тесткейс:
Выполняется
trigger(true), управление попадает вcase 1оператораswitch.Цикл
do-whileвыполняетbreak target.Управление переходит в конец
switch, минуя условиеdo-while, в котором присваиваетсяx.Во время выполнения
xостаётся неинициализированной (в ней лежитthe_hole).Поскольку проверка TDZ удалена ещё при компиляции, движок отдаёт внутреннее значение
the_holeJavaScript-коду в выраженииx + 1, а это потенциально эксплуатируемое состояние.
Видно, почему фаззеру было бы трудно найти этот баг: тесткейс довольно сложный. Фаззер с обратной связью по покрытию получил бы награду за срабатывание отдельных путей в коде (обработку break с меткой, оператора switch, цикла do-while и т. д. в парсере), но за то, чтобы сложить их вместе «правильным образом», дополнительной награды нет, и прийти к такому тесткейсу очень трудно.
BigSleep: баг Chrome 443765373 (сентябрь 2025)
Этот баг — пример довольно простого типа багов, которые трудно найти стандартными методами фаззинга.
Предыстория: обработка исключений в V8
Чтобы понять этот баг, нужно коротко разобраться, как V8 обрабатывает исключения. Возьмём такой JavaScript-код:
function simple() {
  try {
    throw 42;
  } catch (e) {
    return e;
  }
}
Здесь функция состоит из блока try-catch, внутри которого выбрасывается исключение. Если запустить это в d8 с --print-bytecode, можно увидеть внутренний байткод, который движок генерирует для выполнения кода:
[generated bytecode for function: simple]
         0x2ad5001000e4 @    0 : 1b ff f9  Mov <context>, r0
         0x2ad5001000e7 @    3 : 0d 2a     LdaSmi [42]
         0x2ad5001000e9 @    5 : b5        Throw
         0x2ad5001000ea @    6 : d1        Star1
         0x2ad5001000eb @    7 : 8d f8 00  CreateCatchContext r1, [0]
         0x2ad5001000ee @   10 : d2        ...
         ...
         0x2ad5001000f7 @   19 : b7        Return
Handler Table (size = 16)
   from   to       hdlr (prediction,   data)
  (   3,   6)  ->     6 (prediction=1, data=0)
Для этого бага важна в основном последняя строка вывода. По сути, байткод говорит: «если исключение возникло, когда PC находится между смещениями 3 и 6 в этом байткоде, выполнение надо продолжить со смещения 6 (начала обработчика исключения)».
Баг
Агент заметил баг, просматривая следующую функцию, которая записывает в память структуру данных таблицы обработчиков:
void HandlerTable::SetRangeHandler(int index, int handler_offset,
                                   CatchPrediction prediction) {
  int value = HandlerOffsetField::encode(handler_offset) |
              HandlerWasUsedField::encode(false) |
              HandlerPredictionField::encode(prediction);
  int offset = index * kRangeEntrySize + kRangeHandlerIndex;
  Memory<int32_t>(raw_encoded_data_ + offset * sizeof(int32_t)) = value;
}
Здесь смещение типа int упаковывается вместе с несколькими другими битами данных в новое значение int. Значит, в новом поле handler_offset не может занимать весь диапазон целого числа, и возможно усечение. Агент выяснил точные границы этих значений и понял, что у HandlerOffsetField всего 28 бит (до 256 МБ), а максимальный размер байткода — 512 МБ! Дальше написать падающий тесткейс было сравнительно просто: создать огромную функцию (больше 256 МБ байткода) с обработчиком исключения в конце и выбросить внутри неё исключение. В результате выполнение переходит на неправильное смещение в байткоде, а такой примитив легко эксплуатировать. Вот ключевая часть тесткейса:
// yield statements turn into a large chunk of bytecode
let kNumYields = 500000;
let body = `
  if ("foo" === "bar") {
    ${"yield* 42;".repeat(kNumYields)}
  }
  try {
    throw 42;
  } catch (e) {
     // Will never get here
  }
`;
Фаззеру опять же было бы трудно составить такой тесткейс: за генерацию большого кода его не награждают (по крайней мере, при обычной обратной связи по покрытию). Более того, условия фаззинга, скорее всего, даже активно мешают фаззеру найти этот баг: генерация и выполнение большого байткода занимают время (в debug-сборках тесткейсу агента нужно несколько секунд, чтобы сработать), и при фаззинге это, вероятно, приводило бы к таймаутам.
Fuzzilli: баг Chrome 40076141 (ноябрь 2023)
Этот баг — хороший пример типа багов, которые, скорее всего, трудно найти, просто читая исходный код (или одну его часть). Изначально его нашёл Fuzzilli, и ни один из экспериментов второй части его заново не нашёл.
Предыстория: представление значений в V8
Рассмотрим такой фрагмент JavaScript:
let i = 42;
let f = 13.37;
let s = "foobar"
i = s;
Здесь создаются несколько переменных со значениями разных типов. Заметьте, что тип переменной нигде не объявляется и за время жизни переменная может хранить значения разных типов (в i сначала лежит целое число, потом строка). JavaScript — язык с динамической типизацией, и у переменных (а также полей объектов и т. д.) нет фиксированного типа. Но у самих значений во время выполнения тип всё равно есть: движку нужно как-то знать, что foobar — строка и что к ней поэтому применимы определённые операции (например, поиск подстроки). Концептуально этого можно добиться, представляя значения во время выполнения структурой вроде такой:
enum JSType {
    JS_TYPE_INT,
    JS_TYPE_FLOAT,
    JS_TYPE_STRING,
    ...
};
struct JSValue {
    JSType type;
    // Either the raw value or a pointer to another object, e.g a JSString.
    uintptr_t value;
};
Однако это довольно неэффективно: чтобы представить простое 4-байтное целое, теперь нужно байт 16. Поэтому современные JS-движки используют хитрые схемы тегирования, которые кодируют информацию о типе в неиспользуемых битах указателя. В V8 тип JSValue — это тегированный указатель (tagged pointer, или коротко tagged), который хранит один бит информации о типе в младшем бите:
Если бит равен единице, то значение минус 1 — указатель на другой объект. Это работает, потому что объекты выровнены и не могут начинаться с нечётного адреса.
Если бит равен нулю, следующие 31 бит содержат само целое число (его называют small integer, Smi).
Поэтому, чтобы узнать тип значения во время выполнения, движок сначала смотрит на младший бит. Если он нулевой, значение можно «растегировать» и получить целое число сдвигом вправо на один бит. Если же бит единичный, значение — корректный указатель на объект, в котором хранится дальнейшая информация о типе. Подробнее о схеме тегирования указателей в V8 можно прочитать в этом посте.
Тесткейс
Начнём с тесткейса, который сгенерировал фаззер. Он не слишком длинный:
function f0() {
    let v2 = 1;
    for (let i3 = v2; i3 >= v2; i3 += v2) {
        v2 = v2 && i3;
    }
}
f0();
Баг возникает при оптимизации цикла компилятором Maglev, а точнее из-за конфликта двух стадий конвейера компилятора: начального построителя графа (graph builder) и более поздней стадии MaglevPhiRepresentationSelector.
Построитель графа
Построитель графа строит начальное промежуточное представление (IR) кода в Maglev. Для этого он использует и входной код (в виде байткода V8), и обратную связь времени выполнения, собранную, пока код выполнялся на нижних уровнях, например в интерпретаторе. При обработке цикла из этого тесткейса происходит следующее:
И
i3, иv2меняются в цикле. Поскольку IR построено в форме статического единственного присваивания (SSA), они превращаются в Phi-узлы, благодаря которым код выглядит так, будто каждой переменной значение присваивается только один раз :)Для сравнения
i3 >= v2обратная связь времени выполнения сообщает, чтоi3до сих пор всегда был Smi, и компилятор предполагает, что так будет и дальше. Это предположение он страхует, вставляяCheckedSmiUntag: этот узел извлекает сырое целое из тегированного значения и откатывается в интерпретатор, если на вход когда-нибудь придёт не Smi.Для последующих операций над
v2компилятор может опереться на уже имеющуюся проверку и вставить узлыUnsafeSmiUntag. Они обходятся без проверок во время выполнения, но безопасны, только если на входе гарантированно Smi.
Получившийся код цикла выглядит примерно так (в псевдокоде Maglev):
loop:
  i3 <- Phi(1, i3_next)                   // loop variable, tagged
  v2 <- Phi(1, v2_next)                   // loop variable, tagged
  i3_int <- CheckedSmiUntag(i3)           // deopt if i3 is not a Smi
  v2_int <- CheckedSmiUntag(v2)           // deopt if v2 is not a Smi
  if i3_int < v2_int: break
  v2_next <- Phi(i3, v2)                  // result of `v2 && i3`: "known Smi"
  v2_next_int <- UnsafeSmiUntag(v2_next)  // no (re-)check needed
  i3_next_int = i3_int + v2_next_int
  i3_next <- Int32ToNumber(i3_next_int)   // tag the int32 result for the phi
MaglevPhiRepresentationSelector
Задача этого оптимизатора — найти Phi-узлы, у которых все входы имеют одно и то же сырое представление (например, int32), и перевести такой Phi в это представление, чтобы избавиться от последующих растегирований. В коде выше оптимизатор видит, что оба входа i3 — int32, и решает перевести Phi в представление int32. Последующие операции CheckedSmiUntag становятся пустыми и удаляются, а потребителям, которым нужно тегированное значение, теперь требуется шаг преобразования. В итоге код выглядит так:
loop:
  i3 <- Phi(1, i3_next)                   // all inputs int32, so i3 becomes a raw int32
  v2 <- Phi(1, v2_next)                   // stays tagged
  v2_int <- CheckedSmiUntag(v2)
  if i3 < v2_int: break                   // CheckedSmiUntag(i3) removed as a no-op
  i3_tagged = Int32ToNumber(i3)           // HeapNumber if i3 >= 2^30!
  v2_next <- Phi(i3_tagged, v2)           // stays tagged, needs tagged inputs
  v2_next_int <- UnsafeSmiUntag(v2_next)  // HeapNumber pointer treated as a Smi
  i3_next <- i3 + v2_next_int             // tagging no longer needed here
Конфликт
Баг возникает потому, что две оптимизации плохо уживаются друг с другом:
Построитель графа использует
UnsafeSmiUntag, поскольку считает, что в этой точке значение обязано быть Smi.Селектор представлений удаляет
CheckedSmiUntag, поскольку считает, что эта проверка больше не нужна.
В какой-то момент i3 становится больше максимального значения Smi. Тогда Int32ToNumber уже не может уместить число в Smi и вместо этого выделяет объект HeapNumber (по сути, контейнер для числа побольше). Но после этого UnsafeSmiUntag перестаёт быть безопасным, ведь на входе теперь указатель. Из него извлекается испорченное значение указателя, что затем приводит к повреждению памяти. Заметьте, что в исходном коде такого произойти не могло: HeapNumber отсеял бы CheckedSmiUntag(i3).
Найти этот баг BigSleep было, возможно, трудно потому, что обе оптимизации по отдельности корректны. Глядя только на одну из них, заметить проблему сложно. Агенту пришлось бы как-то выдвинуть гипотезу о второй оптимизации или случайно (либо полным перебором) наткнуться на нужный код.
Обзор
По примерам выше и по другим багам, найденным LLM, видно несколько явных категорий, где у LLM есть преимущество:
Баги, для срабатывания которых нужна сложная логика, но которые можно найти последовательными логическими рассуждениями и экспериментами с целевой программой, как разобранный выше crbug.com/449760249. Вероятно, это самое сильное преимущество.
Баги, для которых нужны особые «магические» значения (граничные целые числа, определённые строки и т. п.), как разобранный выше crbug.com/443765373.
Баги, для которых нужны новые (или редкие) возможности языка, о которых фаззер может не знать. Примеры: crbug.com/436181695, где фаззер ещё не поддерживал новый синтаксис
await using, и, собственно, тот же crbug.com/449760249: в то время Fuzzilli не поддерживал break с меткой.Баги, для которых нужна нестандартная обвязка, особые флаги или специальные вспомогательные инструменты и функции, использовать которые фаззер не настроен (например, crbug.com/516833326, для которого требовались
--expose-fast-apiи APId8.test.FastCAPI).
С другой стороны, вот преимущества, которые (пока) есть у фаззеров:
Они неплохо находят «нелокальные» баги, если для срабатывания нужно не слишком много отдельных составляющих. Пример такого бага — разобранный выше crbug.com/40076141.
Они находят баги, которые трудно заметить, рассуждая только об исходном коде. Явный пример — баги из-за (некорректных) оптимизаций компилятора C++, как crbug.com/500771385. Ещё один возможный пример — баги вроде crbug.com/414840455, связанные с обработкой мёртвого кода в компиляторах V8. Это, вероятно, необычное состояние, и рассуждать о нём может быть трудно. В наших экспериментах BigSleep пропустил несколько таких багов.
Они не подвержены некоторым искажениям, которые влияют на агентные подходы: выбору отправной точки (например, коммитов), точной формулировке промпта, типам багов, которые встречались (и не встречались) при обучении. Впрочем, у них есть свои искажения (например, веса отдельных мутаторов и генераторов).
Их не отвлекают «поверхностные» баги. BigSleep же пропустил несколько багов, потому что вместо них нашёл более простые. Впрочем, это, вероятно, отчасти исправляется само: поверхностные баги со временем исправят, и у агента появится ещё один шанс найти более глубокий.
Вероятно, есть и категория багов, которые трудно найти обоими подходами: очень нелокальные (плохо для агента) и требующие сложных тесткейсов (плохо для фаззера). В этом случае фаззер, вероятно, найдёт отдельные части тесткейса (благодаря обратной связи по покрытию), но не сможет подобрать правильную комбинацию, чтобы вызвать баг (как в нашем первом примере). Агенту, который ревьюит код, может мешать огромное пространство поиска фрагментов кода, которые способны плохо взаимодействовать между собой (как в нашем последнем примере). Но это лишь гипотеза, и для её проверки нужны дополнительные эксперименты и данные.
Часть 4. Заключение
В этом посте мы сравнили фаззеры с обратной связью по покрытию и агентов для поиска уязвимостей, которые читают исходный код и рассуждают о нём. Конкретно мы рассмотрели Fuzzilli и BigSleep: обе системы работают на V8 как автоматические конвейеры и ищут свежевнесённые баги. По данным этих конвейеров, за последние 6 месяцев обе нашли примерно поровну уязвимостей (около 40 каждая), а пересечение найденных багов умеренное, около 25%. Однако в отдельном эксперименте пересечение оказалось ближе к 60%. Пока это означает, что два подхода остаются взаимодополняющими, а специализированный фаззинг по-прежнему приносит пользу: быстро находит баги и выявляет определённые виды проблем, которые иначе трудно заметить. В то же время LLM вообще научились находить баги в ПО вроде V8 совсем недавно и с тех пор сильно продвинулись. Модель из нашего эксперимента уже устарела, и новые поколения её превосходят. В будущем мы ожидаем, что улучшение моделей, возможно, вместе с более удачными промптами и более гибкой обвязкой (которая, например, позволит модели помимо чистого аудита кода самой собирать, дорабатывать и запускать фаззеры) приведёт к тому, что всё большую долю багов будут находить агентные системы.


Для участия в Чате вам необходим бесплатный аккаунт pro-blockchain.com
Войти
Регистрация
Похожие новости
Подпишись на telegram канал и узнавай первым обо всех новостях