 Русский
 English
Cryptocurrencies:
8050 /
Markets: 109742
Market Cap: $ 2 574 141 211 877 /
24h Vol: $ 65 803 142 436 /
BTC
Dominance: 59.890711501557%
Новости
Озвучил всю GTA V по‑русски нейросетью: как сгенерировать 220 часов речи и не привлечь внимание санитаров
Всем привет! Началось всё с ролика про нейро‑GTA V: к прохожим в игре подключают нейросеть, и с ними можно разговаривать и взаимодействовать. Идея устроить приключение со случайным бомжом мне очень понравилась, и я полез искать русскую нейроозвучку: чтобы сразу было аутентично, хотелось снова пройти игру, слушая диалоги, а не читая субтитры на ходу, как при первом прохождении. Тем более как прикрутить говорящую на русском нейронку я уже представлял.
Но нашлась только неполная версия, довольно кривая и почти одноголосая. Я прикинул объём и цену генерации, посчитал, не поверил, пересчитал ещё два раза и решил: почему бы и не попробовать. Сделал тестовый ролик, спросил в канале, стоит ли браться. А тут ещё GTA VI назначена на 19 ноября 2026, и на этой волне многие захотят перепройти пятую часть. Короче, взялся.
Меня зовут Илья, я блогер, основатель ArtGeneration.me и просто фанат нейросетей. Не разработчик в классическом смысле, скорее продакт с 20-летним стажем, поэтому код здесь писал мой инструмент, Claude Code, а я ставил задачи и проверял.
В статье расскажу, как Rockstar хранит звук и как узнать, кто и что говорит в каждом из 260 тысяч файлов. Какими моделями я распознавал речь, делил голоса на мужские и женские и синтезировал русский. Как уложить его в катсцены, почему игра падала, как вернуть всё модом и во что это обошлось.
Дисклаймер, чтобы не спорить в комментариях. Нейроозвучка ни в коем случае не лучше оригинала и настоящей студии. С актёрами нейросети соперничать не могут, поэтому я даже не пытался. Основной вариант здесь — закадр: русский голос поверх приглушённого оригинала, когда актёров Rockstar слышно.
Что получилось в итоге:
250 364 русские реплики: сюжет, катсцены, прохожие, радио, реклама, новости, рация, объявления, телевизор, дополнения. Всего синтезировано почти 219 часов речи, считая переделки
два варианта на выбор, закадр и дубляж
около 60 долларов за синтез (агенты Claude в рамках подписки), десять дней работы, из них почти неделю на компьютере крутились модели распознавания речи
потом я сам прошёл всю сюжетку с этой озвучкой, около 30 часов и с большим удовольствием. Ради этого всё и затевалось
Вот как закадр звучит в игре:
Если уже хочется, поставить озвучку сюжета можно с PlayGround, подробнее про установку ближе к концу.
❯ Сколько вообще говорят в GTA V
С этого вопроса начинается смета, и ответа на него в интернете нет. Есть доклад Rockstar на GDC 2014 про почти 160 тысяч реплик, есть фанатская карта на Nexus на 156 тысяч клипов. А мне нужны часы, потому что синтез стоит примерно по длине звука, и часов нет нигде.
Пришлось считать самому. Здесь пригодился CodeWalker, открытый инструмент моддеров GTA V, просмотрщик мира и файлов игры, который умеет открывать её архивы. Исходники лежат на GitHub, а готовая сборка с поддержкой Enhanced есть только в Discord автора, поэтому я взял исходники. Его ядро подключается как библиотека, и Claude Code написал поверх него небольшую программу на C#, которая проходит по всем архивам игры и записывает в таблицу, что лежит в каждом звуковом контейнере. Распознавать для этого ничего не надо, в заголовке каждого звукового потока (поток — это одна реплика или один кусок звука) записано, сколько в нём отсчётов и сколько их идёт в секунду, остаётся поделить. Вышло больше 260 тысяч потоков. Для игры 2013 года неплохо.
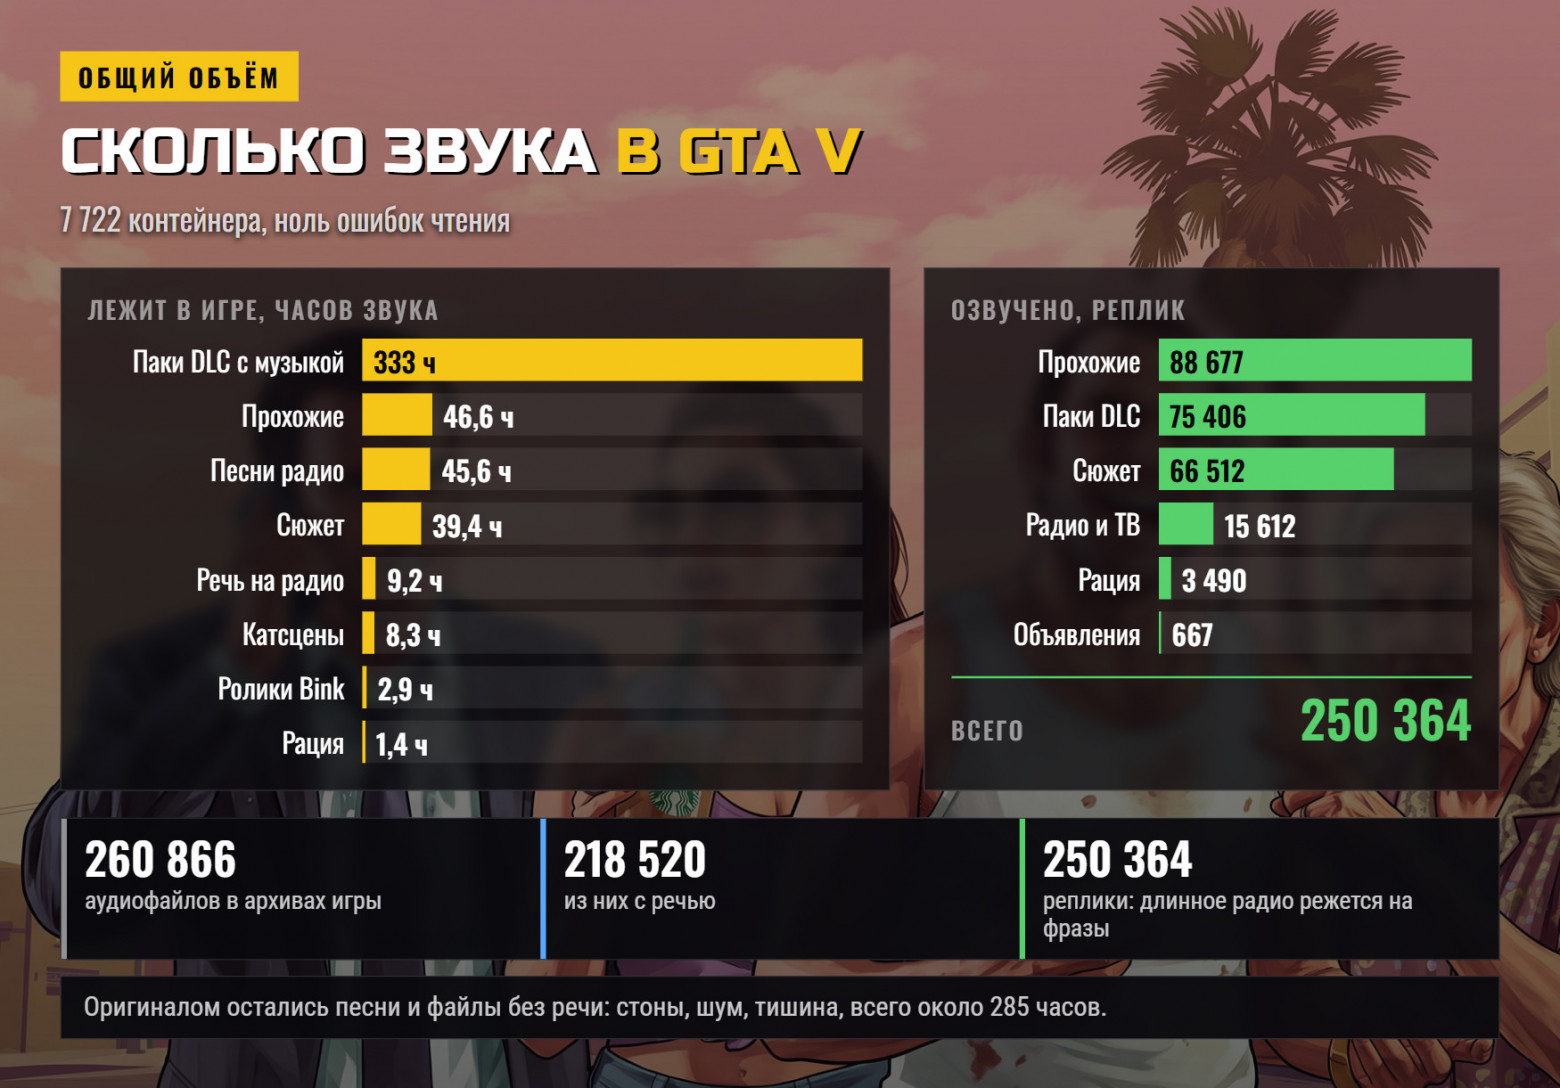
Сюжет плюс прохожие дают 150 тысяч реплик, это сходится с докладом Rockstar. Верхняя строчка выглядит как ошибка, но нет, и она ещё аукнется.
Хорошая новость: в игре лежат официальные русские субтитры с теми же ключами, что и английские. И перевод там нормальный, сленг и мат на месте, никто ничего не приглаживал. Плохая: субтитры есть не на всё. У прохожих, радио и рации их нет вообще, да и в сюжете около 11 тысяч реплик без них: разговоры с друзьями, такси, оружейный магазин. Там текст пришлось сначала распознавать, а потом переводить.
С голосовым движком я определился не сразу. Пробовал и другие, у меня есть целая Speech Studio, куда встроены лучшие из них. Но беда в ресурсах: даже на самой быстрой модели генерировать такой объём у себя на компьютере пришлось бы неделями, и лучше бы от этого не стало.
Конечно же, я попробовал и движки с клонированием голоса. Результат удручающий, причём не в том смысле, что не похоже. Как раз похоже. Плохо с актёрской игрой. Даже лучшие модели с эмоциями вроде Fish Audio Drama 3 то начинали актёрить невпопад, то делали задумчивые паузы в неуместных местах. В итоге я решил не бороться и выбрал просто хорошую TTS‑модель, которая не пытается подражать реальной актёрской игре и перекрывать её.
Это Gemini 3.8 Flash‑Lite TTS в пакетном режиме Google, около 27 центов за час готовой речи. С таким тарифом смета вышла смешная: 45–60 долларов с запасом на переделки. Перевести всю игру дешевле, чем купить копию самой игры. С 1 января 2027 Google поднимает этот тариф вдвое, примерно до 54 центов за час, так что такие штуки выгоднее делать до конца года.
❯ Как Rockstar хранит звук
Звук в игре лежит в файлах AWC: это собственный формат Rockstar, контейнер, внутри которого хранятся звуковые потоки. Документции на всё это нет. Вики GTAMods версию AWC из GTA V не описывает, остальное разбросано по исходникам vgmstream и CodeWalker и закрытым форумам. Поэтому разбирался по файлам, и одна реплика выглядит как матрёшка.
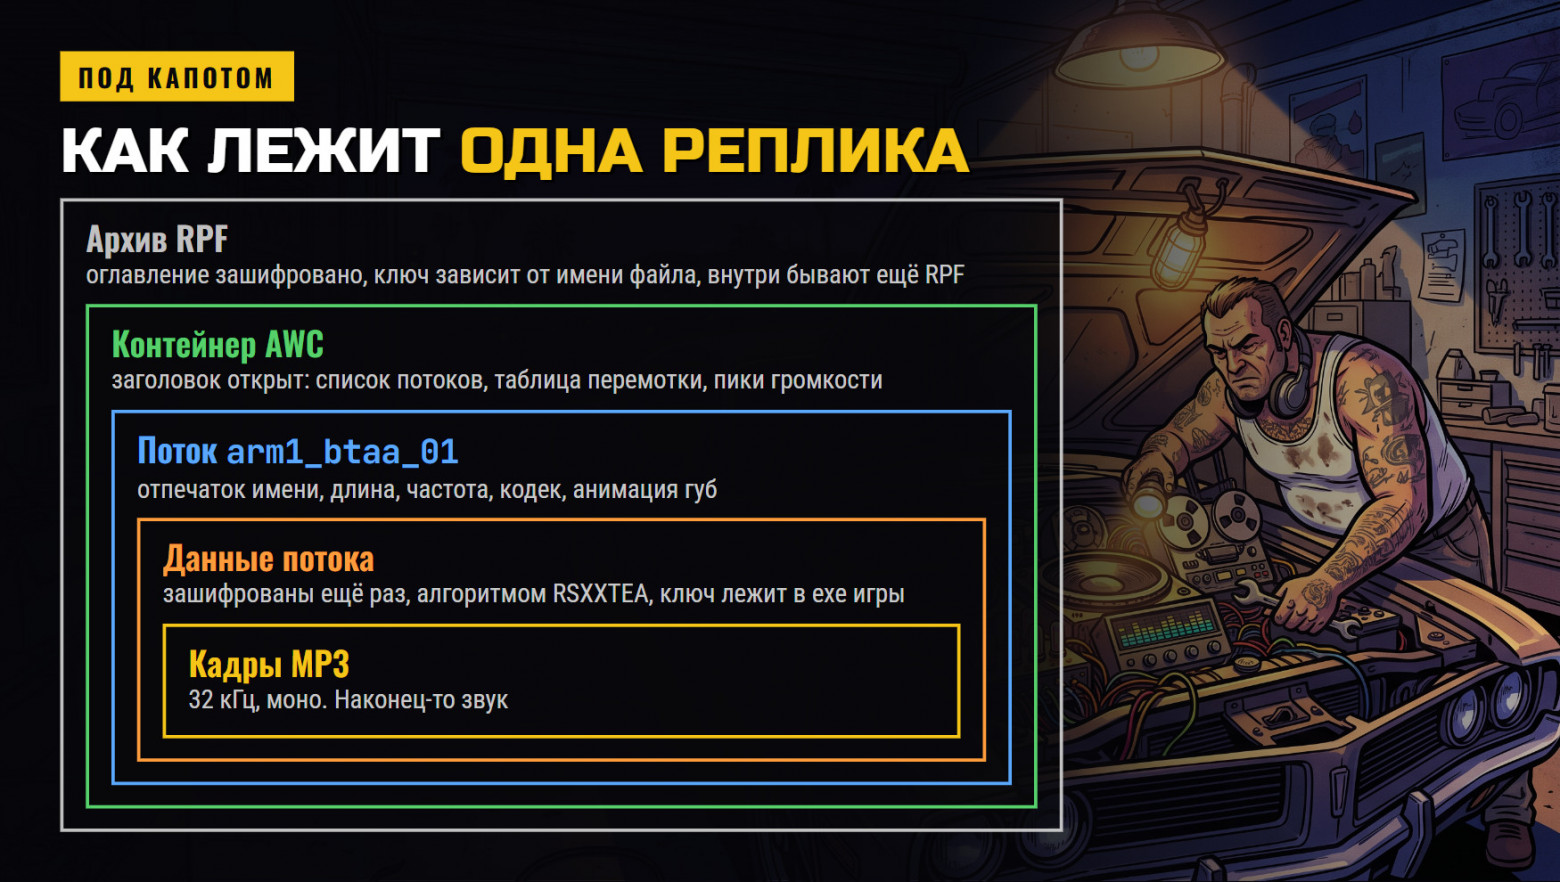
С архивами RPF помог CodeWalker. Таблицы для расшифровки оглавления лежат прямо в GTA5_Enhanced.exe, и он умеет их оттуда доставать. Основное лежит в x64\audio\sfx, там 57 архивов‑банков, паки обновлений отдельно, в update\x64\dlcpacks. Раз ключ привязан к имени, переименованная копия архива уже не читается. Рядом лежит кэш оглавлений rpf.cache на 16 МБ, из‑за которого подменить архив так легко не выйдет.
Заголвок у AWC, к счастью, открыт. Кодек на схеме — это способ сжатия звука. Анимация губ рядом со звуком стала сюрпризом, она ещё пригодится.
Со вторым слоем шифрования пришлось повозиться. О нём говорит один флаг в заголовке, а CodeWalker смотрит не на тот и на файлах Enhanced падает. Правильный флаг нашёлся в исходниках декодера vgmstream, который сам такие файлы при этом не открывает. Рабочий порядок я подсомтрел в открытом проекте gta5_voice: расшфировать данные прямо на месте, погасить флаг и только потом декодировать.
В старой версии игры речь лежала в ADPCM, это простой старый кодек, который сжимает слабо, а в Enhanced она в MP3. Запишешь ADPCM — архивы заметно вырастут, у меня выходило вдвое. А писать MP3 в AWC CodeWalker не умеет. Запомнтие этот момент, он ещё вернётся вылетами.
И каждая часть игры устроена по‑своему:
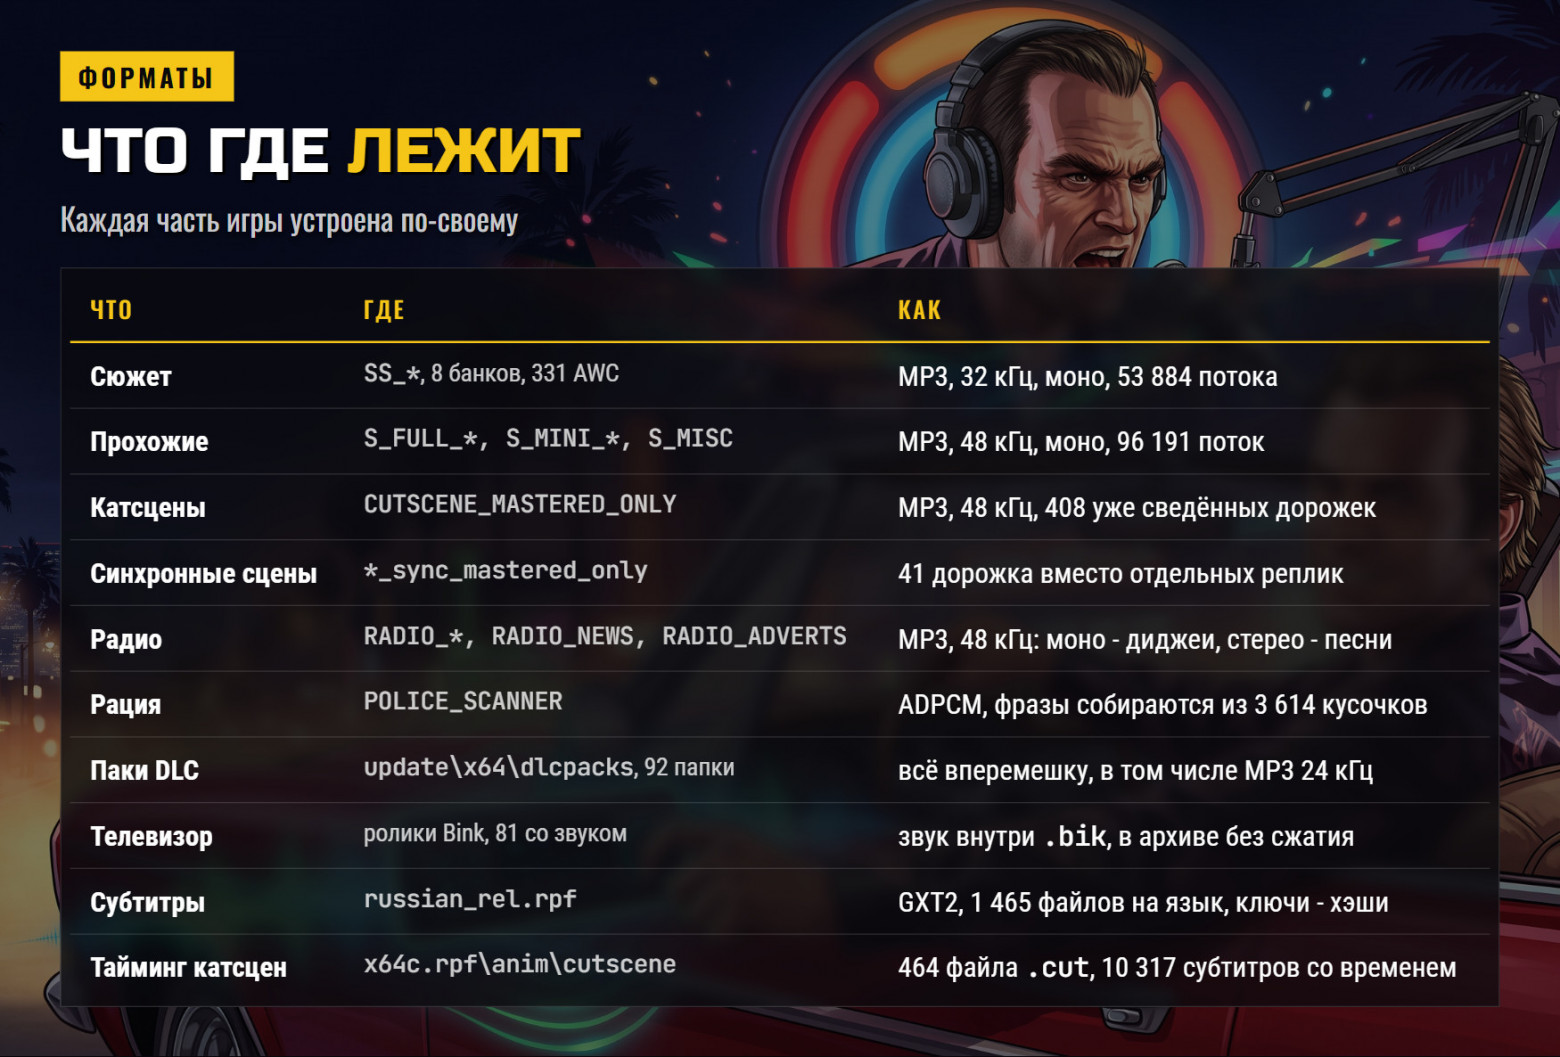
Пока всё это разбирал, нашлось несколько вещей, которые потом определили весь звук.
Канал голоса в катсцене — это не голос. В нём вместе с речью записаны двери и выстрелы, поэтому заменить его целиком нельзя, пропадёт звук сцены. Боковые каналы бывают копиями голоса, а бывают музыкой и эффектами.
Реплики с флагом «по телефону» лежат в файлах чистыми, эффект накладывает сам движок. А вот у части реплик без всякого флага рация и мегафон вшиты в файл. Рация срезает низкие и высокие частоты, поэтому у каждого оригинала надо мерить, что в нём осталось, и повторять это на русском.
В данных диалога есть поле громкости, но файл оно не меняет, это указание движку. Пик у всех реплик почти одинаковый, а средняя громкость сильно гуляет. Поэтому каждую русскую реплику я подгоняю под громкость её оригинала, чтобы шёпот звучал шёпотом, а крик криком.
У части реплик из паков частота в заголовке не совпадает с частотой кадров MP3. Игра верит заголовку. Поверишь кадрам — речь выйдет на треть быстрее нормы, а наркобарон Эль Рубио из GTA Online запищит на 400 Гц.
❯ Как понять, кто и что говорит
Мало достать звук. Надо ещё связать каждый поток с субтитром и говорящим, а нигде в игре не написано «файл arm1_btaa_01 — это Ламар и вот такая фраза».
Из декомпилированных скриптов я вытащил обработчик диалогов и разобарл схему. Миссия вызывает разговор по корню, то есть по его названию, например LM2_TAKE. От корня строятся ключи: LM2_TAKE_1 — субтитр первой строки, LM2_TAKE_1A — её аудиофайл.
Условный пример на русском. Пусть разговор называется УГОН, это корень. Субтитр первой реплики лежит под ключом УГОН_1, а имя её звукового файла под ключом УГОН_1А. У второй реплики будут УГОН_2 и УГОН_2А, и так до конца разговора. Зная одно название, можно пройти по всем его строкам и получить пары: вот текст, вот файл со звуком.
Осталось найти все корни. Поиск строк в коде миссий покрыл 62% потоков и упёрся: часть корней скрипты собирают на лету.
А дальше вот что мне понравилось больше всгео. Ключ в файле субтитров — это не имя, а его отпечаток, хэш: короткое число, которое считается из текста по формуле, а обратно имя из него просто так не получить. Формула здесь называется joaat (Jenkins one‑at‑a-time), движок Rockstar использует её повсюду. Самого имени у меня нет. Но joaat считает отпечаток по одной букве, а в конце делает финальное перемешивание, которое можно открутить назад. Берём отпечаток субтитра, откручиваем финал, досчитываем одну букву A, снова перемешиваем и получаем отпечаток аудиофайла той же строки. Имя знать не нужно, ну красиво же. Например, LM2_TAKE_1 даёт 99A52B58, и из одного этого числа получается 30D659F0, то есть LM2_TAKE_1A. Так связалось 75% сюжетных потоков.
С говорящим вышло ещё изящнее. Номера в сценариях не сквозные. Возьмём «Франклин и Ламар», первую миссию после пролога: герои работают на автосалон Симеона, забирают у должника две неоплаченные машины, гоняются на них по городу и уходят от полиции. В файлах игры она называется Armenian 1, и под нулём в ней не Майкл, а Франклин. Зато в каждом речевом потоке лежит та самая анимация губ, а внутри неё путь вида …/SCRIPTED_SPEECH/<банк>/<ПЕРСОНАЖ>/…/<метка>.clip. Игра сама подписывает, чьи это губы. Так нашёлся говорящий почти у всех сюжетных потоков, кроме одного.
В катсценах такого подарка нет. Там говорящих я брал из расшифровок на вики и сверял по голосу моделью WeSpeaker с репликами известных персонажей.
❯ Как вернуть звук в игру и почему это мод
Главный риск проекта был здесь: получится ли вообще засунуть звук обратно. Вариантов три.
Можно править архивы игры напрямую. Самый простой на вид способ, и Enhanced его не принимает: ERR_STR_MISSING - Corrupt game data. Вернул оригиналы из копий и больше туда не ходил.
Можно раздавать готовые архивы Rockstar. Выходит 10 ГБ чужих файлов, а этого я не хочу ни по весу, ни по совести.
И можно положить рядом с игрой папку mods, повторяющую её пути, например mods\x64\audio\sfx\SS_NP.rpf, а загрузчик будет подсовывать игре эти файлы вместо оригиналов. Оригиналы не трогаются, обновления игры и проверка файлов мод не ломают, удалить его можно одной папкой. Загрузчик — RageOpenV с открытым кодом плюс Ultimate ASI Loader. OpenIV официально Enhanced не поддерживает, а OpenRPF закрытый и на моей версии игры проверен не был. RageOpenV обходит и тот самый rpf.cache.
Архив в mods собирается так: берётся архив игры, и в нём меняются только нужные контейнеры AWC со звуком, остальное остаётся байт в байт. Поэтому установщику достаточно нести один новый звук, а архивы он соберёт на компьютере у игрока из его же файлов. Чужие файлы я не раздаю.
Для этого Claude Code написал утилиту gta‑patch поверх CodeWalker: она берёт контейнер игры и заменяет в нём потоки русским звуком. Сначала она писала ADPCM, это быстрее всего показало, что подмена работает вообще. В итоге она пишет файл один в один как у Rockstar. Почему именно так, расскажу в главе про вылеты.
❯ Конвейер и модели: что взял и зачем
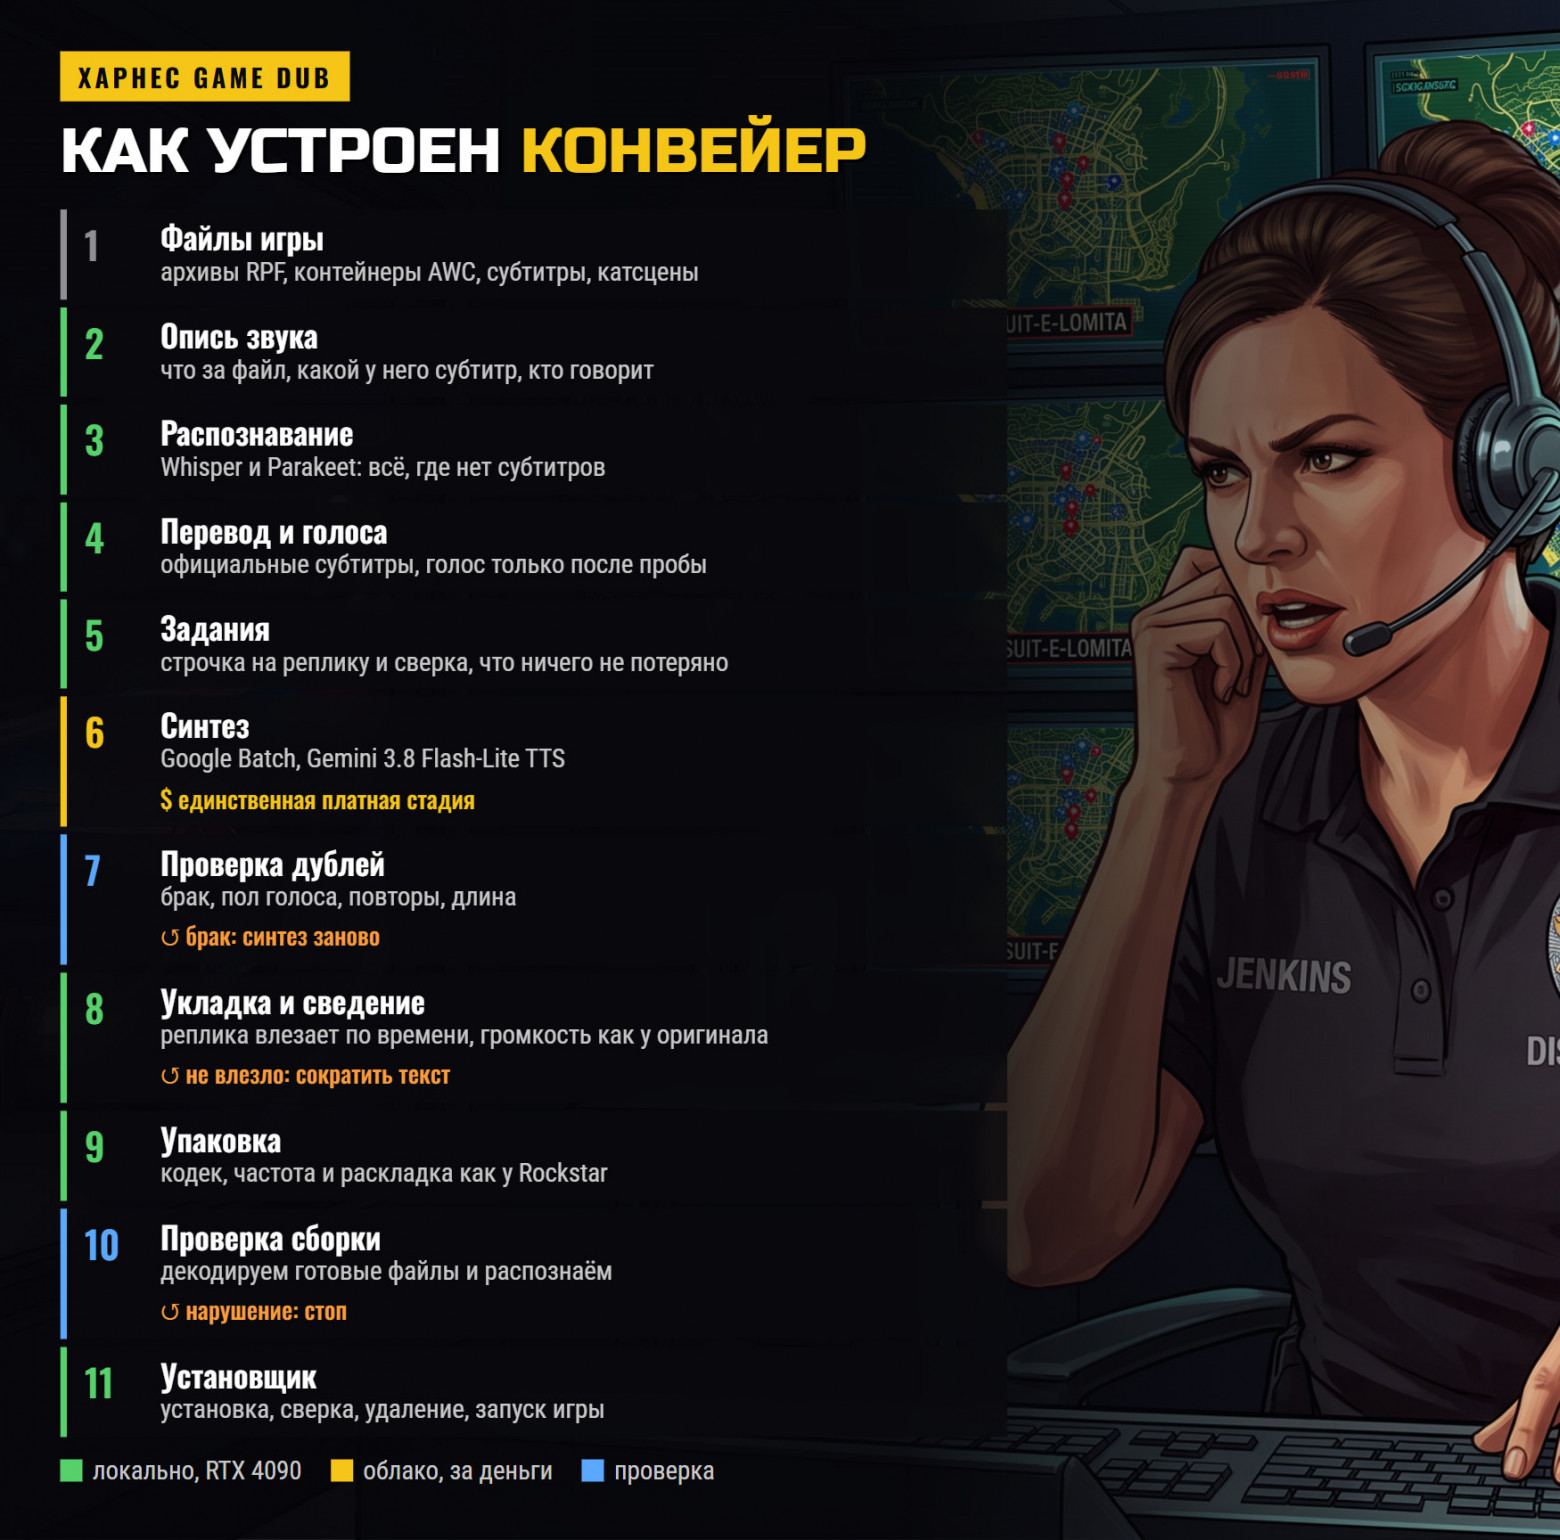
Правило одно: в облаке только синтез и агенты Claude, всё остальное локально на RTX 4090. Конвейер, он же харнес, то есть набор программ и правил, внутри которых работает агент, я назвал Game Dub, и выглядит он так:
Модели я выбирал реальными пробами:
Задача | Модель | Почему она | Где подводит |
|---|---|---|---|
Синтез | Gemini 3.8 Flash‑Lite TTS | на слух лучше Flash, Qwen, MAI, Grok, MiniMax, Fish и Seed, в пакетном режиме вдвое дешевле | в каталоге голосов врёт поле пола |
Распознавание | Whisper large‑v3 | локально, таймкоды слов, держит длинную речь | выдумывает слова на тишине |
Второе мнение | около 5 дублей в секунду, слышит повторы, которые Whisper склеивает | молчит на коротких кусках | |
Отделение голоса | bs_roformer, модель voc_fv6 | 16 секунд звука за полсекунды | крики толпы считает голосом |
Пол голоса | 77 верных из 80 на известных говорящих | сначала я мерил высоту тона, а она брала гармонику и отправила Майкла в женщины | |
Кто говорит | WeSpeaker | сравнивает голос с репликами известных персонажей | ошибается целыми сценами, нужна проверка |
Распознавание, разделение голоса и проверка синтеза взяты из моей Dub Studio, её копия лежит прямо внутри проекта. Своё Claude Code писал там, где готового не нашлось. Одни программы сводят звук: вычитают английский голос, сжимают русский компрессором и выставляют громкость как у оригинала. Другая склеивает короткие реплики в куски до 27 секунд, потому что поодиночке Whisper их распознаёт плохо, а так пустых выходит почти вчетверо меньше. Ещё одна вырезает лишнее слово из готового дубля, чтобы не платить за новый синтез. А последняя сверяет, что ни один файл игры не потерялся.
Всё это на Rust, скриптах и C#, без Python: мои студии давно живут на этом стеке, и Python в сборках я больше не хочу.
На вход синтезу уходит вот такая строчка на реплику:
{"character":"LAMAR","key":"arm1_btaa_01","model":"gemini-3.8-flash-lite-tts","text":"Да, надо как следует вкалывать, чтобы гонять на такой тачке."}
Поля «голос» тут нет, он берётся из карточки персонажа, про это ниже.
Whisper нужен для всего, где нет субтитров. И узнал я про него много новго. На стонах и плаче он пишет чужие титры: «Субтитры сделал DimaTorzok». На радиомиксах зацикливается и выдаёт «A little pause... and we are back» поверх настоящей речи. А английскую речь корейских бандитов пишет хангылем: «커버미!» — это «Cover me!», если что.
Галлюцинации Whisper настолько типичные, что на них есть готовые списки: из работы университета AGH на конференции ICASSP 2025 и из NVIDIA NeMo. Я взял их и дописал выдумки этой игры.
Первый проход идёт вообще без нейросетей, это обычная эвристика: простой скрипт читает текст и помечает фразу, если она целиком есть в списке, если повторяется подряд или три раза и больше за один файл, если в ней от пяти слов, а разных среди них не больше 40%, и если в ней есть слово длиннее 25 букв. Пометка ещё не приговор. Помеченный кусок звука вырезается и уходит второй модели, Parakeet, у которой другое устройство. На один звук получается два текста, и их можно сравнить. Parakeet услышал хотя бы треть тех же слов — это речь. Не услышал ничего — выдумка, не озвучиваю. Услышал больше, чем Whisper — беру его текст. Просто удалять всё, что есть в списке, нельзя. «Thank you» — типичная выдумка Whisper, и в наборе реплик, где прохожий умирает, это скорее всего она. А в наборе, где прохожий кого‑то благодарит, это настоящая фраза. Поэтому решает не список, а вторая модель.
Перевод там, где субтитров нет, делает Claude Code, и вычитывать его приходится. «I'm cold» — это «я пас», а не «мне холодно», мат норовит смягчиться, женщины обращаются к игроку «ты врезалась», а крики написаны капсом, который модель озвучки читает по буквам. Параллельные агенты‑помощники справлялись хуже, поэтому в итоге переводил один агент, читая соседние реплики. Ещё фильтр Google отказывался озвучивать реплики, где рядом с сексом стоит слово «малышка»: он читает это как несовершеннолетних, хотя в GTA малышка — это машина.
Говорящих в игре больше тысячи. Никого не клонирую, беру из библиотеки Google, и у каждого персонажа голос один на всю игру. Сначала надо понять, мужчина говорит или женщина. Для этого реплики каждого говорящего слушает ECAPA‑TDNN, модель, которая по голосу выдаёт вероятность, что он женский. Для главных персонажей пол и возраст берутся с вики, это важнее модели.
Потом надо проверить сами голоса Google. В каталоге у них есть поле пола, но оно врёт: голос с пометкой «male» может звучать женским. Так что каждый голос сначала пробуется на трёх репликах, это копейки, и идёт в дело, только если две модели согласны с его полом. Я один раз отложил эту пробу на потом, и первый большой пакет выдал сотни дублей не того пола. После синтеза проверка повторяется: пол готового дубля сравнивается с полом персонажа, а несовпадения идут на разбор.
Дальше подача, то есть как именно произносить. Gemini умеет описание стиля («в ужасе, голос дрожит») и теги вроде <laugh>. Я проверил это на 120 клипах. Смех раздувал реплику вдвое, а «в ужасе» уводило мужской голос в фальцет. Мужик заговорил женщиной. Лучше стала примерно каждая пятая реплика, так что подачу я оставил пустой. Отсюда и дисклаймер в начале.
Сам синтез шёл через Batch, пакетный режим Google: отдаёшь реплики пачкой, ответ приходит не сразу, зато вдвое дешевле. У него есть лимит очереди, примерно 7 тысяч реплик на модель одновременно, так что сюжет приходится подавать порциями. А ещё при сбое связи SDK сам повторял создание пакета, а для Google каждый повтор — новый пакет, то есть при плохом VPN можно было оплатить весь сюжет дважды. Автоповторы я выключил.
Брак синтеза редкий, но красивый: реплика «Кто это?» длиной 210 секунд. Его ловит свой детектор, и нейросетей в нём тоже нет, только математика над звуком. Длину он сравнивает с текстом: больше 0,4 секунды на символ значит, что дубль убежал, меньше 0,045 — что оборвался. По слогам текста и обычному темпу этого голоса он считает, сколько реплика должна звучать, и если вышло в 1,3 раза дольше, там может быть повтор. Сам повтор ищется сравнением звука с самим собой: одна и та же фраза, сказанная дважды, видна как полоса на карте похожести. Перегруз — это сигнал в потолке несколько значений подряд, свист — резкий пик в спектре на длинной реплике. Ещё он смотрит шум в паузах и слишком длинные паузы внутри фразы. Весь сюжет детектор проходит за 4 секунды.
Подозрительные дубли распознаются обратно обеими моделями: Whisper склеивает повторы, Parakeet их слышит, и если лишнее слово услышала любая из двух, реплика уходит на новый синтез.
❯ Катсцены и ночь щелчков
Моя любимая история проекта. Ну как любимая. Вспоминаю с дрожью. Чтобы сделать дубляж катсцены, английский голос надо убрать, а двери и выстрелы оставить. Работает это так:
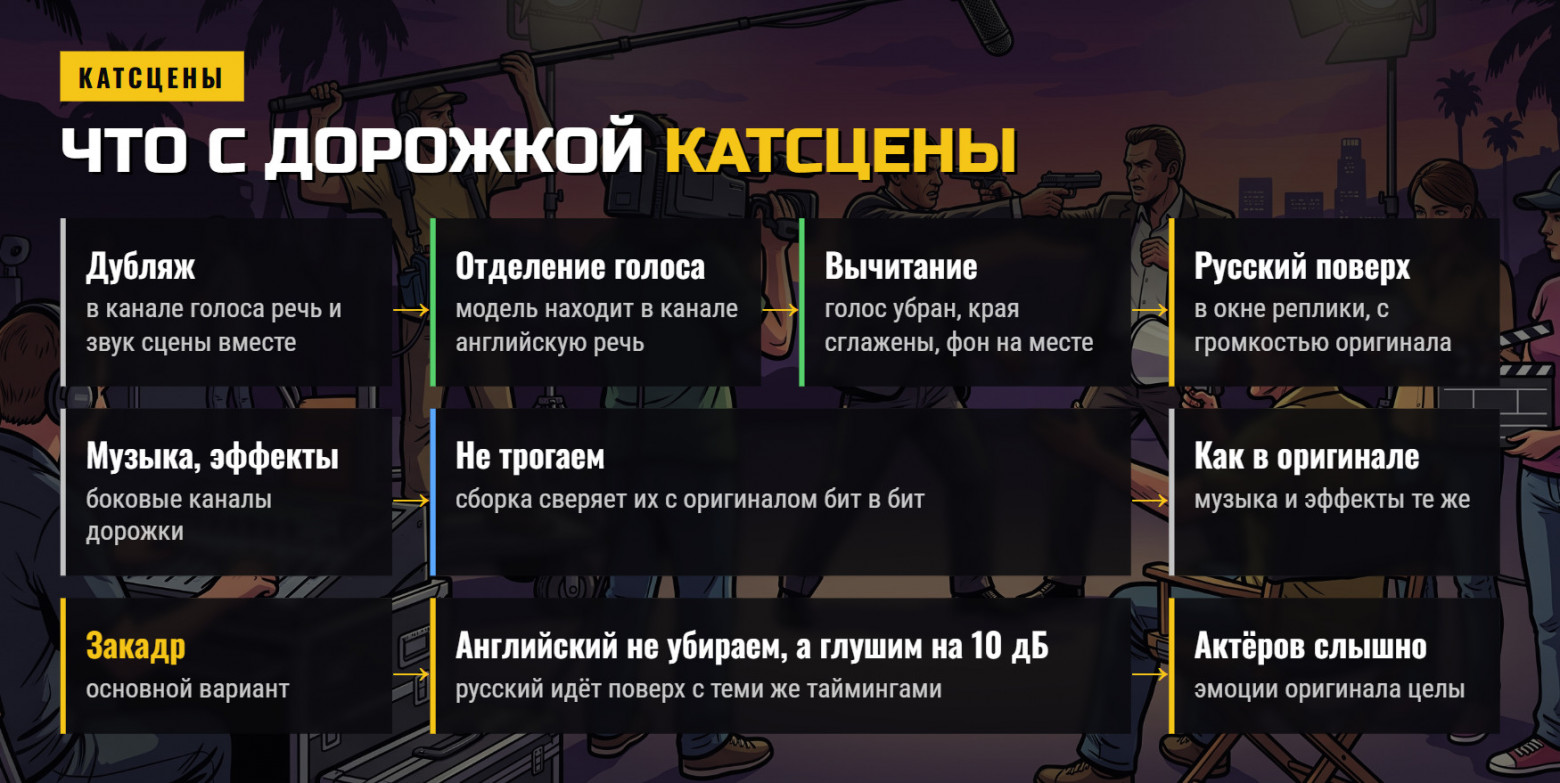
Но до этой схемы надо было дожить. Отделение голоса по всем каналам убирало фон, а только в окнах реплик давало щелчки на краях фраз. К утру в списке было десять вариантов сведения, и почти в каждом мне что‑то щёлкало. На краях фраз находились всплески, на этом строились гипотезы. Потом ту же мерку я проверил в случайных местах дорожки, и там всплесков оказалось почти столько же. То есть мерка ловила обычный фон.
Причина нашлась утром и была совсем не в катсценах. Я наконец сдедал то, что надо было сделать первым: достал из mods собранный архив с репликами пролога, декодировал и сравнил с исходными файлами. Всё совпало, кроме самого хвоста каждой реплики, последних 40–180 сэмплов (сэмпл — это одно значение звуковой волны, их десятки тысяч в секунду). Там сигнал бил в потолок, громче записать уже нельзя.
Кодер ADPCM в CodeWalker выделял буфер без учёта 4-байтовых заголовков блоков. Хвост реплики не кодировался, а в заголовке стояло полное число сэмплов, и игра честно доигрывала конец чужими байтами из соседних кусков архива. Семь миллисекунд мусора на полной громкости в конце каждой русской реплики. Все мои «щёлкает» той ночи были на фоне этих хвостов.
С тех пор два правила: проверять надо готовый файл, который играет игра, а любую мерку сначала прогонять на случайных местах.
Отдельно пришлось повозиться с громкостью. Пролог зазвучал по‑руски, и первая жалоба была простая: они там орут, а у тебя шёпот. Самодельная мера показывала разницу в 0,3 дБ, а по EBU R128, стандарту с телевидения, который меряет громкость так, как её слышит человек, русский был заметно тише: оригиналы Rockstar плотно сжаты по громкости, а синтез говорит спокойно. Теперь на реплике стоит компрессор, громкость подгоняется под оригинал с небольшим запасом вверх, и сборка сама проверяет это по каждой реплике.
Закадр я сначала хотел как опцию, а он стал главным вариантом. Английский приглушён так, как обычно делают русские студии закадра: актёров слышно, а русский разбирается без труда. Я послушал и написал: закадр очень хороший. С тех пор он рекомендуемый. Закадр и дубляж на одних и тех же моментах:
Для раций и громкоговорителей частоты и эхо подгоняются под оригинал каждой фразы. Без этого русский голос звучит чисто, будто человек стоит рядом, хотя он говорит через рацию.
❯ Укладка: как уместить русский текст в английское время
Русский текст заметно длиннее английского. Прохожим на это плевать: их реплика звучит сама по себе, ни к какой сцене не привязана, и игра просто доигрывает файл до конца. А в катсцене всё идёт по времени, и реплика обязана уложиться в окно до начала следующей. После синтеза сюжета не влезала примерно треть реплик катсцен.
Поэтому сборка проверяет каждую реплику и не собирается, если та наезжает на следующую. Исключение одно: 8 реплик, которые и в оригинале звучат внахлёст, вроде перебивок в ток‑шоу.
Сначала срезается тишина по краям, потом идёт ускорение, но не больше 1,15 раза, а если не влезло, текст переписывается короче и делается новый дубль. Сокращать тоже надо уметь. Сначала я пробовал просто обрезать слова, и мне это не понравилось: фраза становится рваной, больше так делать не буду. На радио Claude Code предложил такое: «Не унывайте только из‑за того, что стареете» стало «Не грустите, что стареете». Так портятся юмор и смысл, лучше ускорить. Поэтому для радио предел ускорения стал 2,0, ведущие и в оригинале тараторят. Короткие выкрики ускоряются сильнее, потому что Gemini короче их не произносит.
Последней здалась реплика «Ни Тезис, ни Антитезис» из побочки про секту. Стала «Ни теза, ни антитеза» и уложилась с восемнадцатой версии.
❯ Вылеты: слоты памяти и таблица перемотки
Пока я проверял пролог, всё работало. А потом собрал всю игру целиком, поставил, сел играть, и игра начала вылетать. В логах Windows и загрузчика модов ничего полезного не нашлось, так что причины я искал по одной. Общее у них одно: мои файлы по устройству отличались от файлов Rockstar, а игра рассчитана ровно на её файлы.
Первая причина — размер. Под некоторые звуки, например фразы полицейской рации, игра заранее выделяет кусок памяти фиксированного размера, слот. Оригинальные фразы в него влезают, а мои были в 48 кГц и получались больше слота в два с половиной раза. Перекодирвоал в 16 кГц, как у Rockstar, и они влезли.
Вторая — формат. Тут и вернулся MP3, который CodeWalker не пишет. У Rockstar реплики диджеев на радио в MP3, а у меня были в ADPCM, и он вдвое тяжелее. Claude Code разобрал формат Rockstar и научил утилиту писать MP3, а проверка стала сверять каждый поток с оригиналом до запуска игры. Заодно нашлись уличные объявления в 48 кГц вместо родных 12–24, их я тоже исправил. И игра всё равно падала.
Тогда я предложил заглянуть в дампы. При вылете игра сама сохраняет снимок памяти в папку CrashLogs. Claude Code разобрал его и показал, что игра падает, когда ищет нужное место в таблице перемотки. Таблица перемотки — это оглавление звукового потока: с какого места файла начинается какой момент звука. Нужна она потому, что радио в GTA включается не с начала, а с середины, как будто станция играла всё это время, и игра перематывает поток.
Третья причина — порядок данных в файле. У Rockstar все служебные таблицы лежат до звука, а моя утилита клала таблицу перемотки после него. Игра держит в памяти только заголовок файла, до таблицы не дотягивалась, читала мусор вместо адреса и падала. Теперь раскладка каждого файла сверяется с оригиналом автоматически, и после этого игра падать перестала.
Почти. Уже в финальной сборке я переключил канал телевизора в игре, и она снова упала: ролики легли в архив сжатыми, а у Rockstar они несжатые. Теперь и способ хранения каждого файла сверяется с игрой.
❯ Как я чуть не потерял 333 часа звука
Всё было собрано, я играл, резал запись для поста и в какой‑то момент спросил: а почему реклама на радио английская? А потом: а почему телевизор не переведён?
В сверке покртия нашлась строчка статуса: 333 часа звука паков обновлений — «вне объёма: GTA Online / музыка DLC».
Такого решения я никогда не принимал, объём с первого дня был один: вся речь игры. Это правило Claude Code вписал в код сверки сам, паки не открывая, и сверка честно показывала 100%, потому что считала только то, что осталось в объёме. А в этих паках лежат и эфир, и радиостанции, которые звучат в сюжете. Я к тому моменту уже опубликвоал посты «озвучена вся игра». Пришлось удлаять.
Тем же способом вылетела часть звука, помеченная «не речь» без всякого распознавания. Среди неё потом нашлись пытки в сюжетной миссии и объявления аэропорта.
С тех пор в правилах первым пунктом стоит: любое «не брать» или «пропустить» только после моего «да», а сверка идёт по полному списку файлов игры.
Паки я прогнал тем же конвейером. Примерно у 40% нашёлся официальный русский текст, остальное распознавалось.
Телевизор в игре — это видеоролики в формате Bink, передачи, мультики и реклама. Звук вставляется официальной утилитой RAD без перекодирования, кадры тестового ролика совпали с оригиналом. У передач тоже есть официальные русские субтитры.
Иностранная речь. В игре полно испанского, китайского, корейского. Сначала она оставалась оригиналом, а потом я решил попробовать по‑русски с акцентом. Лучше всего вышел акцент прямо в тексте плюс описание в подаче, это единственное исключение из пустой подачи: «дэлаешь», «пендехо», «мадре миа». Песни я не трогал.
❯ Деньги и счёт, которого я не ждал
Итог из журнала пакетов:
Часть | Дублей | Часов речи | Долларов |
|---|---|---|---|
Сюжет и побочное | 106 066 | 100,8 | 27,59 |
Прохожие и герои | 118 699 | 81,1 | 22,22 |
Радио и рация | 17 584 | 18,4 | 5,03 |
Паки, длинные потоки, ролики | 20 497 | 18,5 | 5,08 |
Всего | 262 846 | 218,7 | 59,93 |
Дублей больше, чем реплик в выпуске, потому что сюда входят все переделки. Выходит около 27 центов за час готовой речи.
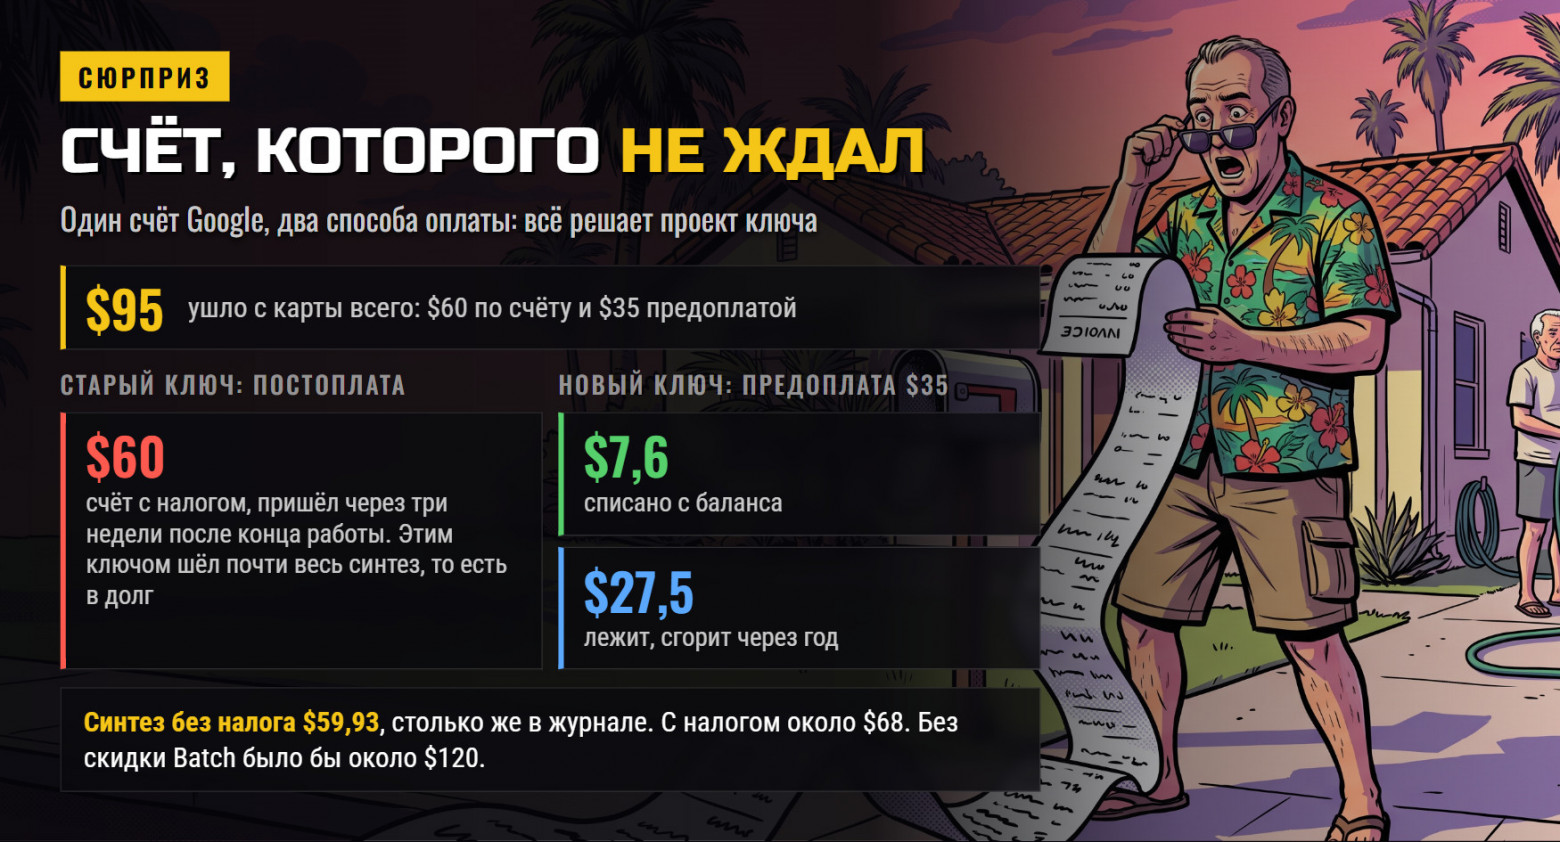
А теперь сюрприз. Ближе к концу работы старый ключ упёрся в «monthly spending cap». Я закинул около 35 долларов предоплаты, завёл новый ключ и успокоился: всё оплачено. Работу закончили, я прошёл игру. А через три недели Google выставляет счёт ещё на 60 долларов. Я вообще ничего не понял. За что, у меня же предоплата?
Полез разбираться. На одном платёжном счёте у Google живут сразу два способа оплаты, постоплата и предоплата, и какой сработает, зависит от проекта, в котором создан ключ. Почти весь синтез шёл старым ключом в проекте с постоплатой, то есть в долг. А предоплата осталась почти нетронутой.
Журнал и счёт сошлись. Лишние проекты я от счёта отвязал, теперь Gemini платится только с предоплаты. Кончится баланс — запросы встанут, зато внезапных счетов больше не будет. Совет: перед платным запуском смотрите не на баланс, а на то, как платит проект вашего ключа.
❯ Диск, время и железо
Сама игра весит 96 ГБ, а в разобранном виде всё это занимало порядка 300–500 ГБ: распакованный звук, отделённый голос, все версии дублей, пробные сборки. Пока шла работа, я каждый день удалял гигабайт по 500 временных файлов, потому что места не хватало. Одна только оценка укладки радио — это около 4 ГБ, 22 такие за день забили диск до нуля, и сборка упала на середине.
Собранные архивы всей озвучки, вместе с нетронутыми данными Rockstar внутри, весят около 69 ГБ. Всё, что не уходило в облако, считала одна видеокарта, RTX 4090: распознавала речь, отделяла голос от фона, определяла пол и говорящих, проверяла готовые дубли. По отметкам времени файлов она отработала не меньше 60 часов.
❯ А потом я сел и прошёл игру
Когда всё собралось, я сел и прошёл сюжетку целиком. Ушло около 30 часов, и это были отличные 30 часов. В первый раз я проходил пятёрку, читая субтитры на ходу. Теперь еду по Лос‑Сантосу и слушаю, о чём спорят Майкл, Франклин и Тревор, а заодно что несут прохожие и радио. Это как переводы времён Фаргуса: узнаваемо, местами смешно, местами мимо интонациии. Но играть с такой озвучкой гораздо приятнее, чем без неё, особенно когда перевод полный и без цензуры. И да, это всё ещё не лучше оригинала и на это не претендует.
❯ Честно про минусы
Раз уж я начал с дисклаймера, то им и стоит закончить, хотя всё равно кто‑то напишет в комментариях. Актёрской игры нет: синтез говорит ровно, крики тише, чем у актёров Rockstar, и это лечится только другим синтезом. Губы живут своей жизнью: артикуляция остаётся английской, а местами речь ускорена или текст сокращён.
Ошибки перевода будут. У прохожих и радио официальных субтитров нет, там цепочка из распознавания и нейроперевода, а 250 тысяч реплик глазами не проверишь. Голоса повторяются, потому что сотни второстепенных персонажей делят ограниченный набор, так что двух разных прохожих вы иногда услышите одним голосом. И вылеты возможны: все известные я починил, сам прошёл игру и больше вылетов не нашёл, но проверить всё во всех местах невозможно.
И в GTA Online с озвучкой поиграть не получится. Античит BattlEye блокирует загрузчик модов, игроки присылают логи с этим. А без загрузчика пропадает и озвучка. Как это победить, я пока не придумал. Хотя онлайн тоже переведён, так что, может быть, вы со своим агентом решите этот вопрос.
❯ Как поставить
Мне хотелось, чтобы озвучка ставилась как обычная программа: скачал, три раза нажал «Далее» и играешь. Файлы большие, и NSIS с его потолком 2 ГБ не подошёл, поэтому установщик сделан на Inno Setup.
Нужна GTA V Enhanced, то есть версия с файлом GTA5_Enhanced.exe, Legacy не подойдёт. Зато подойдет версия с торрентов, я тестировал на Grand.Theft.Auto.V.Enhanced-InsaneRamZes.
Скачайте с PlayGround архив с закадром или дубляжем, он весит около 2 ГБ. Распакуйте его и запустите установщик. Загрузчики модов уже внутри, отдельно ничего ставить не надо. На диске с игрой во время установки нужно около 7 ГБ свободного места, потом озвучка занимает около 5 ГБ.
Поставить можно только один вариант, и чтобы сменить его, сначала удалите прежний. Я советую закадр. Удаляется озвучка через Параметры Windows, в списке приложений она называется «Нейроозвучка GTA V», а игра после этого остаётся как была.
❯ Что дальше
Если бы начинал заново, первым делом сверял бы файлы с оригиналом по формату и с полным списком игры по объёму, на этом ушло больше всего нервов.
Удалять игру мне не хочется, мир затягивает. Думаю собрать свой сюжетный пак: порты дополнений из онлайна, фанатские миссии, и всё это сразу локализовать. Посмотрим, реально ли заставить это работать вместе.
Напишите в комментариях, какую игру вы бы хотели услышать по‑русски. И если поставите озвучку, расскажите, где она звучит смешно или мимо: такие места проще найти живому игроку, чем любой проверке.
Озвучку сюжета, закадр и дубляж, можно скачать на PlayGround. Больше про нейросети и мои проекты — на YouTube и в Телеграме.
Всех обнял и удачных заездов по Лос‑Сантосу.


Для участия в Чате вам необходим бесплатный аккаунт pro-blockchain.com
Войти
Регистрация
Похожие новости
Подпишись на telegram канал и узнавай первым обо всех новостях