 Русский
 English
Cryptocurrencies:
8013 /
Markets: 108500
Market Cap: $ 2 480 947 632 137 /
24h Vol: $ 70 600 266 625 /
BTC
Dominance: 60.249331295815%
Новости
NLP с трдельником: какие идеи я привезла с EMNLP 2026
Привет, Хабр! Я — Мария Марьина, научный сотрудник лаборатории «Вычислительная семантика» AIRI. В конце октября я побывала на EMNLP в Будапеште, где мы с коллегами представили две работы, а я впервые выступила с устным докладом.
Расскажу, как прошёл эксперимент оргкомитета с AI‑рецензированием, какие исследования мне запомнились, куда дальше двигаться NLP и за что дали Best Paper Awards. Поделюсь своим способом выбирать постеры, когда посмотреть всё невозможно, и покажу немного Будапешта, на улочках которого можно выдохнуть после конференции. Термы и трдельники тоже будут.
Погнали!
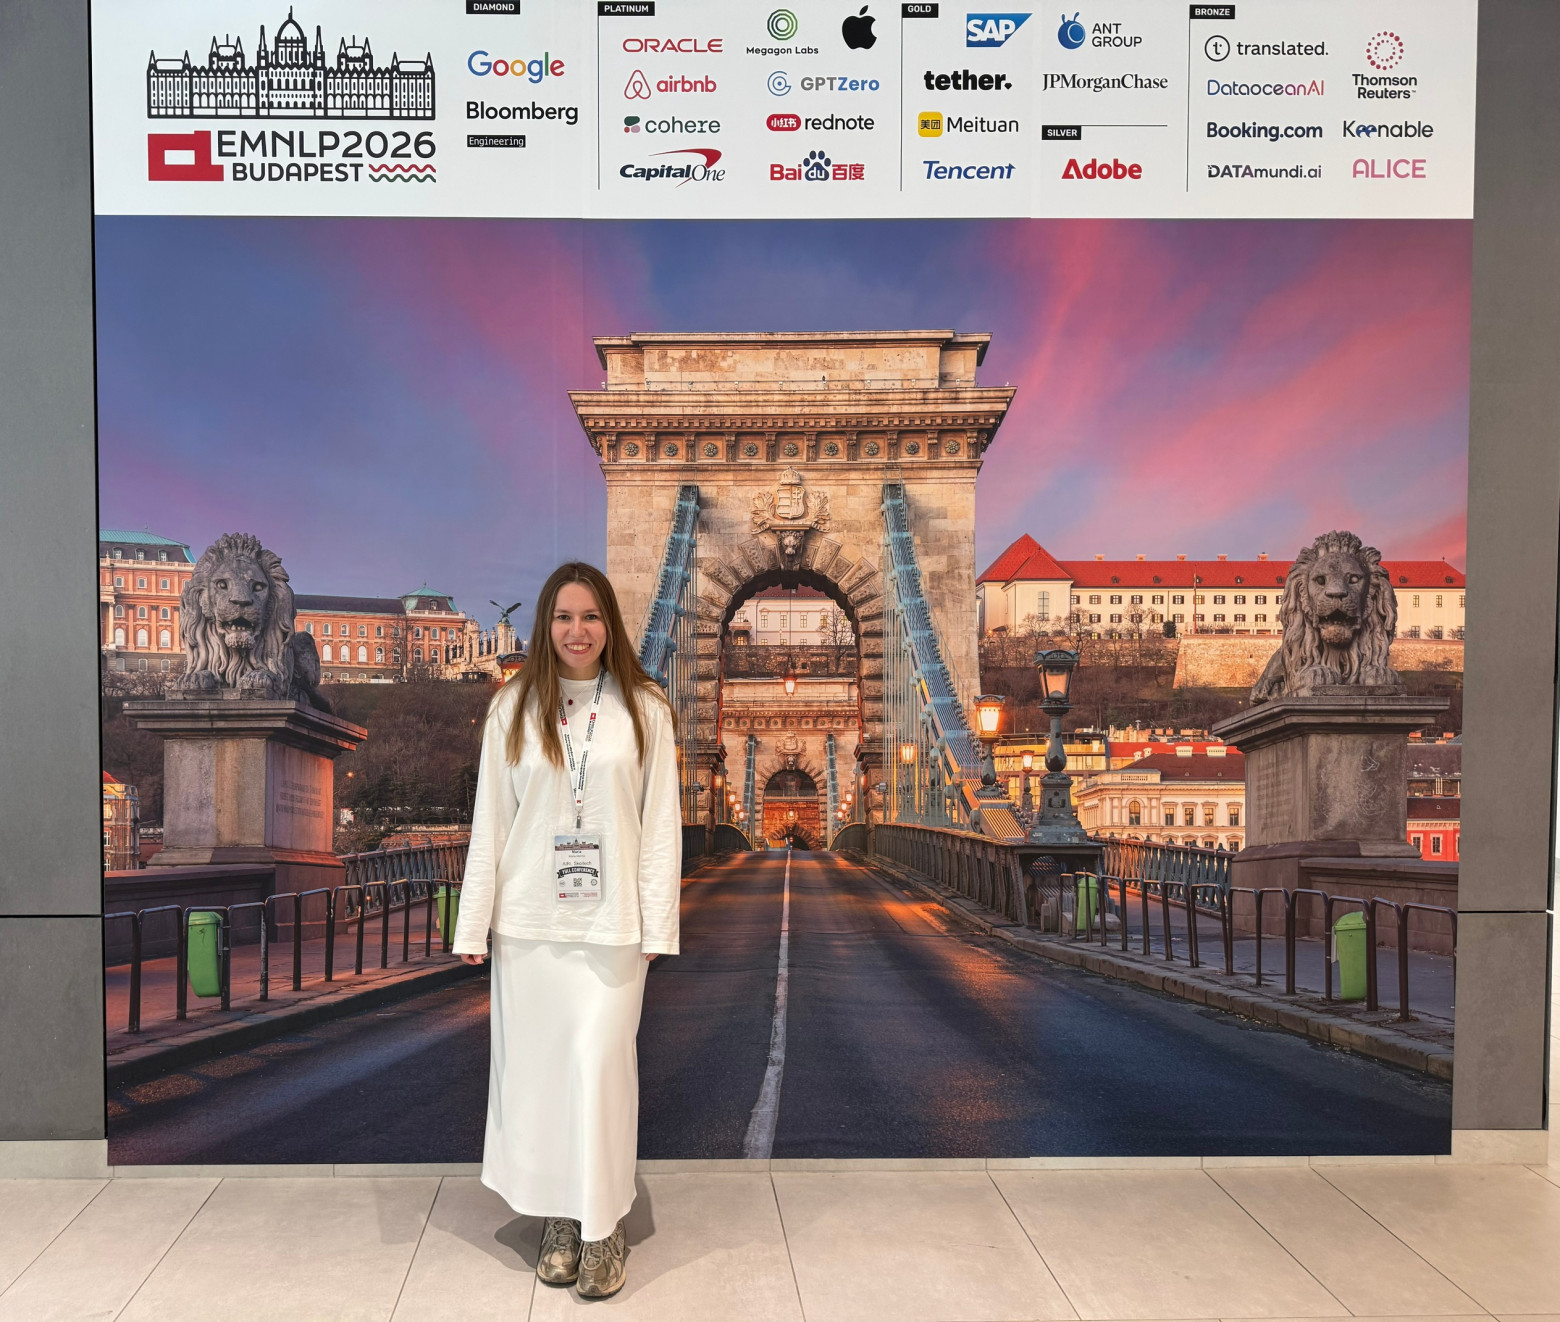
Пару слов про EMNLP
EMNLP — одна из наиболее авторитетных и цитируемых международных научных конференций в области NLP. Она выросла в 1996 году из сообщества, сформировавшегося вокруг воркшопа Workshop on Very Large Corpora (WVLC), которое, в свою очередь, являлось частью Ассоциации компьютерной лингвистики (ACL).
Если флагманская конференция ACL (которая так и называется) охватывает широкий спектр исследований в области компьютерной лингвистики и NLP, то исторический фокус EMNLP — корпусные, статистические и экспериментально проверяемые методы. Сегодня тематика двух конференций во многом совпадает и включает LLM, мультимодальность, агентов и интерпретируемость. Хотя на EMNLP чуть менее конкурентная среда, чем на других топовых конференциях, публикация на ней является значимой для комьюнити.
По сравнению с прошлым годом число поданых и принятых статей выросло примерно вдвое. Всего на конференцию подали 17 661 работу: в основную программу приняли 2 705 статей — 15,3%, в Findings — ещё 2 480 или 14%. Этот рост означает и большее количество исследований, и большую нагрузку на рецензентов.
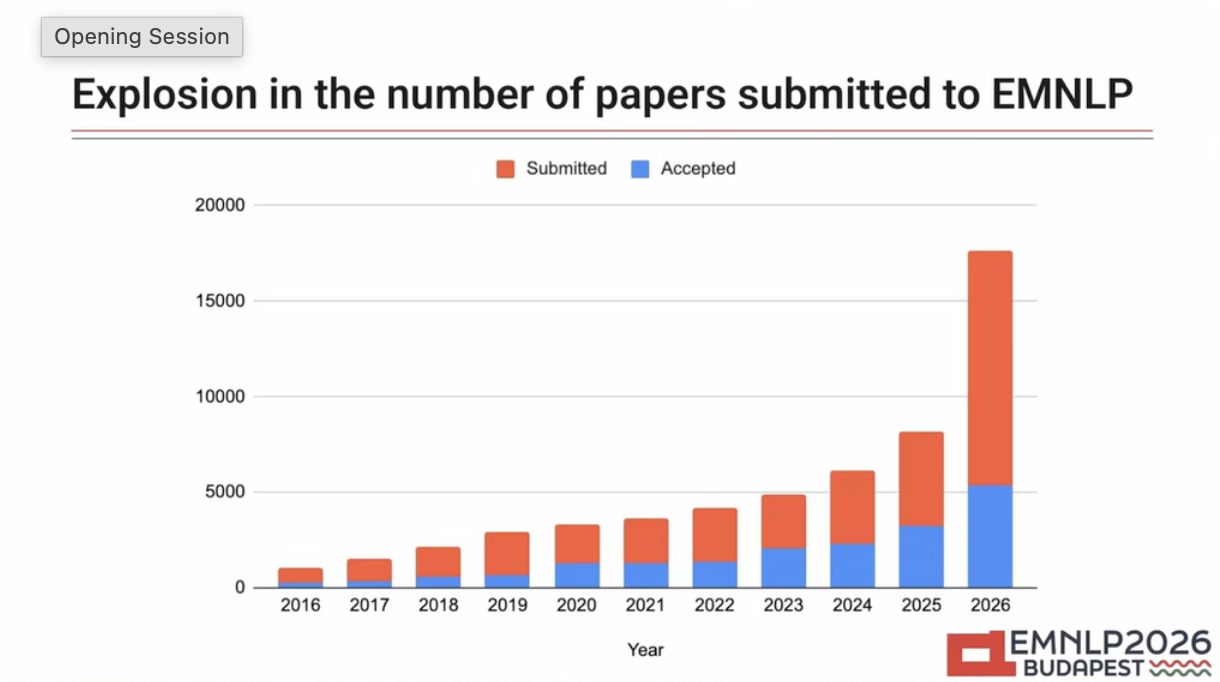
Статистика по годам, предоставленная оргкомитетом
Что касается тематики работ, то по числу подач ожидаемо лидируют LLM‑агенты. Следом идут ресурсы и оценка качества, мультимодальность и связь языка с миром, интерпретируемость моделей и вычислительная эффективность. В центре внимания оказываются вопросы о том, как применять модели, проверять их способности, понимать их работу через призму интерпретируемости и снижать затраты как на обучение, так и на инференс моделей. Отдельные направления классической лингвистики — синтаксис, морфология, фонология — представлены значительно меньшим числом статей.
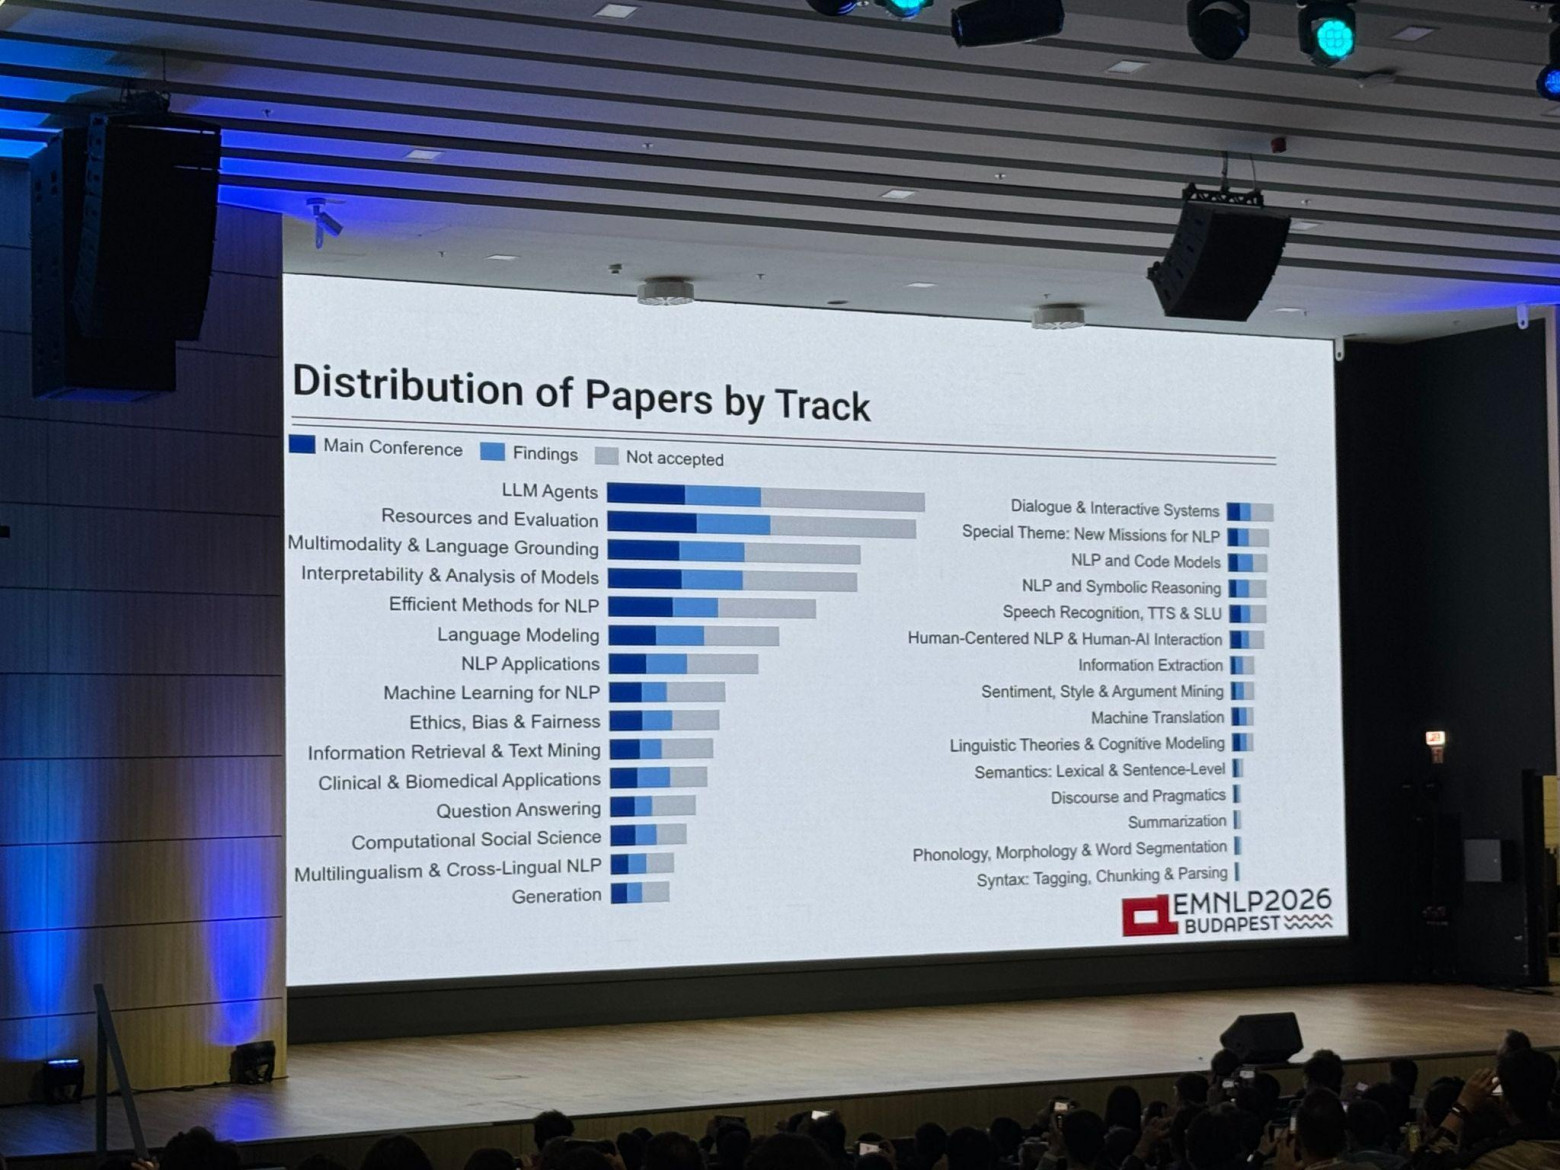
Про эту и прочую статистику рассказывали на открытии конференции
В этот раз организаторы ввели более строгие правила приема статей — Paper Integrity Policy. Они ограничивают дробление результатов на несколько статей с небольшим самостоятельным вкладом (слайсинг) и ужесточают проверку ссылок. Поданные единомоментно близкие работы с пересекающимся составом авторов должны ссылаться друг на друга и объяснять различия между ними. Вместе с этим организаторы проверяли одновременные подачи на разные конференции и раскрытие использования ИИ. За нарушения, связанные с дроблением результатов и параллельными подачами, отклонили 80 статей. Из‑за непроверяемых ссылок и нераскрытого использования ИИ — ещё 258 на этапе рецензирования и 9 при проверке финальных версий.
Эксперимент с AI‑рецензированием
На фоне растущей нагрузки на рецензентов организаторы EMNLP провели эксперимент с AI‑рецензированием. Использовали три варианта AI‑рецензентов: систему AAAI на GPT-5.4 и ReviewerToo с двумя моделями — GPT‑OSS-120B и GLM-4.7 Flash. Первую уже обкатывали в этом году на AAAI 2026 — об этом можно почитать в репортаже моего коллеги Александра Панова. Авторы добровольно получали сгенерированные отзывы и оценивали их качество. Эти рецензии были недоступны комитету, принимающему решения о приеме или отклонении статьи.
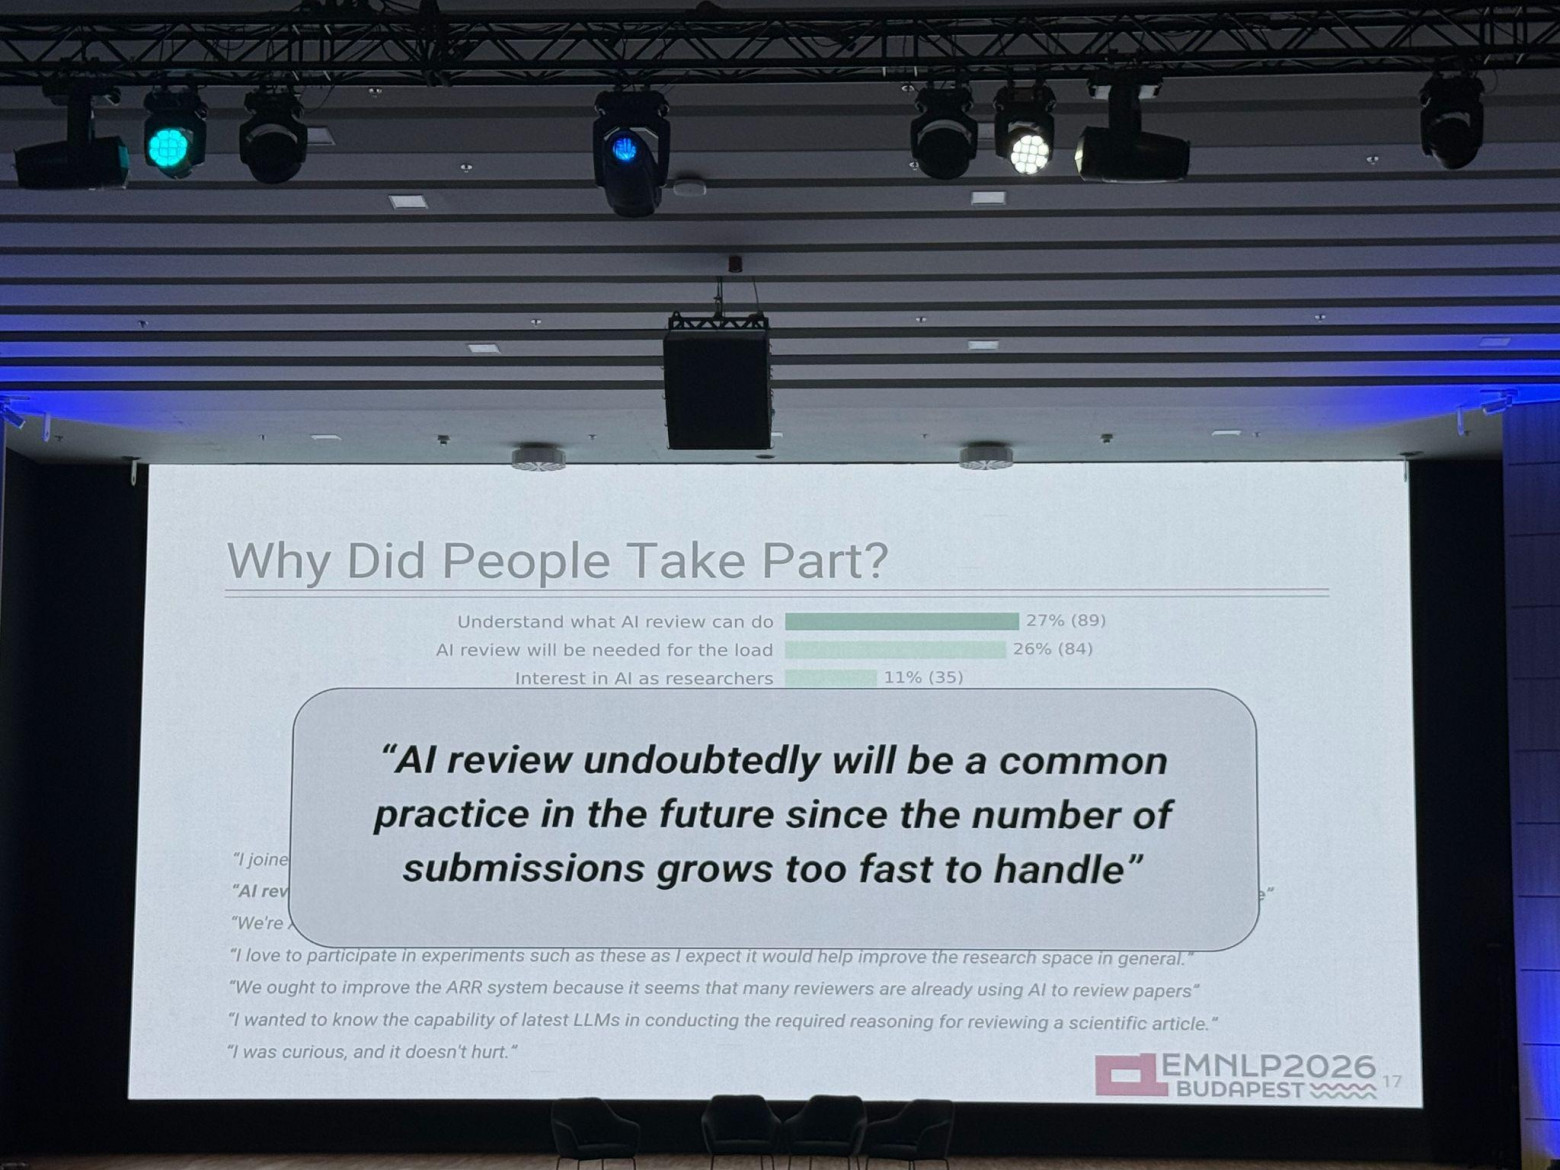
Часть участников видела в автоматизации способ справиться с потоком работ. Один из них сформулировал это так: «В будущем AI‑рецензирование, несомненно, станет обычной практикой: число подач растёт слишком быстро, чтобы с ним можно было справиться».
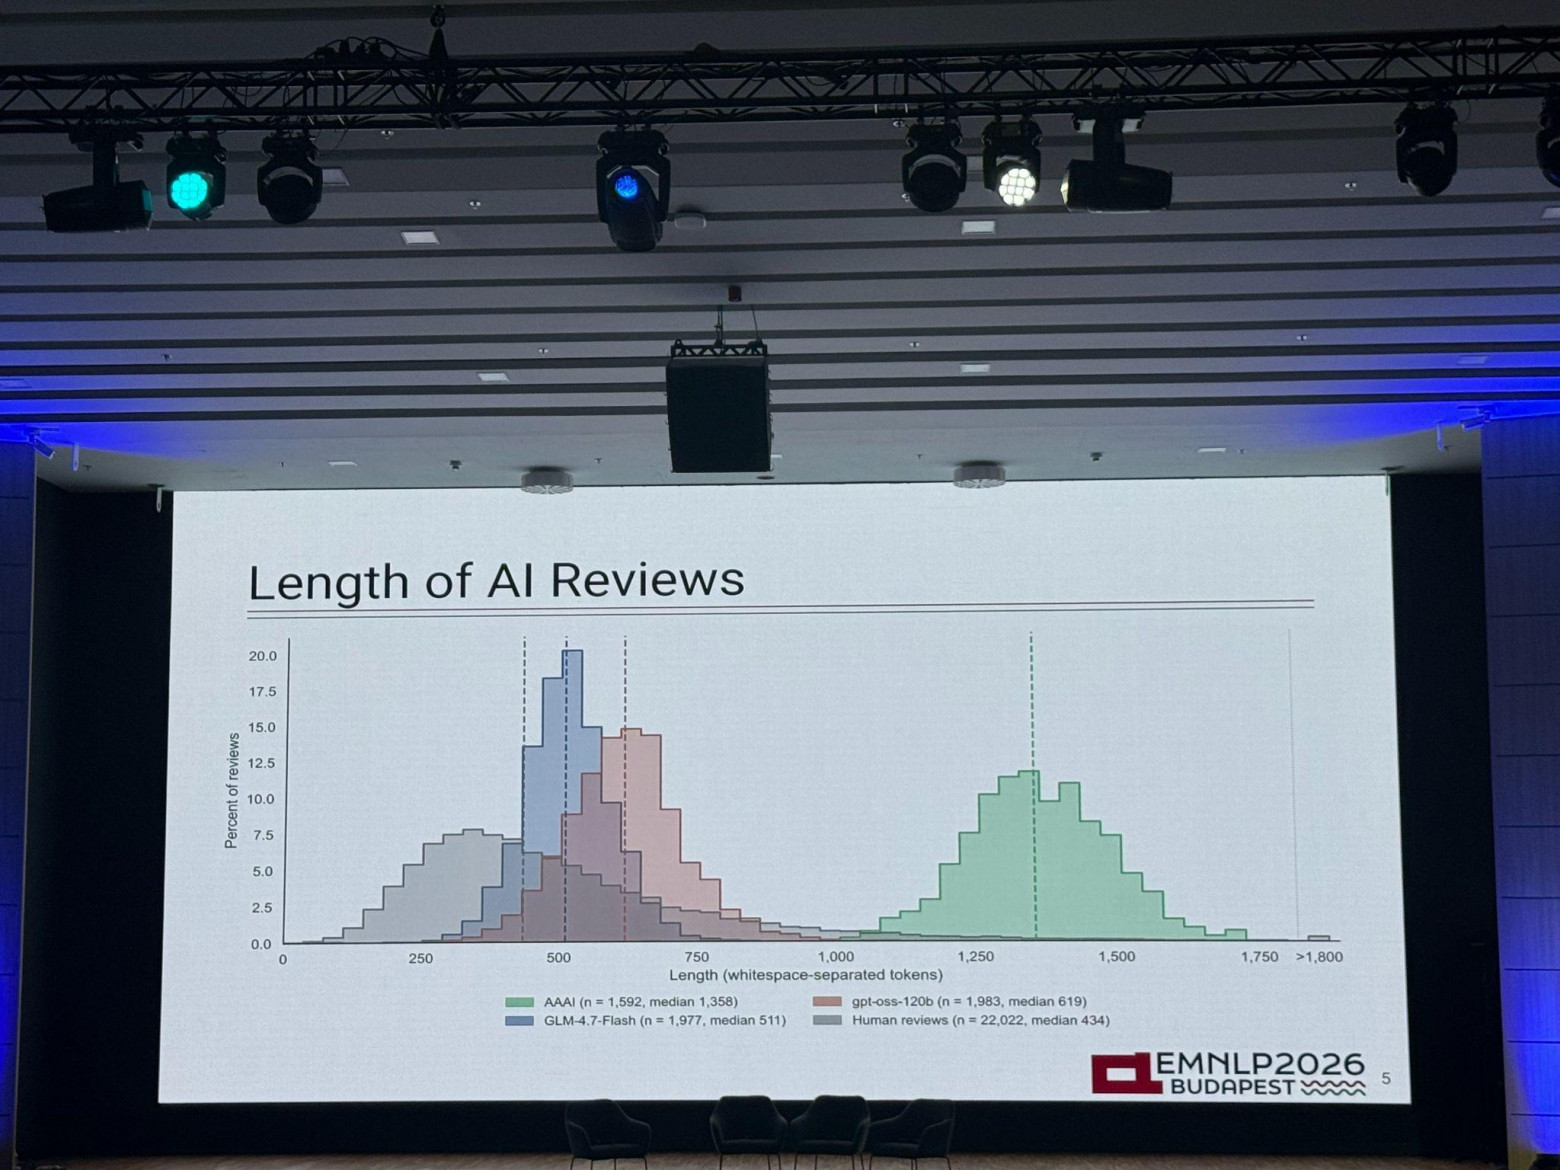
ИИ оказался многословнее людей. Особенно выделялась система AAAI на GPT-5.4: медианная длина её рецензий была более чем втрое выше человеческой. У GPT‑OSS-120B и GLM-4.7 Flash разница была меньше. По мнению авторов, ИИ хорошо передавал суть работы и отмечал ее сильные стороны, но его критика была менее убедительной.
В комментариях авторов, отказавшихся от участия в эксперименте, звучала важная претензия: ИИ придирается к деталям и требует всё новых экспериментов, но недооценивает новизну идеи и объём уже проделанной работы.
И в самом деле, AI‑рецензия может превратиться в огромный список необходимых правок: здесь нет доверительного интервала, там не подтверждена статистическая значимость, не хватает важных бейзлайнов или результатов на дополнительных бенчмарках. Всё это действительно важно — и для оценки надёжности выводов, и для сравнения нового подхода с существующими. Но за потоком замечаний может потеряться сама идея: что авторы предложили нового, какую проблему помогли решить и какие возможности открывает их работа.
Мне кажется, фокус рецензии стоит больше смещать в эту сторону. Важно увидеть научный вклад и понять, какие из недостающих экспериментов действительно необходимы для его оценки, а какие просто сделали бы и без того большую работу ещё больше. Подробная критика полезна, когда за ней стоит понимание того, что в исследовании главное.
Скорость написания статей увеличилась, но наша вместимость и количество информации, которое мы способны воспринять, остались на месте. Вскоре нагрузка на рецензентов увеличится, и AI будет помогать в том, чтобы не пропустить что‑то важное. В этой связи мне нравятся мысли коллег о том, что чтобы AI не полностью заменил человека (как это сейчас иногда случается), у рецензентов тоже должен быть какой‑то стимул, например, что‑то типа специального рейтинга. Это могло бы поощрять содержательные отзывы и снижать соблазн просто переслать авторам сгенерированный текст.
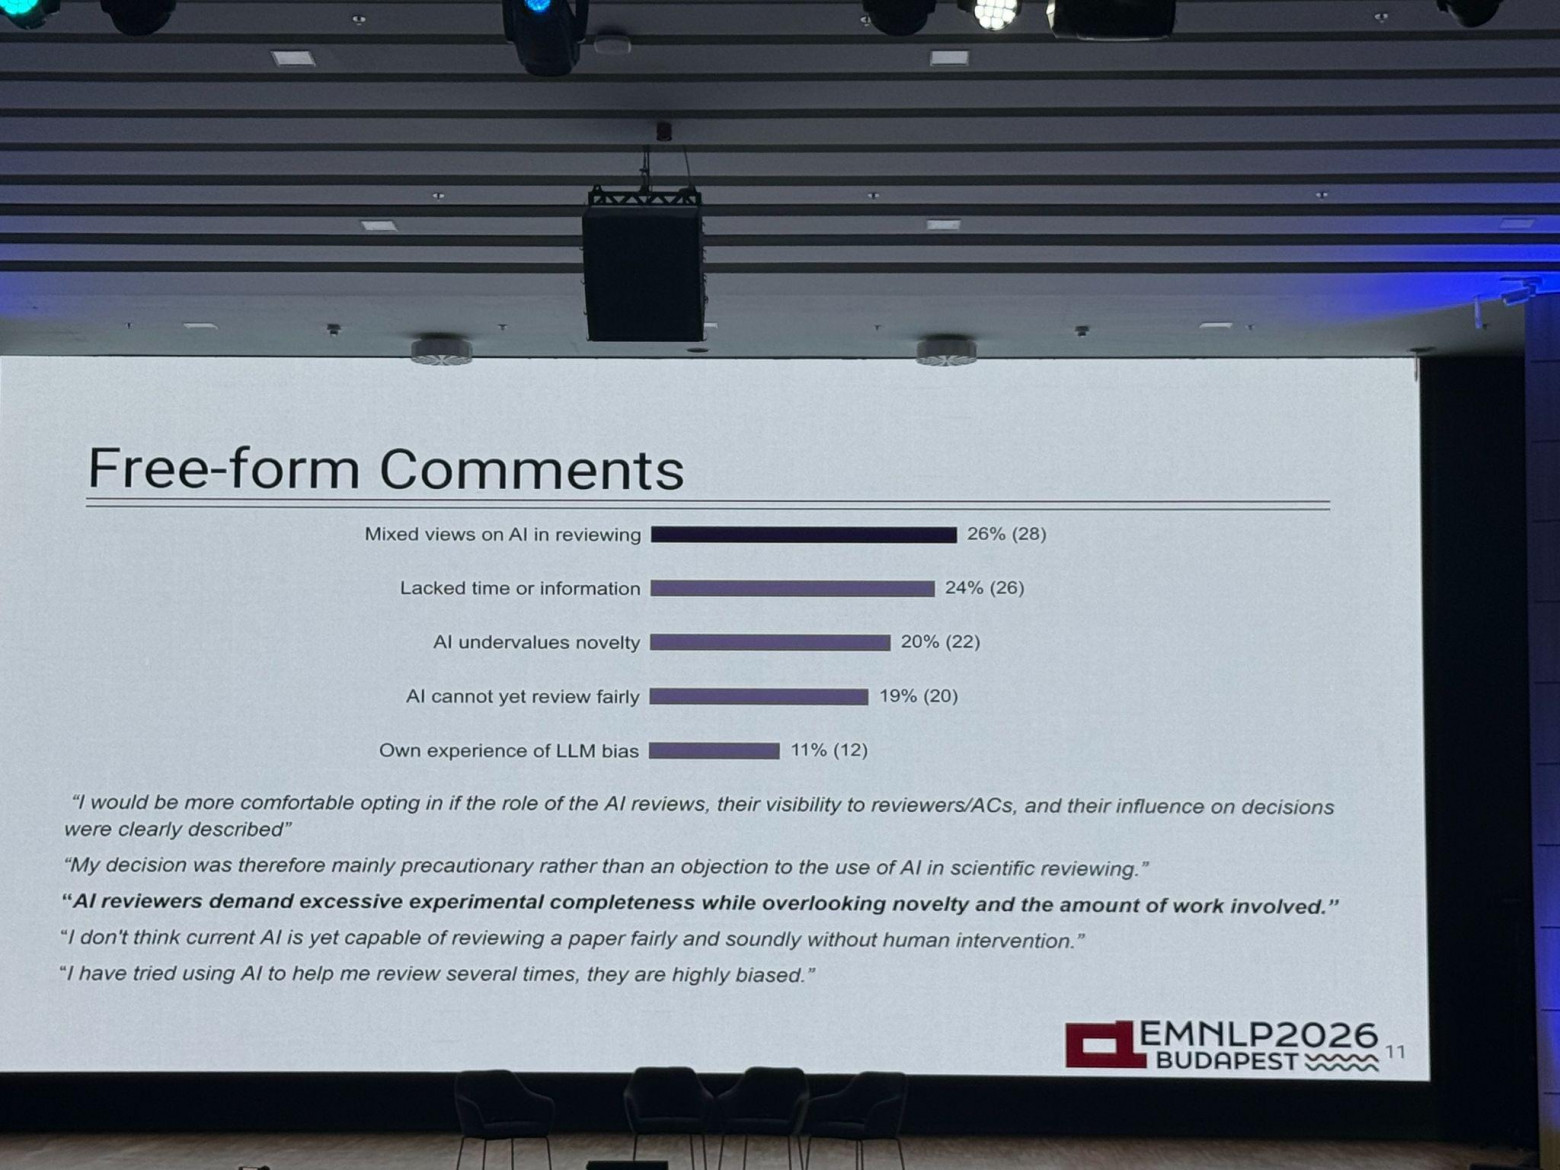
Мысли живых учёных по поводу AI‑рецензий
Научная программа
Как и на всякой топовой конференции ранга A*, программа здесь была насыщенная и необъятная, хотя приглашённые доклады я старалась не пропускать. Сильнее всего среди них меня впечатлила лекция Pascale Fung, про неё расскажу подробнее.
Куда должна двигаться NLP?
Pascale Fung — соосновательница и директор по исследованиям и инновациям AMI Labs, исследовательской компании в области искусственного интеллекта, специализирующейся на моделях мира (world models). На своей keynote‑лекции она задала вопрос — что такое NLP, когда NLP занимаются все?
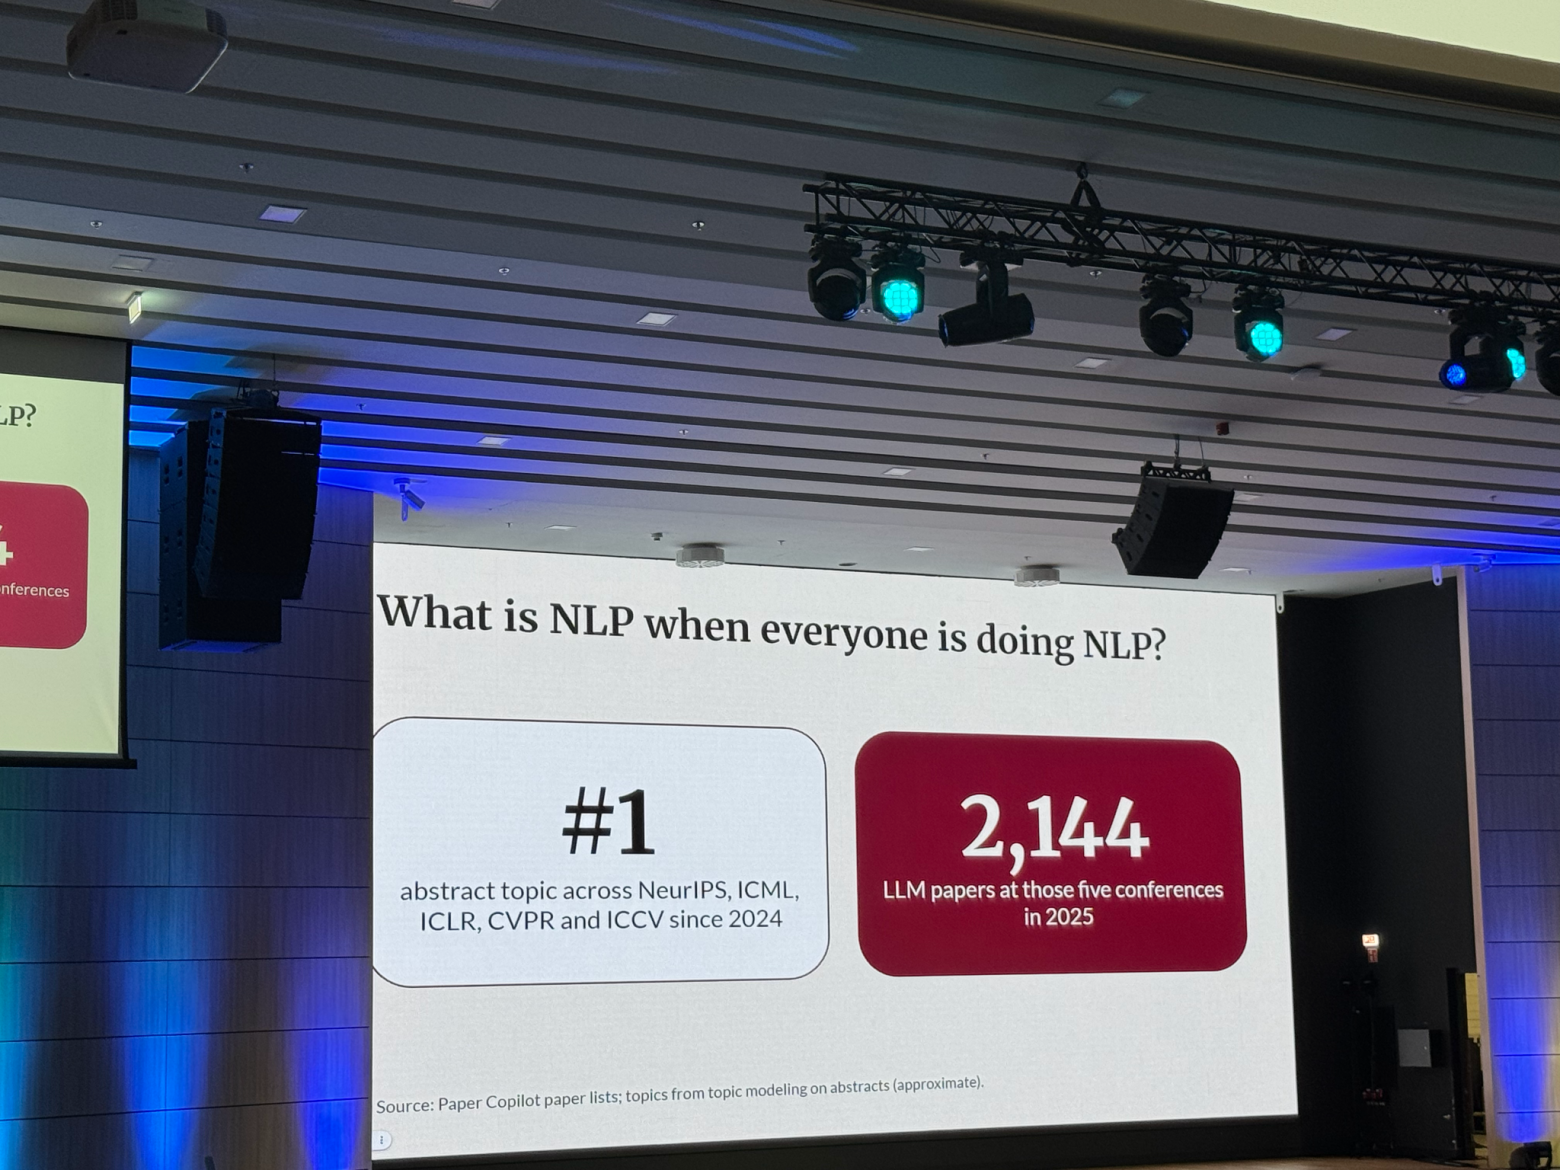
У нашей области исторически две цели. Компьютерная лингвистика стремится понять человеческий язык с помощью вычислительных методов, а обработка естественного языка (NLP) — создавать системы, способные решать языковые задачи. Обе цели отражены в первоначальном названии ассоциации: в 1962 году будущая ACL называлась Association for Machine Translation and Computational Linguistics.
Ещё у Шеннона предсказание было инструментом понимания: в 1948–1951 годах он использовал вероятностные модели и эксперименты с угадыванием следующей буквы, чтобы исследовать предсказуемость и энтропию английского языка. Со временем акцент сместился к построению работающих систем. Сначала их основой служила лингвистическая теория, затем — данные, позже — нейросетевые архитектуры.
Сегодня одна универсальная модель становится основой систем для множества задач. При этом возможности моделей растут быстрее нашего понимания того, как они работают. Какой же шаг следующий?
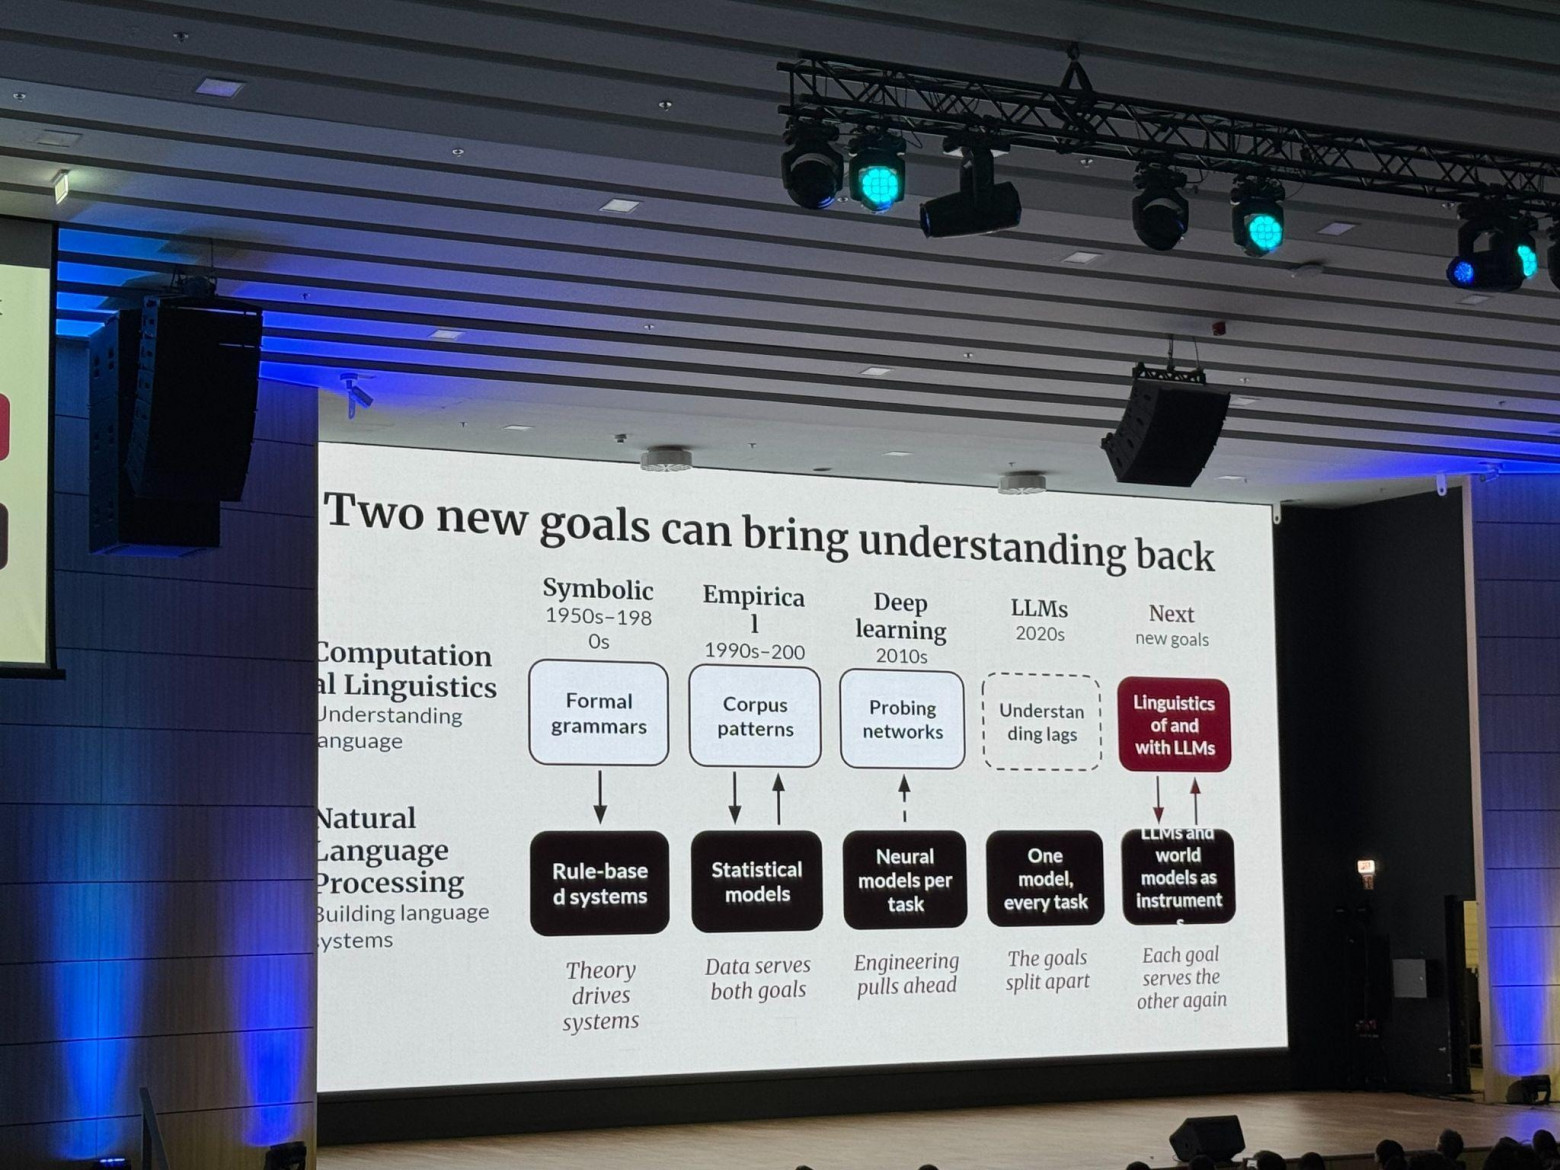
Теперь, по мнению профессора, пониманию нужно догнать инженерные достижения. Следующий шаг — снова сблизить две исходные цели: изучать сами LLM и использовать их для изучения человеческого языка. С точки зрения Pascale Fung, первый путь открывает 6 необходимых направлений для развития:
Интерпретируемость на базе лингвистики — понять, как внутри модели устроена грамматика: как она учитывает структуру предложения, согласует слова, определяет, на кого или на что указывают местоимения, и различает смыслы (типичный пример: «не все пришли» и «никто не пришёл»).
Поведенческие эксперименты — менять в предложениях одну деталь за раз и проверять, какие языковые различия модель замечает, а какие пропускает.
Компетенция и выполнение задач — понимать, почему модель проходит тест, но ошибается при небольшом изменении исходного запроса.
Галлюцинации и достоверность — понять, почему модели дают убедительные, но неверные ответы или искажают информацию из источников.
Язык LLM и его особенности — изучать, есть ли у моделей узнаваемый стиль, насколько однообразны их тексты и как они влияют на то, что пишут люди.
Язык и понимание мира — может ли модель понять, как устроен мир, учась предсказывать продолжение текста, или для этого нужен опыт взаимодействия с ним?
Второй путь делает LLM инструментами исследования человеческого языка. Здесь они могут выступать в трёх ролях:
Модели усвоения языка позволяют изучать обучение на контролируемых данных — например, в BabyLM и экспериментах с «невозможными» языками.
Модели мышления и мозга позволяют сопоставлять предсказуемость слов со временем чтения, а внутренние представления — с реакциями мозга.
ИИ‑исследователи помогают формулировать гипотезы, размечать данные и проводить масштабные эксперименты.
Один из ключевых вопросов здесь — эффективность усвоения языка. По одной из оценок, к 13 годам ребёнок слышит менее 100 млн слов, тогда как LLM предобучают на триллионах токенов. Этот разрыв ставит вопрос о том, какую роль в обучении играют врождённая структура и опыт взаимодействия с миром. Контролируя условия обучения моделей, мы можем проверять гипотезы о том, почему детям требуется настолько меньше языковых данных. Здесь мне вспоминаются рассуждения Яна Лекуна, почему нам нужны именно мультимодальные языковые модели.
Так мы возвращаемся к Шеннону: предсказание снова становится инструментом понимания. Лингвистика LLM помогает понять, что усвоили модели, как они обобщаются и где ошибаются. Лингвистика с помощью LLM помогает понять людей: как мы осваиваем язык и как много о мире и чужих намерениях можем узнать только через язык.
Мне кажется, этот призыв к пониманию важен и за пределами лингвистики. Когда ИИ помогает формулировать гипотезы и проводить эксперименты, нам особенно важно уметь оценивать результаты и самостоятельно выбирать следующий шаг. Мне понравился недавний пост Станислава Федотова на эту тему: “I do hope we humans will still have a say in steering the direction of research. But steering requires understanding, and understanding can be slow.”
Про другие работы
Моей первой конференцией была ACL 2025. Уже на первой постерной сессии я совершила ошибку новичка — попыталась обойти все постеры. В результате я почувствовала ментальную перегрузку: до конца дня новая информация в голову почти не помещалась. С тех пор у меня появился свой конференционный алгоритм — возможно, он пригодится и вам.
Больше всего времени я отвожу постерным сессиям и воркшопам. У постера можно подольше поговорить с автором один на один, прервать автора на непонятном моменте и обсудить работу с другими слушателями. На воркшопах проще найти людей, которым интересна та же узкая тема, и договориться о совместном исследовании. Есть у них, на мой взгляд, и преимущество в рецензировании: благодаря тематическому фокусу выше шанс, что работу оценит человек, который хорошо разбирается именно в вашей области.
Накануне каждого конференционного дня я описываю нейронке свои интересы и прошу составить расписание — это помогает отобрать часть постеров. А перед постерной сессией дополнительно просматриваю программу сама на табло: ищу пропущенные работы и темы, которые забыла включить в запрос.
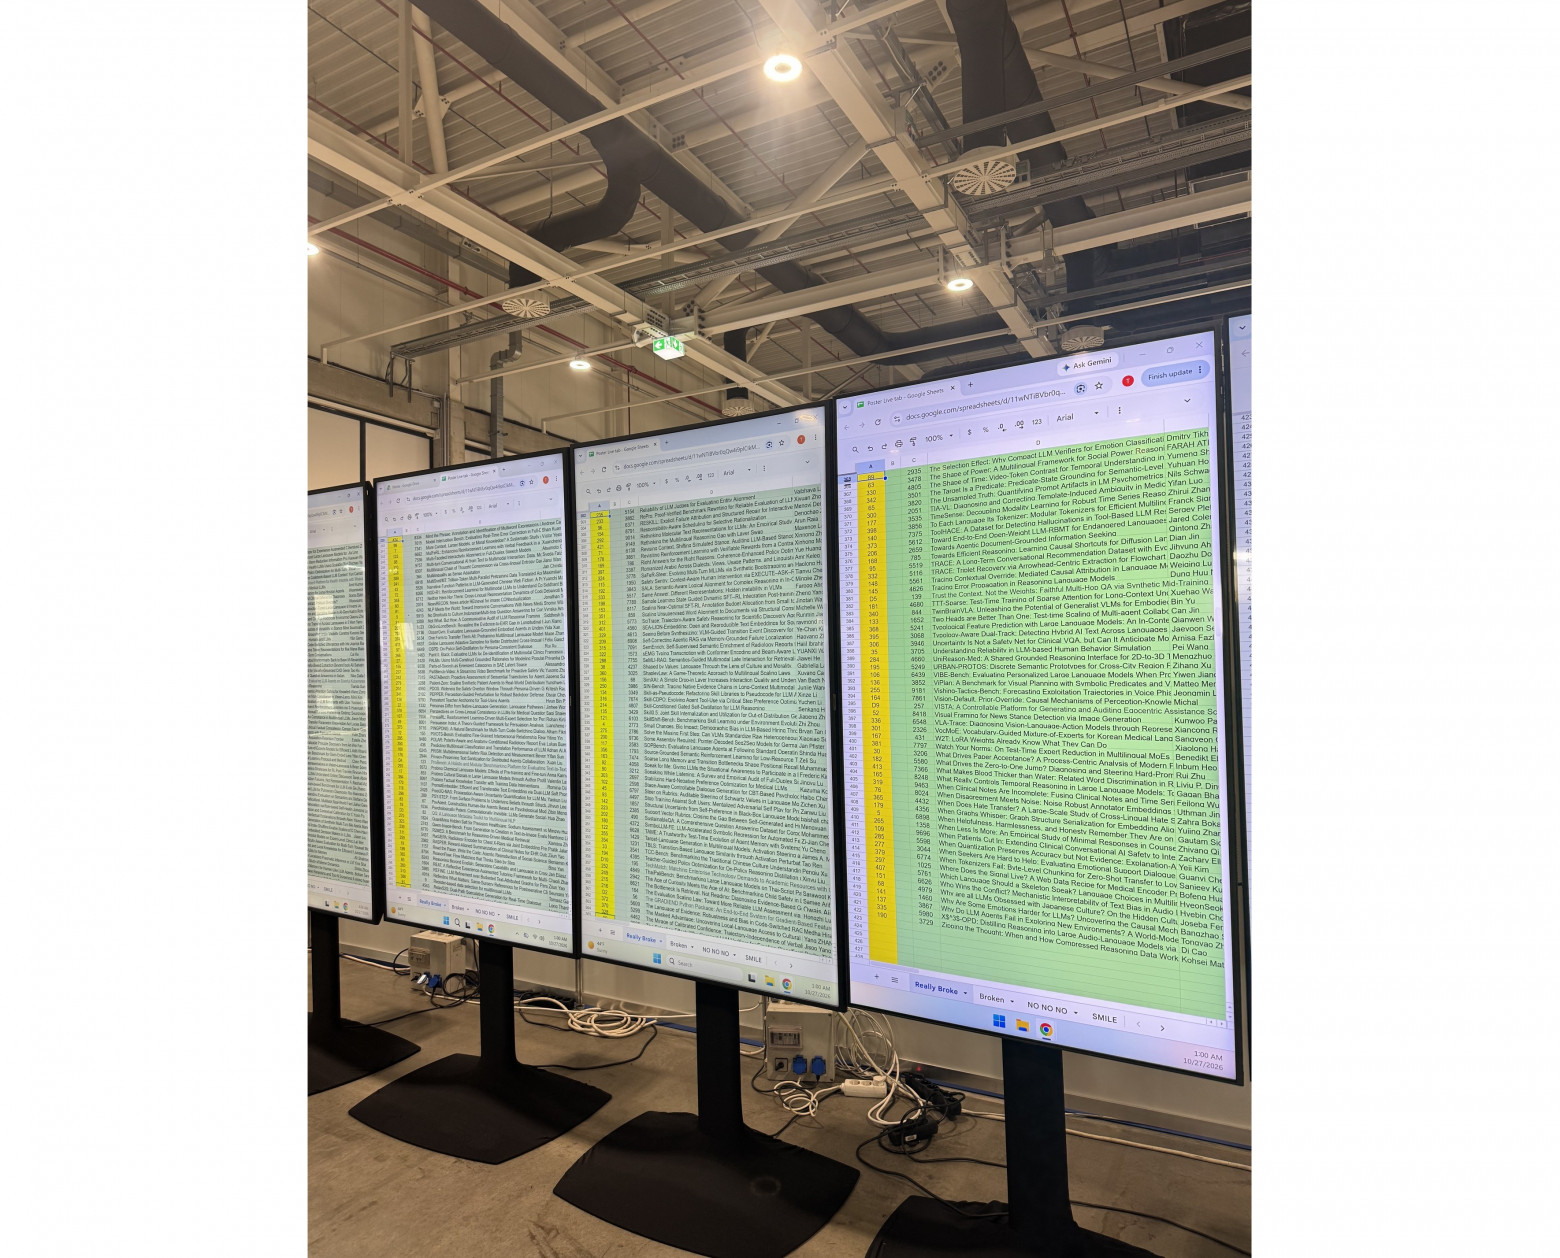
Сопоставление номера постера и названия работы перед каждой постерной сессией
Дальше расскажу про несколько работ, которые мне запомнились (тут, конечно, есть bias относительно моих исследовательских интересов):
Начну с лингвистики и токенизации.
How Do Language Models Represent and Use Phonological Information for Allomorph Selection? — работа о том, запоминают ли языковые модели готовые сочетания слов или используют общее правило при выборе артикля. Например, выбор между a university и an hour зависит от первого звука, а не буквы. Авторы находят в эмбеддингах направление, кодирующее этот признак, и показывают на новых искусственных токенах: сдвигая эмбеддинг вдоль этого направления, можно управлять выбором артикля. Это свидетельствует в пользу обобщаемого правила, выходящего за рамки запоминания знакомых сочетаний. Красивый пример того, как классическая лингвистическая задача помогает разобраться во внутреннем устройстве LLM.
Objective vs. Search: Decomposing What Makes a Good Tokeniser — авторы разбирают, что определяет различия между BPE и Unigram токенизаторами: цель обучения или способ построения словаря. BPE оптимизирует сжатие и объединяет токены, Unigram — правдоподобие корпуса и удаляет лишние. Разделив эти факторы в экспериментах на моделях до 1B, авторы обнаружили, что способ построения особенно важен: объединение чаще давало лучшее качество предсказания текста. При этом на грамматических тестах универсального победителя не нашлось.
To Each Language Its Tokenizer: Modular Tokenizers for Efficient Multilingual LLMs — большой общий словарь обходится дорого и неодинаково хорошо обслуживает разные языки. Авторы предлагают модульные токенизаторы, из которых можно собрать словарь под нужный набор языков. Модель заранее обучают работать с такими подмножествами, поэтому при использовании можно сократить словарь вместе с соответствующими матрицами. Получается экономия памяти и ускорение генерации при сопоставимом качестве — особенно полезная идея для небольших мультиязычных моделей.
Две следующие работы — про рассуждение и его связь с образованием.
Do LLMs Exhibit Coherent Knowledge Structures in Mathematical Reasoning? A Perspective from Knowledge Space Theory — авторы проверяют, насколько математические навыки моделей связаны между собой. Идея из теории обучения: решение сложной задачи обычно предполагает владение необходимыми базовыми навыками. Сравнение восьми LLM с реальными учениками показывает, что модели могут успешно решать продвинутые задачи и ошибаться на их предпосылках. Даже высокая общая точность не гарантирует согласованности навыков.
Do Language Models Follow Occam’s Razor? An Evaluation of Parsimony in Inductive and Abductive Reasoning — работа о том, следуют ли LLM бритве Оккама — принципу, согласно которому из одинаково точных объяснений стоит выбирать самое простое. Авторы создают искусственные миры с логическими правилами и оценивают правильность гипотез и количество необходимых предположений. По мере усложнения задач модели чаще добавляют лишние предположения или просто пересказывают наблюдения.
Ещё один блок — ИИ как автор и редактор.
AI Writers Have a Consistent Stylometric Footprint, but AI Editors Do Not — авторы сравнивают полностью сгенерированные тексты с человеческими после редактуры LLM. У генерации обнаруживаются два устойчивых признака: больше разных слов относительно длины текста и более равномерное распределение их частот — выше лексическое разнообразие и энтропия. При редактировании разнообразие растёт лишь немного, а энтропия в среднем снижается. Самое заметное изменение — снижение лексической плотности: доли содержательных слов относительно служебных. Поэтому генерация и редактура оставляют разные стилистические следы.
Последняя группа — интерпретируемость и достоверность LLM.
PRISM: Recovering Instruction Sets from Language Model Activations — метод, который по внутренним активациям модели восстанавливает список обрабатываемых инструкций, ограничений и подзадач. Для этого обучают интерпретатор, использующий те же базовые веса с дополнительными адаптерами. Так можно выявлять prompt injection — например, вредоносную команду внутри документа, который читает агент. Здесь полезно различать присутствие инструкции и её выполнение: PRISM способен восстановить вредоносную инструкцию даже тогда, когда сама модель отказывается ей следовать.
Stick to What You Know: A Study of Knowledge‑Aligned Supervised Fine‑Tuning — работа о том, как содержание обучающих ответов влияет на галлюцинации. Метод Recall Rewrite разбивает ответы на утверждения и удаляет те, которые базовая модель не умеет устойчиво воспроизводить. На Qwen3 4B и OLMo3 7B это уменьшает галлюцинации, но увеличивает число отказов отвечать. Идея учитывать исходные знания модели перекликается с нашей работой, где мы добавляли уже знакомые примеры (HighlyKnown) при обучении новым фактам, что позволяло как запомнить новые факты, так и снизить падение на внешних бенчмарках.
За что нынче дают best paper awards?
На EMNLP 2026 отметили 51 работу. Две получили Best Paper Award, ещё 22 — Outstanding Paper Award, а 22 вошли в Senior Area Chair Highlights. По одной работе отметили в категориях Best Special Theme Paper, Best Resource Paper и Social Impact Award. Среди демонстрационных систем выбрали победителя Best Demo Paper и runner‑up.
Подробнее остановимся на двух основных Best Paper.
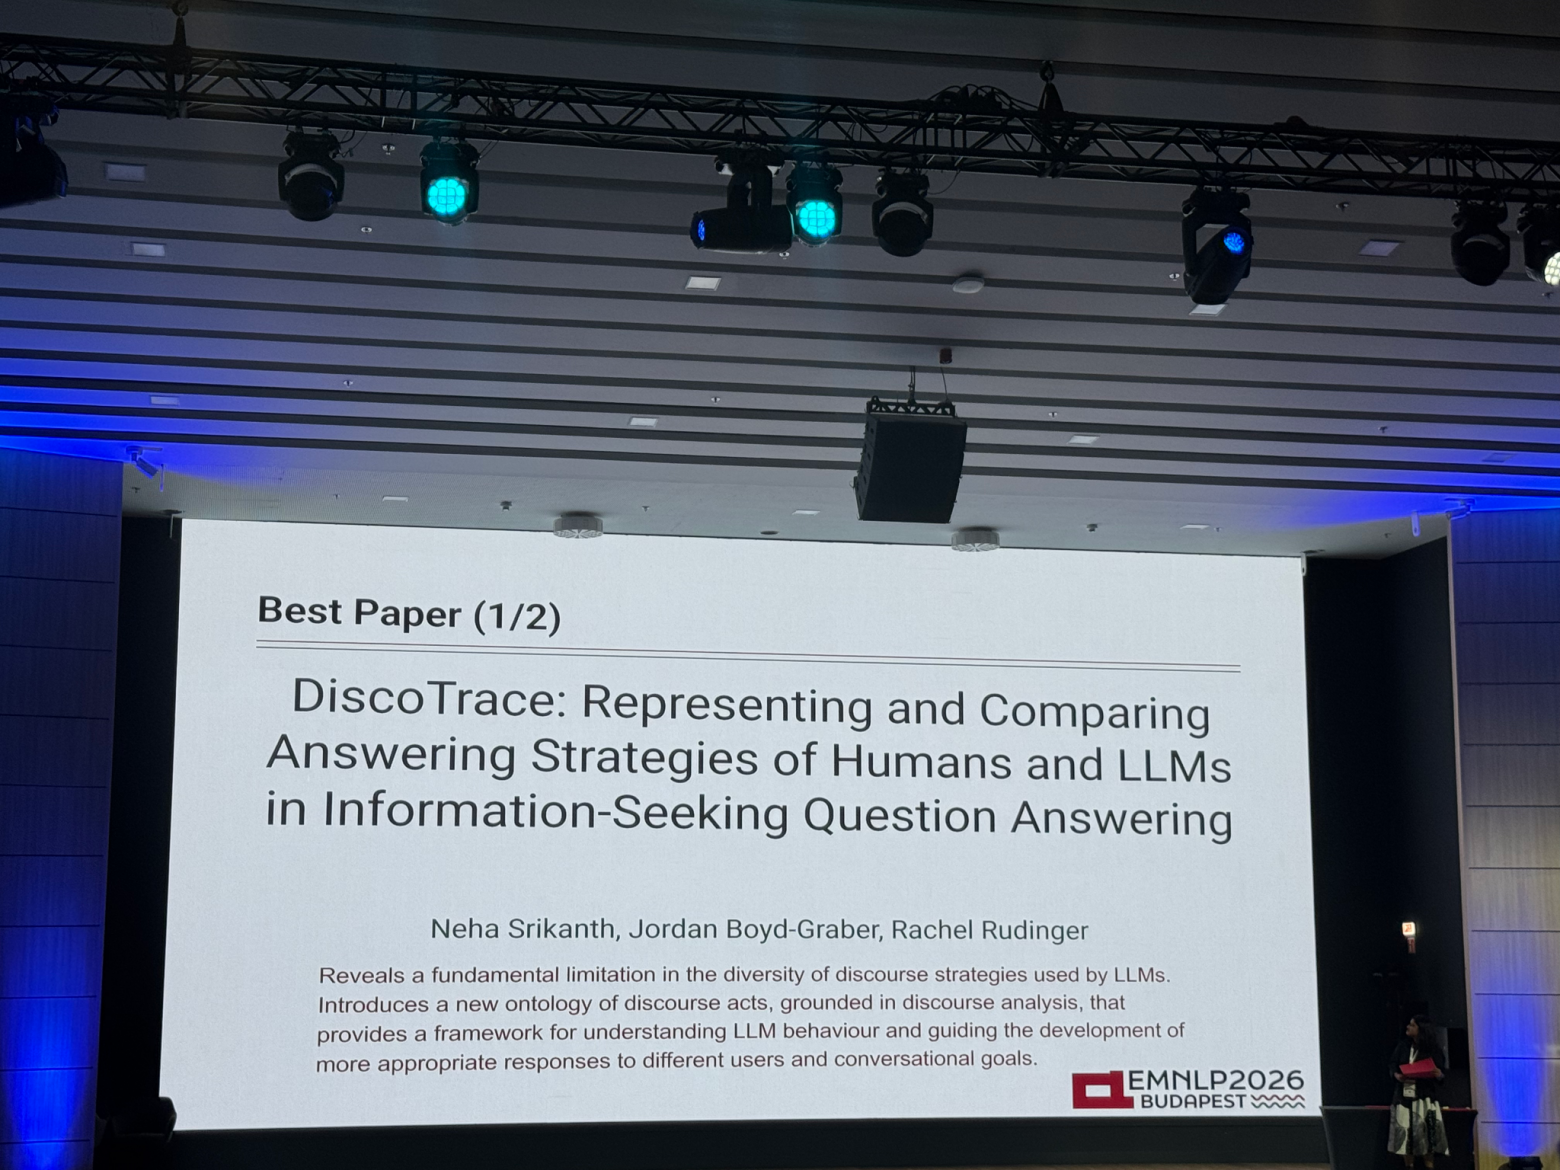
DiscoTrace: Representing and Comparing Answering Strategies of Humans and LLMs исследует, как люди и модели выбирают способ ответить на вопрос. Можно сразу дать объяснение, запросить уточнение, оспорить предпосылку или привести дополнительный контекст. Авторы описывают ответ как последовательность таких коммуникативных действий и связывают каждое с определенной интерпретацией вопроса.
На почти 19 тысячах ответов из девяти сообществ Reddit авторы показывают: люди используют разные стратегии в зависимости от норм сообщества, а выбранные LLM отвечают гораздо более однообразно. При этом модели часто охватывают множество возможных трактовок вопроса, тогда как люди выбирают несколько и раскрывают их глубже. Даже инструкции подражать конкретному сообществу не устраняют эти различия.
Обосновывая награду, комитет отметил выявленное ограниченное разнообразие стратегий LLM и новую, основанную на анализе дискурса, систему их описания. Она помогает понимать поведение моделей и разрабатывать ответы лучше соответствующие цели разговора. Это прямой пример лингвистики для понимания LLM и отсылка к актуальности keynote, описанной выше.
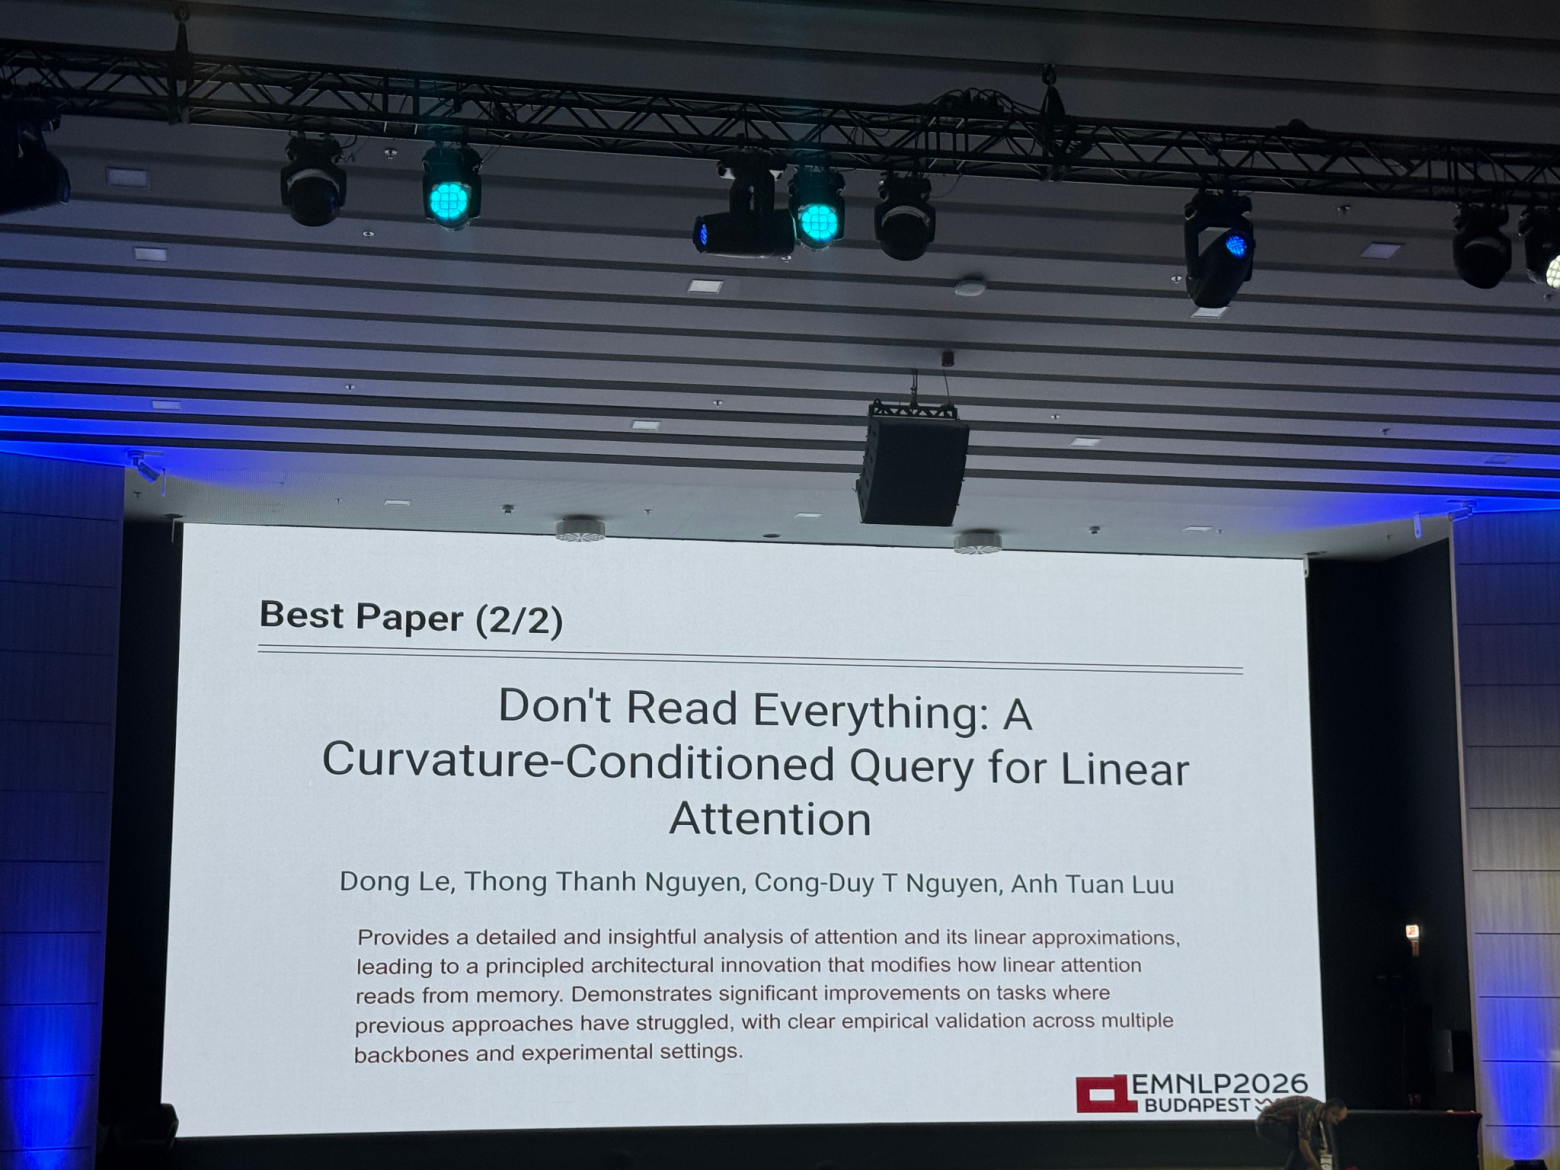
Don’t Read Everything: A Curvature‑Conditioned Query for Linear Attention исследует, как сделать извлечение информации из памяти в linear attention более точным. Обычный softmax attention сопоставляет запрос с отдельными позициями контекста. Linear attention объединяет прошлые ключи и значения в компактную матрицу памяти, что позволяет избежать квадратичного роста вычислений. Однако вклады разных фрагментов смешиваются, и нужную информацию становится труднее выделить.
Авторы предлагают Curvature‑Conditioned Query, CCQ — корректировать вектор запроса перед чтением памяти. Для этого они отслеживают ковариацию ключей: она показывает, по каким направлениям их представления сильнее всего варьируются. CCQ ослабляет соответствующие компоненты запроса, уменьшая влияние доминирующего фона. Такой способ коррекции мотивирован анализом локальной геометрии softmax. Правило записи информации в память остаётся прежним.
Метод проверили на GLA — Gated Linear Attention — и Gated DeltaNet, каждую архитектуру — в размерах 500 млн и 1,3 млрд параметров. CCQ улучшает извлечение информации и работу с длинным контекстом. Например, у GLA-1.3B точность поиска скрытого ключа в контексте 4K выросла с 47,8% до 96,8%. Линейное масштабирование сохраняется, хотя коррекция требует дополнительных вычислений.
Обосновывая награду, комитет отметил глубокий анализ attention и его линейных приближений, который привёл к обоснованному изменению механизма чтения памяти. Отдельно подчеркнули значительные улучшения на задачах, вызывавших трудности у предыдущих подходов, и убедительную проверку на разных архитектурах и экспериментальных условиях. Это пример математического понимания модели, которое приводит к практическому улучшению её архитектуры.
Про наши работы
На EMNLP мы представили две работы о надёжности LLM: ToolHACE вошла в Findings, а Structural Signatures — в программу воркшопа MathNLP. Обе статьи написаны в лаборатории AIRI «Вычислительная семантика», которой руководит Александр Панченко.
ToolHACE: A Dataset for Detecting Hallucinations in Tool‑Based LLM Responses.
Авторы: Nikolay Ivanov, Sergey Pletenev, Elisei Rykov, Anatolii Frolov, Bogdan Monogov, Alexander Potekhin, Maria Marina, Daniil Moskovskiy,Viktor Moskvoretskii, Alexander Panchenko, and Ilseyar Alimova
Обычно работу LLM с инструментами оценивают по тому, правильно ли модель выбрала тул и передала аргументы. Но даже после успешного вызова она может исказить полученные данные в ответе пользователю. Именно для поиска таких ошибок мы создали бенчмарк ToolHACE.
Мы выделяем четыре типа ошибок: Answer Mismatch — несоответствие ответа LLM и данных, полученных при вызове тула; Overgeneration — дополнительная информация, которая не была представлена в туле и которую LLM сгенерила дополнительно; Undergeneration — случай, когда в финальной генерации отсутствует часть информации из вызова тула; Missing Tool — предложение выполнить действие, для которого нет доступного инструмента. Для всех типов ошибок, кроме undergeneration, мы размечаем типы ошибок и поспаново выделяем фрагмент генерации, где данная ошибка находится.
В датасете 48 741 примеров. Синтетические ошибки создавали на основе диалогов ToolACE: с помощью GPT‑OSS-120B и программных правок меняли значения в результатах инструментов, удаляли поля или добавляли неподтверждённые действия, как в missing tool. Это позволяло контролировать, где и почему ответ становится неверным.
Отдельно собрали естественные ошибки четырёх моделей семейств Llama, Qwen и Gemma. Им дали 2 500 диалогов ToolACE с готовыми результатами инструментов, убрали исходные финальные ответы и попросили написать новые. Указания ошибаться модели не получали; ошибки затем выявляли модели‑судьи.
Распределения типов ошибок оказались сопоставимыми с синтетическими, хотя пропуски встречались чаще в естественных ответах: 32,7% против 22,2% в синтетической выборке. Такое сравнение нужно, чтобы детектор учился замечать сбои моделей, а не особенности нашего способа создания данных.
Лучше всего ошибочные фрагменты находили детекторы, дообученные на ToolHACE: Qwen3.5–2B‑LoRA получил 79,28 F1, Qwen3.5–0.8B‑LoRA — 76,41, ModernBERT‑large — 70,72. Лучший вариант без дообучения, Kimi 2.5, набрал 67,74.
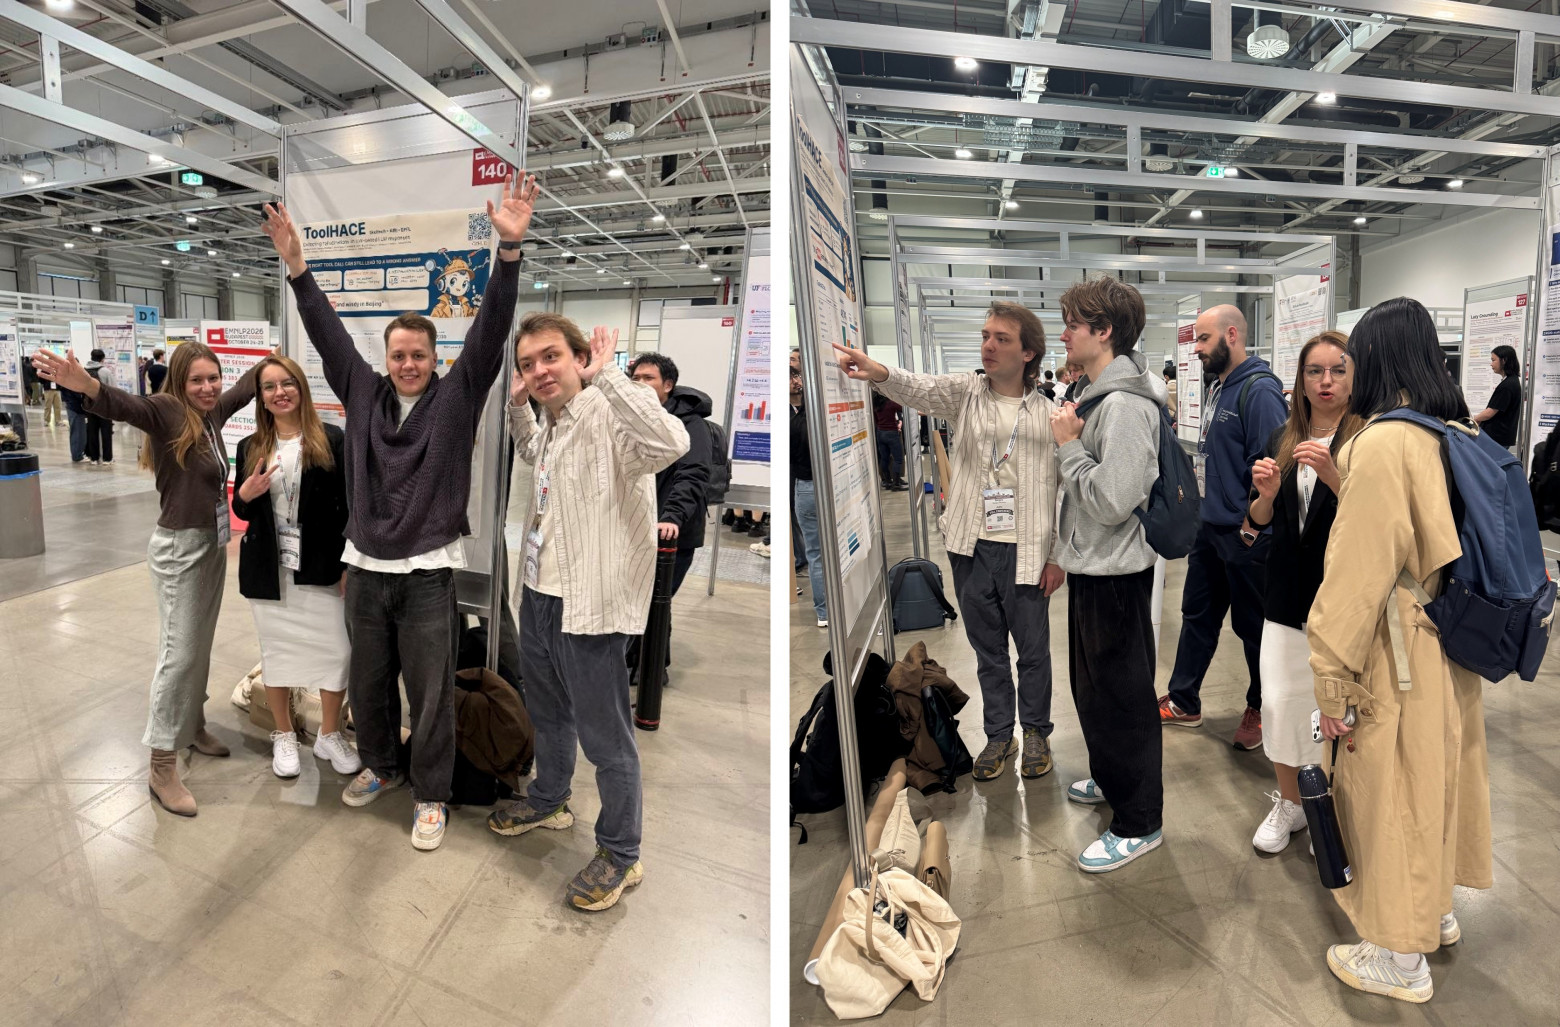
Команда с постером ToolHACE и ответы на вопросы страждущих
Structural Signatures of Correct Mathematical Reasoning Traces.
Авторы: Maria Marina and Alexander Panchenko
Среди множества моделей и бенчмарков было показано, что self‑consistency повышает точность модели: она генерирует несколько цепочек рассуждений, а итоговый ответ выбирается большинством голосов (majority vote). При этом сам ход решения не учитывается. Наша гипотеза: правильные цепочки чаще сохраняют ключевые математические шаги и их порядок, но проходят между ними разными путями — например, A → B или A → D → B. Ошибочные же цепочки могут раз за разом воспроизводить один и тот же шаблон: A → D → E. Вспомните любую сложную задачу по математике из старшей школы: очень часто у решения существует как алгебраическое, так и геометрическое решение, и несмотря на то, что решения эти могут быть очень разными, есть что‑то, что их объединяет — а именно одинаковые промежуточные шаги/вычисления.
Мы группируем решения по ответу и строим графы: вершины объединяют повторяющиеся по смыслу шаги, а рёбра отражают устойчивые переходы, встречающиеся и напрямую, и через промежуточные шаги.
Ответ выбираем по excess edges per trace — числу связей сверх остовного дерева в расчёте на одну цепочку. Интуиция тут следующая: мы пытаемся максимизировать количество альтернативных путей между ключевыми шагами рассуждения. Для связной компоненты  число таких связей равно
 , а оценка ответа a —
 :
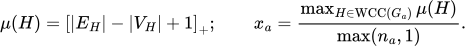
Здесь  и
 — числа рёбер и вершин;
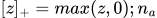 — число цепочек с ответом
 а
 — их граф. Берём компоненту с максимальным
 и нормируем оценку, чтобы частые ответы не получали преимущество только за счёт числа решений.
 обозначает компоненты, связные без учёта направления рёбер.
Оценку усредняем по пяти последним размерам набора решений и выбираем максимальную среди ответов, встретившихся хотя бы дважды. При равенстве оценок побеждает более частый ответ.
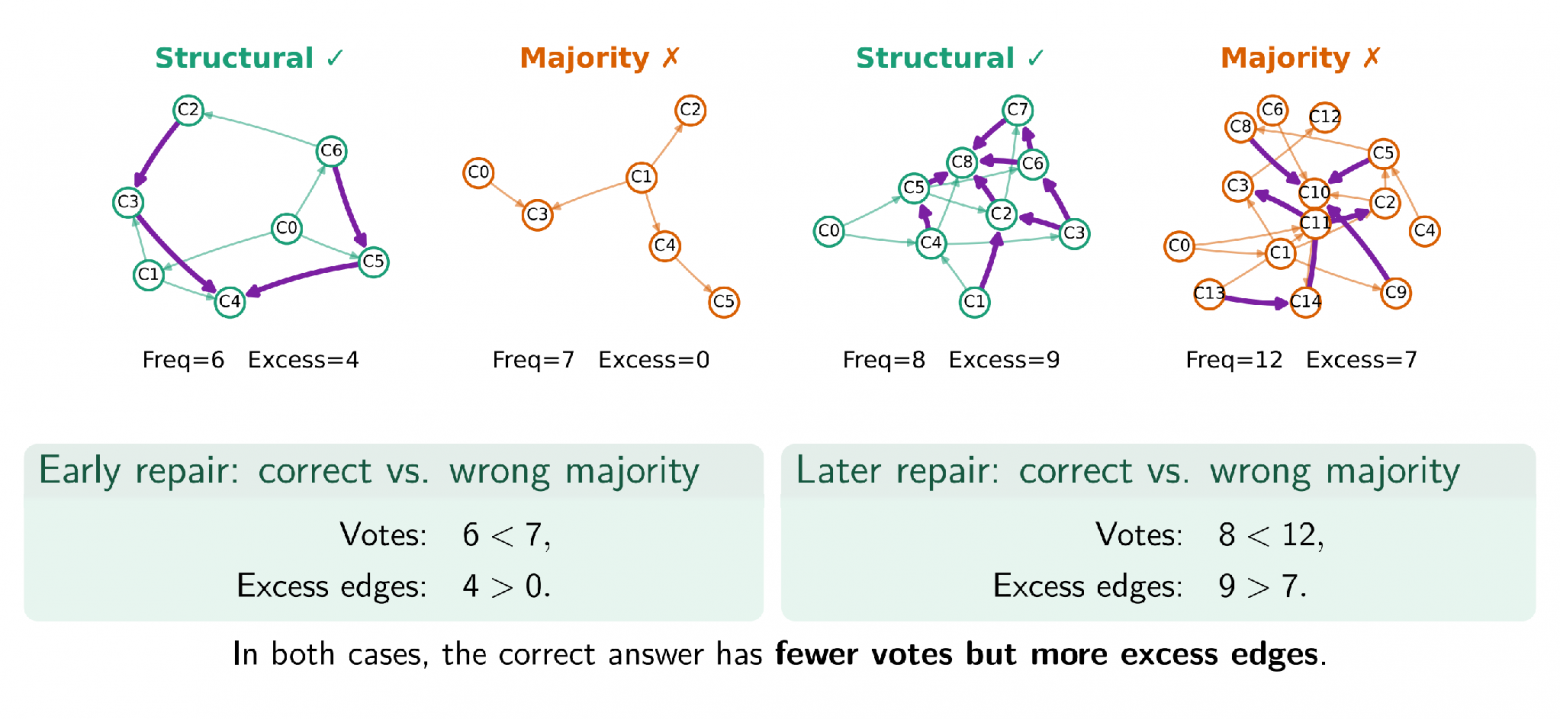
Правильные ответы получили меньше голосов, но больше дополнительных связей. Фиолетовым показаны связи сверх остовного дерева.
На MATH500 с Llama-3.1–8B‑Instruct максимальный выигрыш относительно голосования составил 2 процентных пункта — 10 дополнительных решённых задач из 500.
Для меня особенно важна интерпретируемость: в графе видны общие шаги, развилки и разные пути к одному результату. В перспективе такая схема могла бы помогать ученику разбирать математику прямо во время решения: видеть связи между действиями и раскрывать непонятные переходы подробнее.
На воркшопе MathNLP для устных докладов (oral) отобрали 8 из 31 принятой работы — в том числе нашу! Для меня это был первый oral, и я очень рада этому опыту.
Отвечаю на вопросы после презентации, спасибо организаторам за красивый свет в аудитории
Золотая осень в Будапеште
Как и в Москве, в Будапеште была прекрасная погода, поэтому в перерывах и после утомительных дней конференции удалось насладиться видами Будапешта, архитектурой, едой и Дунаем.
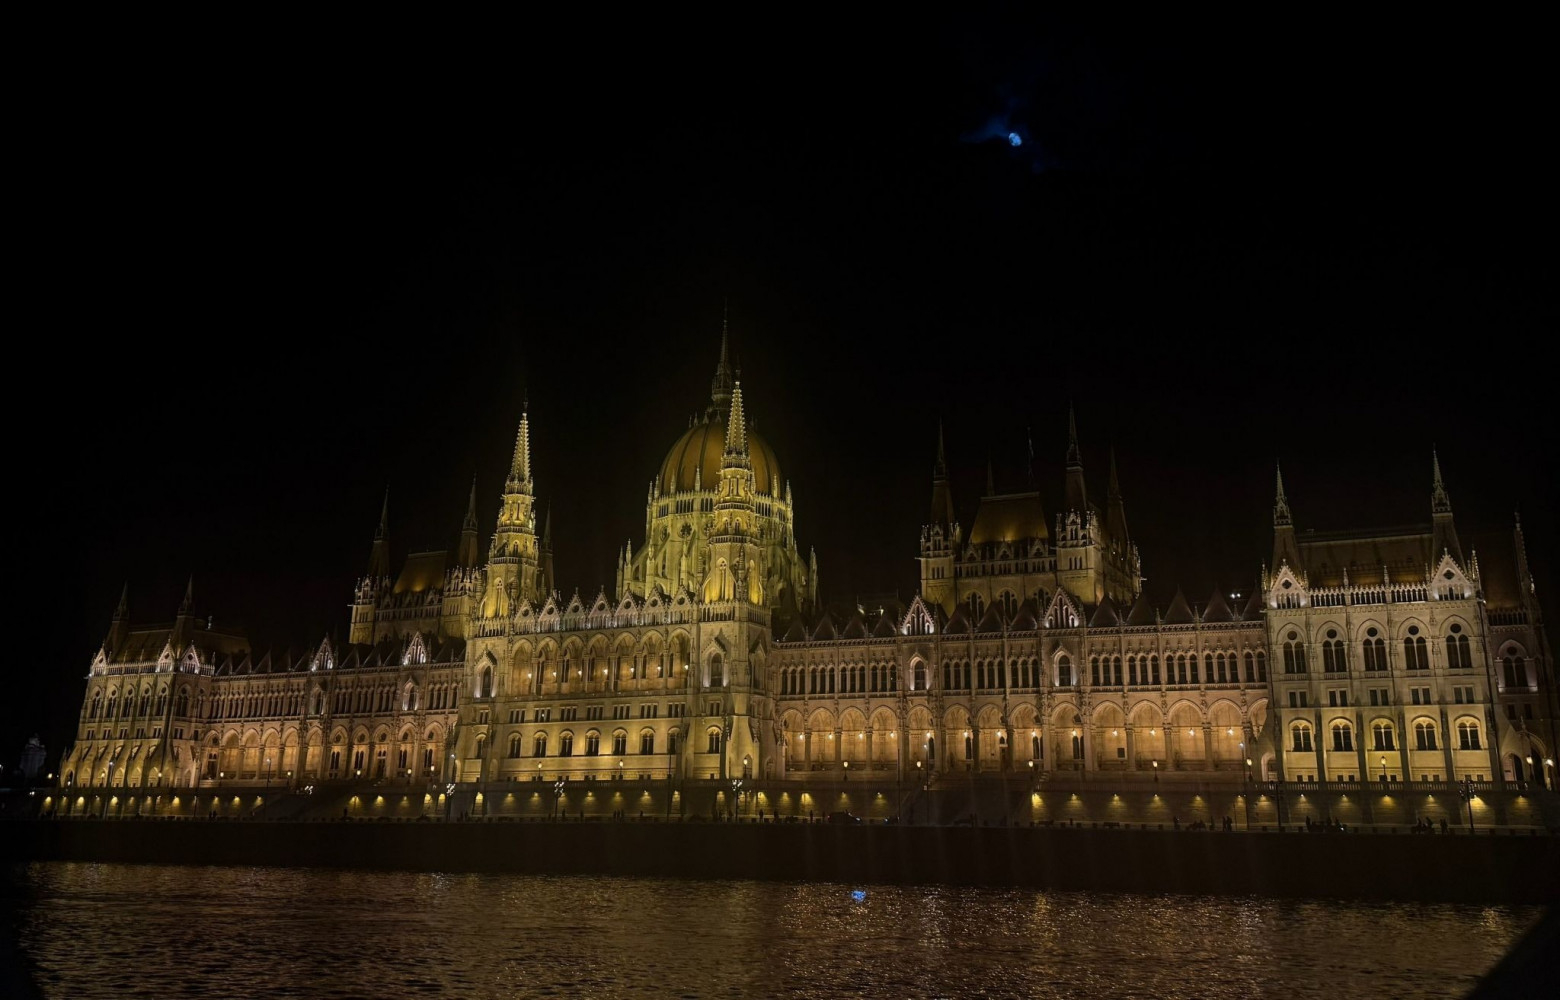
Здание венгерского парламента — величественный символ Будапешта и один из главных архитектурных шедевров Европы
Хотя уже первые впечатления подарил отель Oktogon, куда мы заселились. Он был открыт в стенах дворца Хагенмахер — живописного исторического здания конца XIX века.
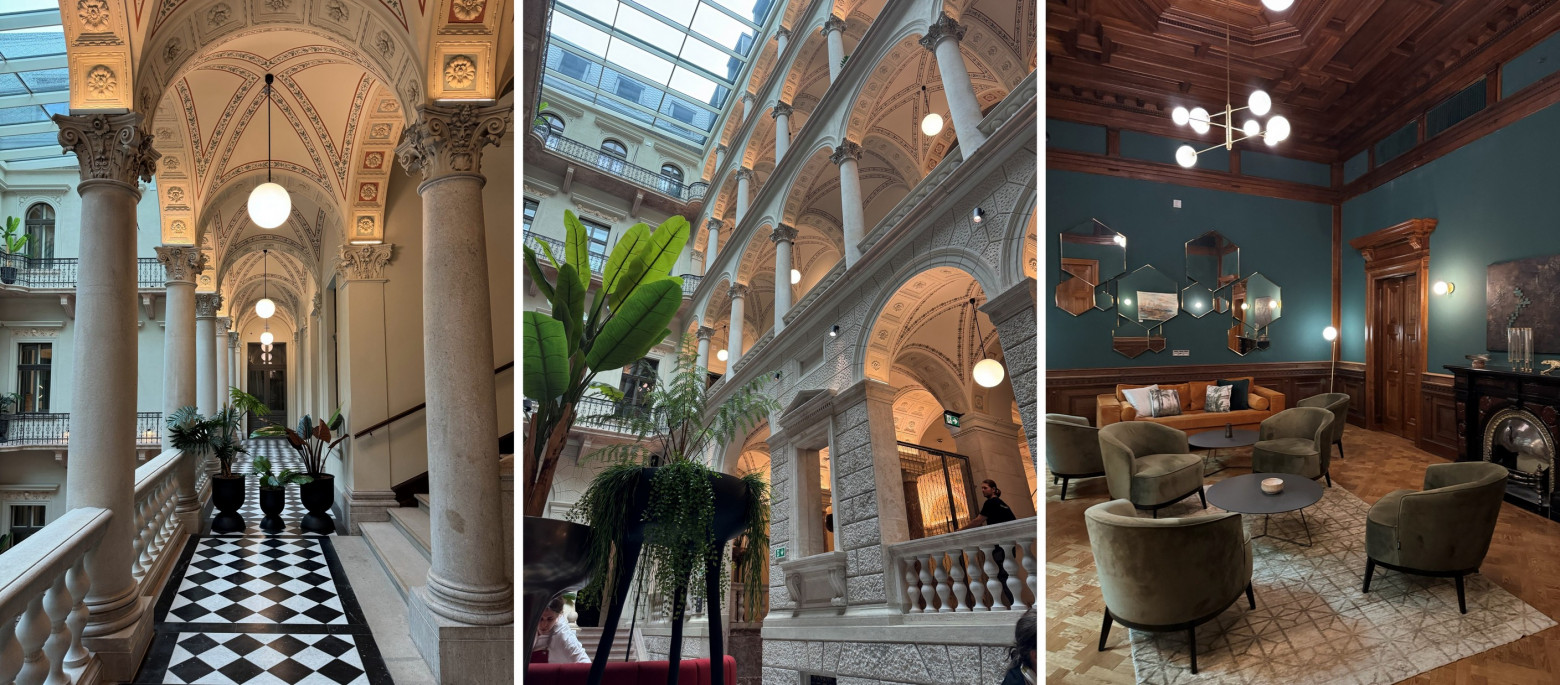
Интерьеры отеля Oktogon и его лаунж‑зона, где я делала свою презентацию для орала
Далее — мои топ-4 впечатления о Будапеште.
Во‑первых — термы. Мы были в купальне Сеченьи (Széchenyi fürdő) — крупнейшем лечебном термальном комплексе Европы, расположенном в Городском парке (Варошлигет) Будапешта. Вода поступает из скважины Св. Иштвана (глубина 1256 м) с температурой до 77 °C. В открытых термальных бассейнах температура поддерживается на уровне до 38 °C. Говорят, что есть знаменитая традиция — в открытых горячих бассейнах местные жители и туристы играют в шахматы на плавучих досках, но мы лично такого не видели.
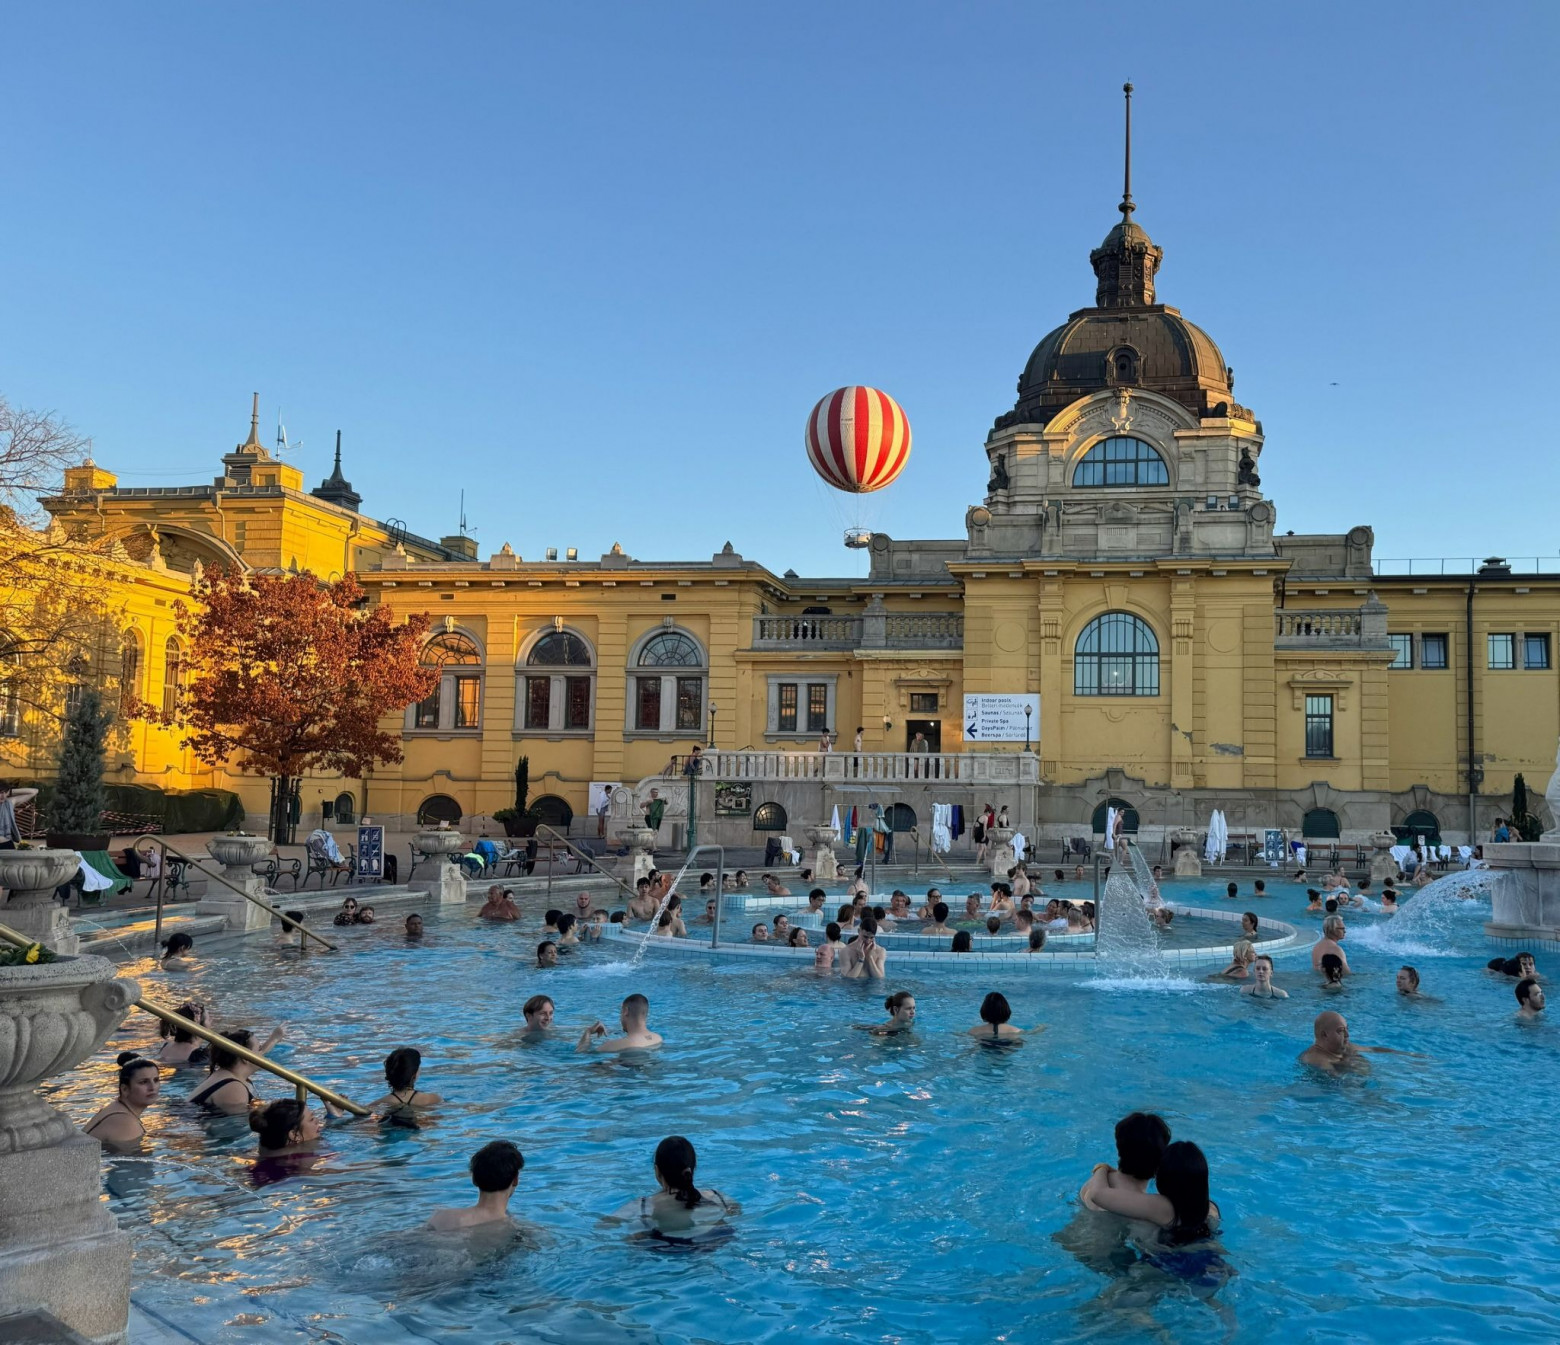
Купальня Сеченьи в центре Будапешта
Во‑вторых, прогулки по улочкам рыбацкого бастиона. Дома перемежаются с зеленью, которую осень раскрасила в разные краски, и прогулки очень разгружают голову после конференции.
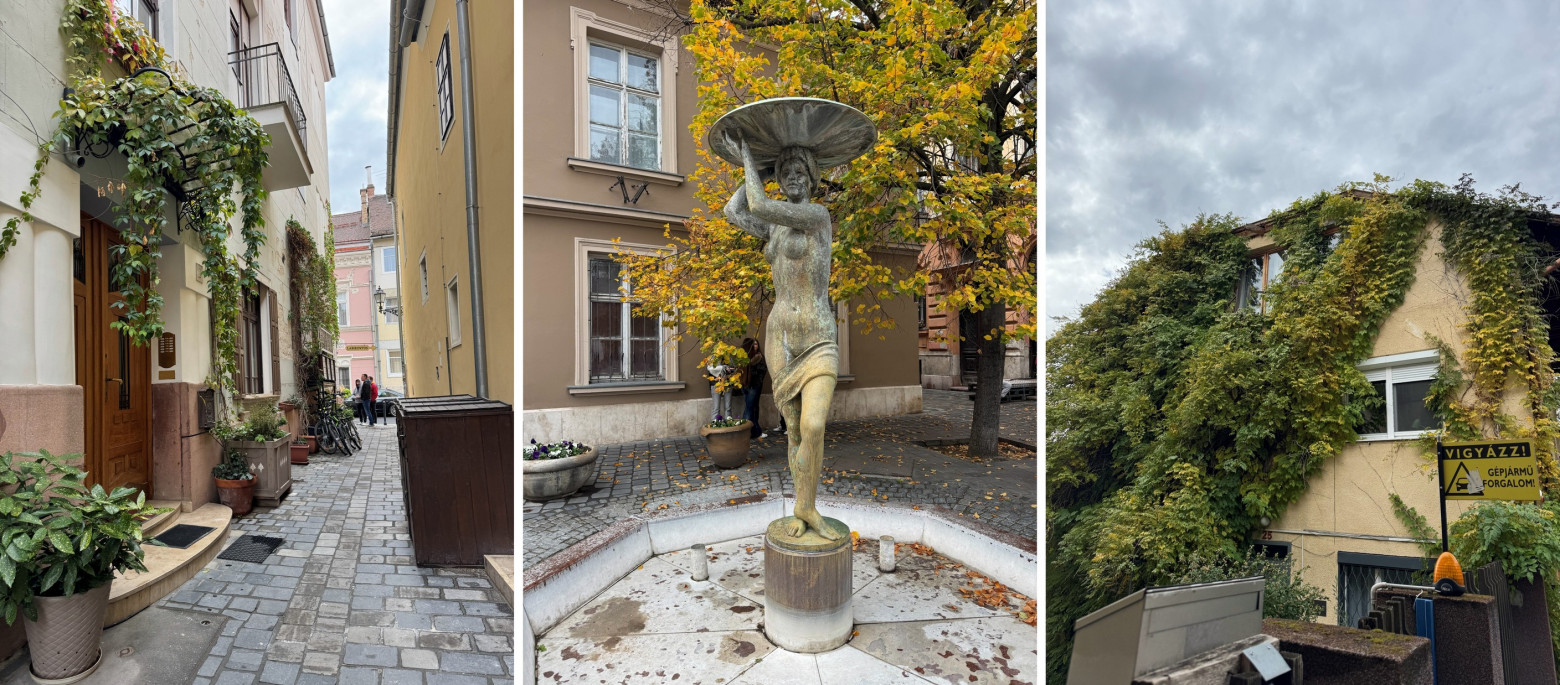
Зеленые улочки Будапешта около Бастиона
В‑третьих, знаменитое кафе «Нью‑Йорк» (New York Café). Говорят, кафе входит в пятерку самых красивых кафе мира. Здание было построено в духе итальянского Ренессанса, внутреннее убранство — парад исторической эклектики: живописные панно на потолке, мрамор и бронза, шёлк и бархат, удивительные светильники из венецианского стекла и даже фонтан у входа.
Городская легенда гласит, что в день открытия один из журналистов, Ференц Мольнар намеренно бросил ключи в Дунай, загадав желание, чтобы двери кафе больше никогда не закрывались. Помимо убранства, где‑то 10–15 минут в час играет живая музыка, один раз при мне даже музыкант сыграл на скрипке “Happy Birthday” для именинницы за соседним столиком. Из еды запомнилось каппучино с 24-каратным золотом (без золота не наливают) и венгерский торт «Добош», не приторный и в меру сладкий.
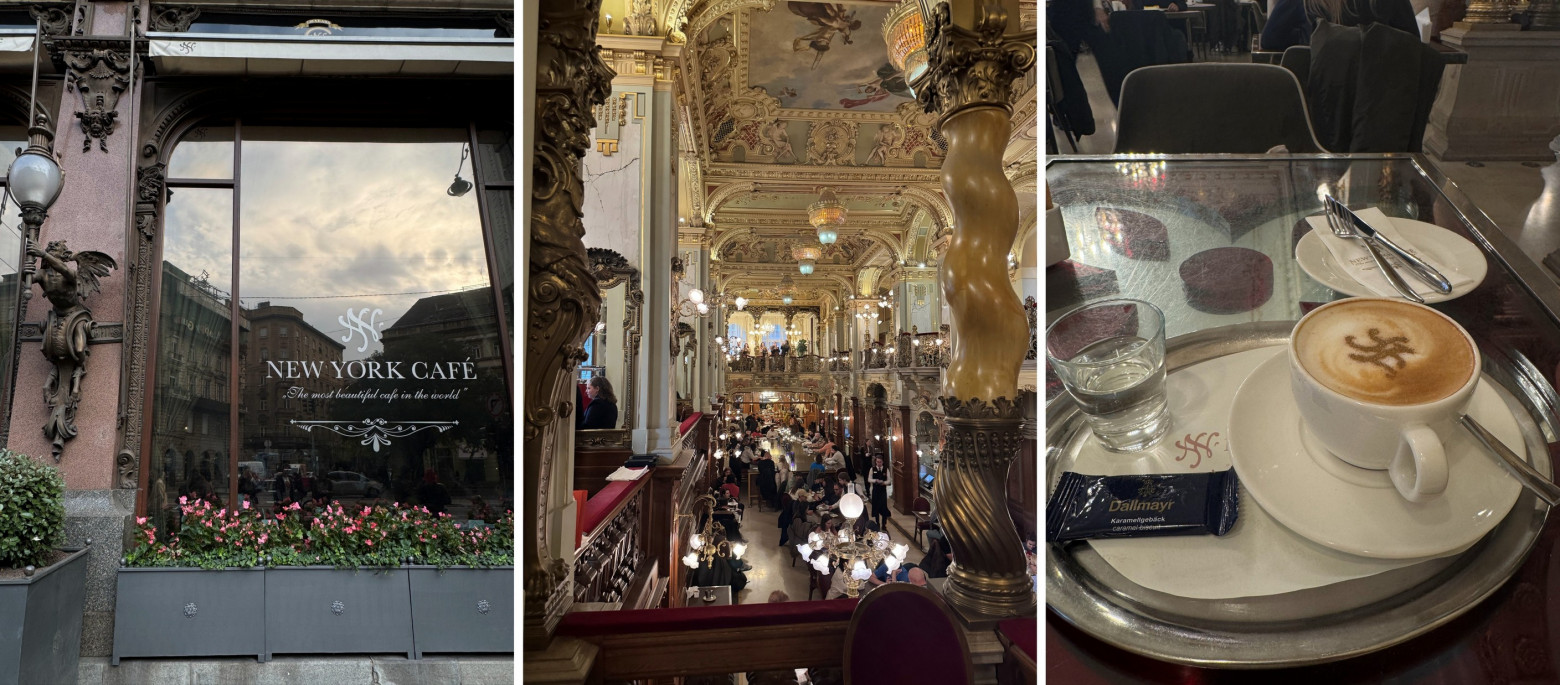
Кафе «Нью‑Йорк» снаружи и внутри, а также Каппучино с 24-каратным золотом
Наконец, базилика Святого Стефана, которая хороша и днем и ночью. Когда я вошла внутрь крупнейшего кафедрального собора Будапешта, музыканты готовились к вечернему органному концерту, и сочетание великолепия убранства и этой музыки правда было неописуемо красивым. Я бы вернулась туда на органный концерт, если была бы такая возможность. Перед выходом заметила над витражом надпись “scientia”, что с латинского переводится как «знание», «познание» и «наука». Думаю, это хороший знак!
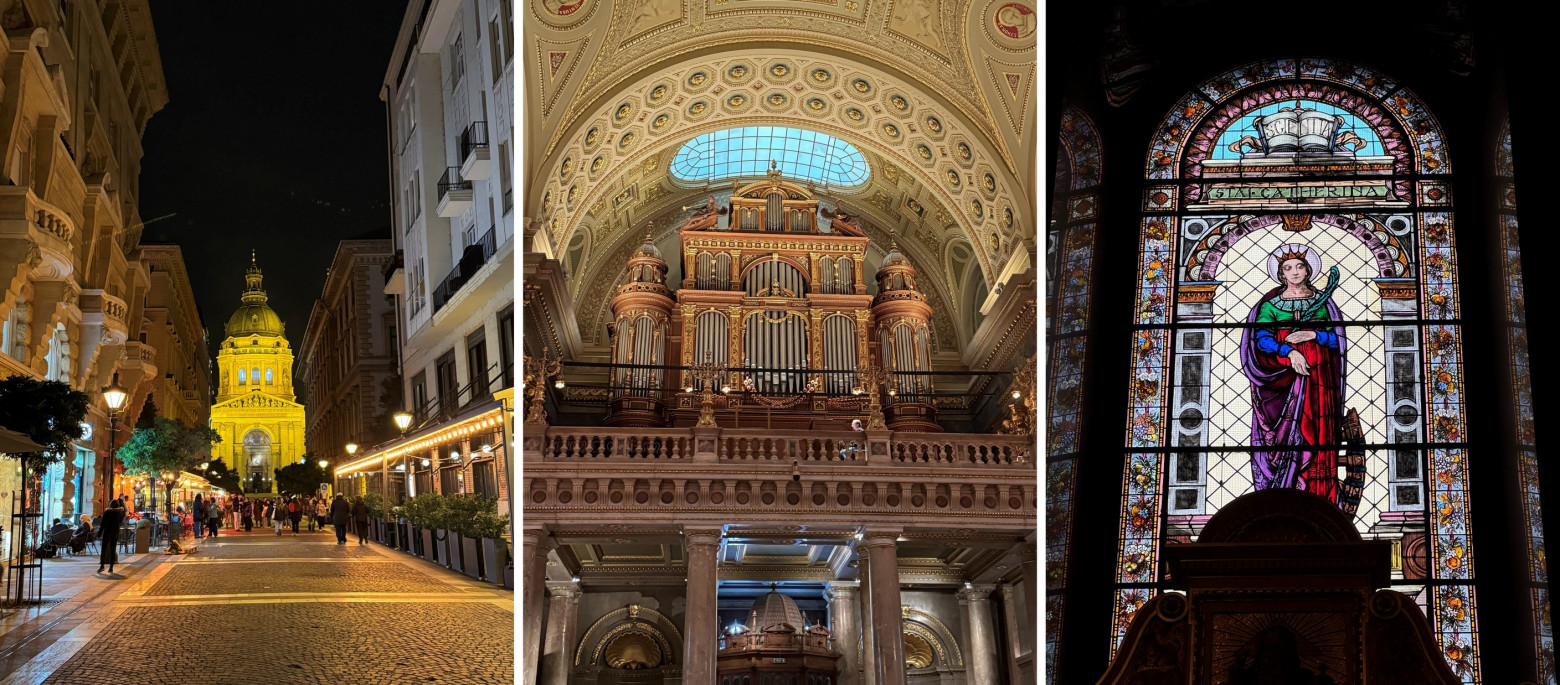
Базилика Святого Стефана внутри и снаружи
Еда
Как мне кажется, два кулинарных знака отличия, которые являются визитными карточками Будапешта — трдельники и гуляш. Гуляш едят как суп, как второе, острый и средне‑острый, в хлебе и без. Трдельники мы видели только сладкие, но на мой вкус почти все были сладкими уж чересчур, так что берите с яблоком, если захотите чуть сбавить градус.
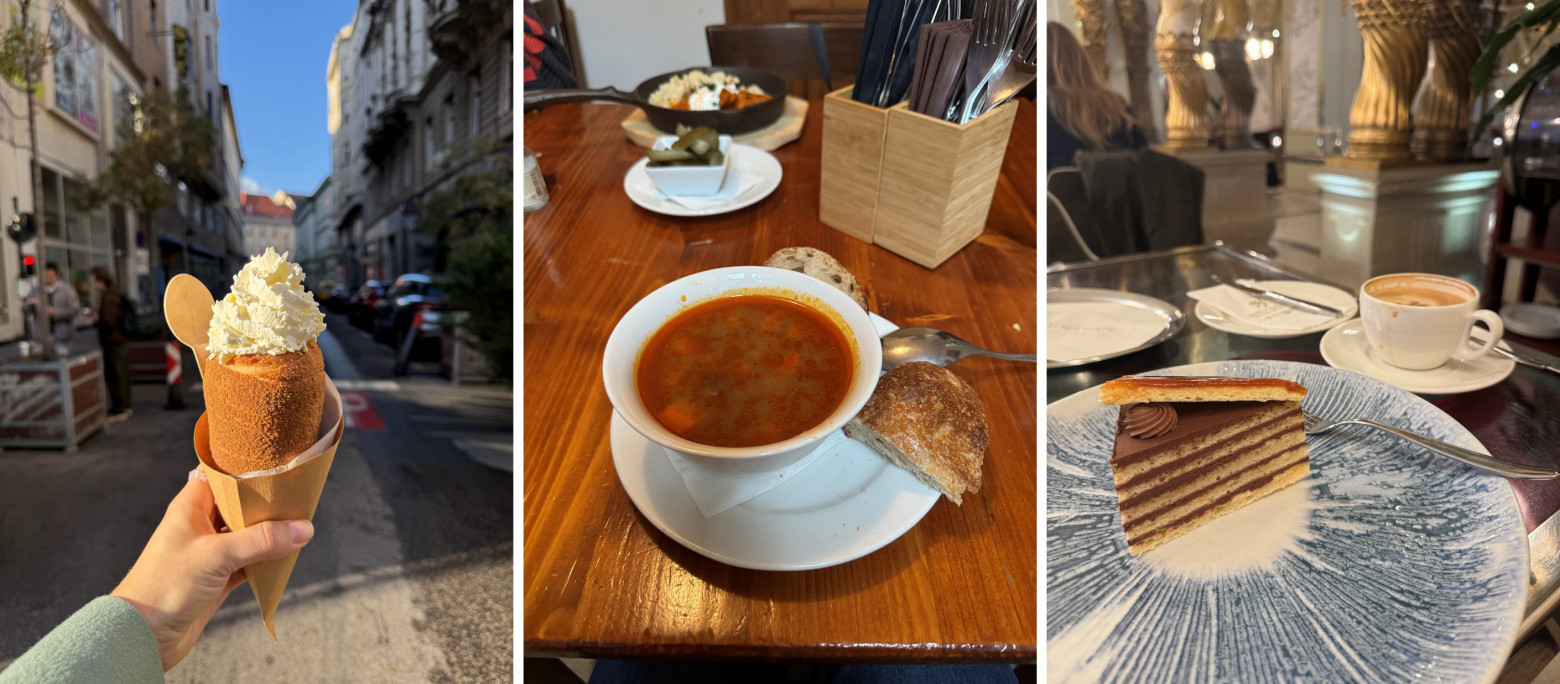
Его величество трдельник, его светлость гуляш, а также традиционный венгерский торт «Добош»
Вместо заключения
В кулуарных разговорах часто слышу идею, о том, что неплохо было бы иметь запасной план Б — освоить пост‑AGI профессию. Хотя я отношу себя скорее к техно‑оптимистам, кто знает, что нас ждет впереди — так что подавайтесь на EMNLP 2027! Кстати, она будет в Мексике.
Если вы студент, то советую Student Research Workshop, где ментор может дать вам фидбэк, если вы из индустрии — есть Industry track. Когда‑то после Всероссийской олимпиады по экономике я поняла, что это был очень классный опыт, и после школы уже будет невозможно его повторить. Если вы никогда не были на большой конференции, но вам есть чем поделиться, обязательно подавайтесь, этот опыт того стоит.
P. S. Подписывайтесь на мой канал, где я пишу о том, что мы изучаем и как я живу жизнь ученого.


Для участия в Чате вам необходим бесплатный аккаунт pro-blockchain.com
Войти
Регистрация
Похожие новости
Подпишись на telegram канал и узнавай первым обо всех новостях