 Русский
 English
Cryptocurrencies:
8058 /
Markets: 109772
Market Cap: $ 2 607 674 897 880 /
24h Vol: $ 47 593 691 611 /
BTC
Dominance: 59.963268308766%
Новости
Медиана решения обращений упала с 22 часов до 22 минут. Почему мы всё равно не считаем внедрение завершённым
В предыдущей статье (https://habr.com/ru/articles/1075720/) я рассказывала, как начала внедрять цифровых сотрудников в подразделение поддержки (компания занимается разработкой, внедрением и поддержкой ПО для автоматизации дистрибуции). Сначала сделали помощника инженера, потом стали передавать агентам часть клиентских обращений. Тогда я привела первые результаты: около 45% переданных диалогов завершались без участия инженера.
После публикации я решила глубже разобраться, что на самом деле изменилось для пользователей. Процент автоматически решённых обращений удобен для презентации, но сам по себе мало что говорит о качестве поддержки. Агент может быстро закрыть простое обращение. Может передать сложное человеку, предварительно собрав все данные. А может уверенно дать неправильный ответ и тоже поставить статус «решено».
На этот раз я решила посмотреть не только на финальное действие агента, а на полную историю обращений: когда пользователь получил содержательное решение, сколько времени обращение оставалось без движения, что происходило после передачи инженеру и не стало ли ускорение причиной новых ошибок.
Получилась очень красивая цифра. Медианное время до фактического решения сократилось примерно в 59 раз: с 21 часа 52 минут до 22 минут.
Но чем красивее цифра, тем осторожнее с ней нужно обращаться.
Что именно мы сравнивали
Массово агент вышел в клиентский поток 16 июля 2026 года. Для сравнения мы взяли два одинаковых периода:
• до запуска: с 16 июня по 15 июля;
• после запуска: с 17 июля по 15 августа;
• сам день запуска исключили, потому что в нём смешались два режима работы.
В выборку попали только закрытые обращения без дублей: 1 876 до запуска и 3 078 после. Это не нормализованные по темам выборки: в них различаются объём потока, состав тем и доля массовых инцидентов.
Массовые инциденты мы не исключали из основной выборки: для пользователя это такая же часть реальной поддержки. Но учитываем их отдельно в интерпретации, потому что один согласованный ответ на множество одинаковых обращений способен заметно сдвинуть скорость и долю автоматических решений. Поэтому это описание изменений процесса, а не эксперимент, который доказывает причинный эффект агента.
Это тоже ограничение. Обращения, которые оставались открытыми на конец периода, в расчёт не вошли. Значит, часть самого длинного хвоста могла остаться за пределами выборки.
Кроме того, изменились объём потока, состав тем и количество массовых инцидентов.
Вот что получилось:
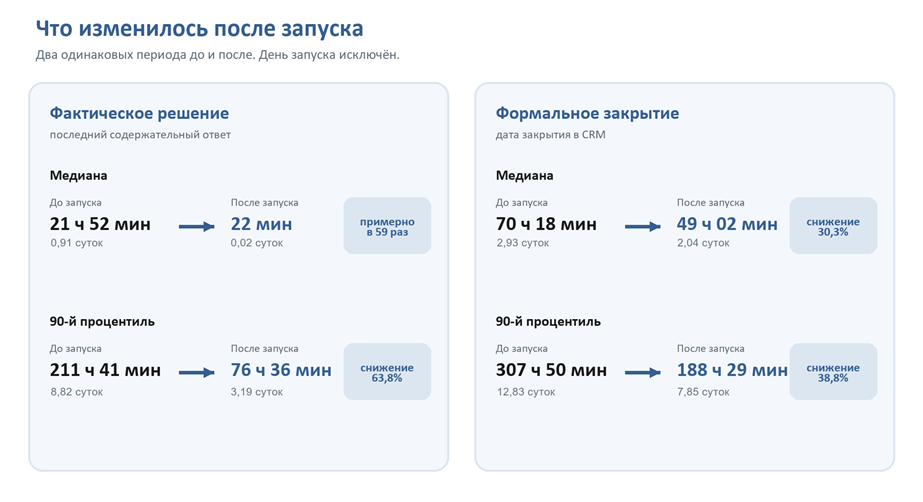
Рисунок 1. Время до фактического решения и формального закрытия
Для фактического решения медиана сократилась с 21 часа 52 минут до 22 минут, 90-й процентиль с 211 часов 41 минуты до 76 часов 36 минут. Для формального закрытия медиана сократилась с 70 часов 18 минут до 49 часов 2 минут, 90-й процентиль с 307 часов 50 минут до 188 часов 29 минут.
Все интервалы в статье — календарные, а не рабочие часы. Медиана показывает середину выборки: половина обращений решилась быстрее этого времени, а половина медленнее. 90-й процентиль помогает увидеть хвост: время, в которое уложились 90% обращений.
Для меня важны оба показателя. Одна медиана легко скрывает тяжёлые случаи.
В этих данных типовое обращение после запуска стало двигаться значительно быстрее, но длинный хвост никуда не исчез. Просто он тоже сократился.
Три режима, которые нельзя смешивать
Внутри платформы параллельно работают три контура: консультант инженера в виде виджета в интерфейсе CRM, самостоятельная обработка обращений цифровым сотрудником и автоматические подсказки по обращениям для инженеров поддержки, которые инициатору обращения не передаются.
За шесть недель с 20 июля по 30 августа цифровой консультант получил 1 934 вопроса от инженеров, агент самостоятельно обработал 3 558 обращений, а по 1 208 обращениям инженеры получили автоматические подсказки.
Складывать эти числа нельзя. Это разные сценарии, и одно обращение может пройти через несколько контуров.
Дальше в статье, когда я говорю об обращениях после запуска и о доле решений, речь идёт только о самостоятельной обработке обращений цифровым сотрудником.
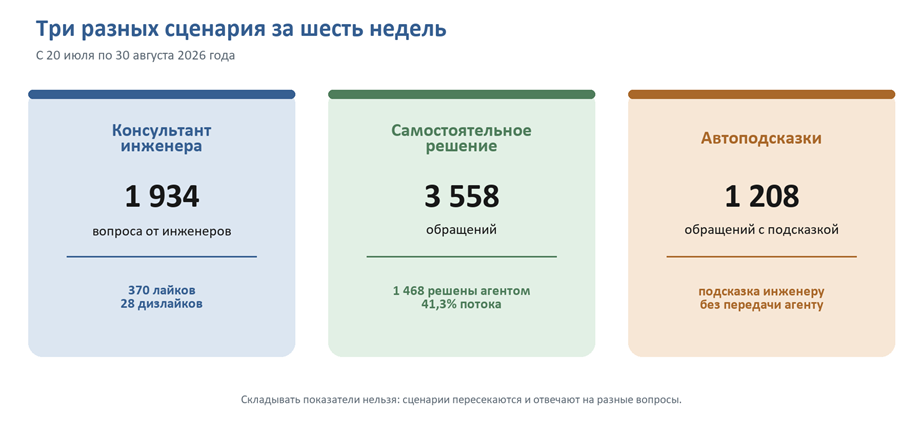
Рисунок 2. Три сценария работы платформы за шесть недель
Почему формальная дата закрытия обращения врёт
Сначала мы собирались сравнивать обычное время от регистрации до закрытия. Это самое простое: обе даты уже есть в CRM, ничего дополнительно вычислять не нужно.
Потом посмотрели реальные диалоги и поняли, что так мы измеряем не решение проблемы, а особенности нашего процесса закрытия.
Например, агент дал пользователю инструкцию через 12 минут. Пользователь выполнил её, написал «спасибо», но обращение ещё двое суток оставалось открытым и закрылось автоматически. По данным CRM решение заняло больше двух дней. Для пользователя это 12 минут.
Бывает и наоборот. Инженер переводит обращение в другой статус (например, ожидания из-за времени поддержки клиента), хотя содержательного ответа ещё нет. Формально карточка двигается, фактически пользователь продолжает ждать.
За точку завершения брали последний содержательный ответ агента или инженера до технического хвоста — но только если этот ответ давал пользователю самостоятельное решение или согласованный статус известного инцидента.
Не считали решением:
• благодарность пользователя;
• автоматическое закрытие;
• вопрос «остались ли у вас вопросы?»;
• прикрепление файла или смену статуса без ответа;
• внутренний комментарий куратора;
• запрос логов или дополнительных данных, если после него было отдельное содержательное решение.
Метод тоже не идеальный. Содержательность комментария приходится определять по правилам, а в нестандартном диалоге граница может быть спорной. Но он намного ближе к тому, что происходит с пользователем, чем поле «дата закрытия».
Разрыв между двумя метриками — это и показывает. Медиана реального решения после запуска составила 22 минуты, а формального закрытия — 49 часов. Большая часть этого времени ушла не на работу над проблемой, а на ожидание подтверждения или автоматического завершения обращения.
Что происходило с обращениями после запуска
Мы разделили 3 078 закрытых обращений после запуска по маршруту обработки. Из 3 078 обращений цифровой агент решил 1 647, эскалировал инженеру 743, ещё 688 по разным причинам не передавались агенту. Для каждого маршрута показаны медиана и 90-й процентиль времени до фактического решения.
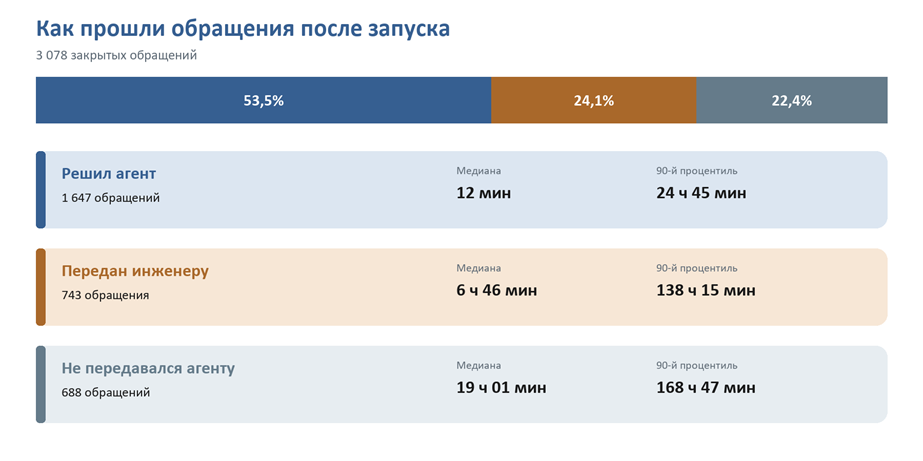
Рисунок 3. Маршруты обращений после запуска
Эти цифры легко прочитать как «агент в 53,5% случаев заменил инженера». Я бы так не формулировала.
Во-первых, агент получает не случайный набор обращений. Мы сознательно отдаём ему темы, для которых есть данные, понятная диагностика и безопасный сценарий. Сложные или плохо наблюдаемые случаи чаще остаются людям.
Сравнивать 12 минут у агента и 19 часов без него напрямую нельзя: задачи у них разные.
Во-вторых, часть быстрых решений пришлась на массовые инциденты. Когда причина уже известна и согласован ответ, агент способен одновременно уведомить большое количество пользователей. Это реальная польза, но такой период резко повышает долю автоматического решения.
В-третьих, передачу инженеру не обязательно считать неудачей. Если агент проверил доступные источники, запросил недостающие данные и подготовил нормальную эскалацию, инженер начинает не с пустой карточки. Медиана таких обращений составляет 6 часов 46 минут, то есть заметно меньше, чем у потока, который вообще не проходил через агента. Но и здесь нельзя отделить вклад агента от различий в темах без отдельного эксперимента.
Есть ещё одна цифра, которую важно не смешивать с этой. В первой статье было 44,6% решённых диалогов.
Там мы считали пять недель, брали только уникальные CRM-диалоги, обработанные агентным контуром, и определяли результат по последнему корректному действию агента.
Здесь 53,5% означает долю закрытых обращений в другом периоде и другой выборке, которые прошли по маршруту «агент решил».
Это разные знаменатели и разные правила подсчёта. Рост с 44,6 до 53,5% по ним доказывать нельзя.
Самый неприятный вывод: быстрее не всегда значит лучше
После запуска мы много меняли инструкции, инструменты и порядок диагностики. Почти каждое изменение выглядело логичным: убрать лишние действия, сделать поиск точнее, сократить число запросов, не позволять агенту строить догадки без данных.
Но логичное изменение на одном обращении иногда ломало другое.
Когда мы заметили, что очередное изменение поменяло не только скорость, но и качество ответа, мы взяли десять старых (решённых) обращений и повторно прогнали их через обновлённую версию агента, не отправляя ответы клиентам. Затем сравнили новые ответы с теми, которые агент давал раньше.
Это был не готовый регрессионный контур и не статистически достаточная оценка, а первый контрольный набор, который мы собрали уже после нескольких изменений. Как раз это и стало выводом: без заранее подготовленных кейсов легко ускорить поведение, которое на реальном обращении окажется хуже.
Результат оказался не таким аккуратным, как хотелось бы:
• в пяти случаях новая версия ответила лучше;
• в двух случаях результат был примерно тем же;
• в одном результат был смешанным;
• в двух новая версия стала хуже.
Причём оба ухудшившихся ответа были получены быстрее прежних. В одном случае время сократилось примерно с семи до трёх минут, а в другом с пяти до двух.
Если смотреть только на скорость и на то, что запуск завершился без ошибки, изменение можно было бы признать успешным.
По сути, мы ускорили неправильное поведение.
Как точный поиск перестал понимать человеческие опечатки
Один из регрессионных случаев был связан с кодами объектов. Раньше (до "улучшений" инструкций) цифровой агент, используя LLM, пытался распознать очевидную опечатку пользователя (например, лишний символ в коде при повторяющихся цифрах) и находил нужную запись. После ужесточения правил он стал искать только точное совпадение. Это защищало от ложного сопоставления, но породило другую проблему: код с цифрой 0, латинской O или кириллической О считался совсем другим значением.
В результате обновлённый агент работал быстрее, честно сообщал, что объект не найден, и передавал обращение инженеру. Формально всё безопасно. На практике полезность стала ниже, потому что человек без труда понял бы, где опечатка.
Просто разрешить модели «исправлять похожие коды» мы не хотели: так легко связать обращение не с тем объектом. Поэтому сделали ограниченную коррекцию. Сценарий строит небольшой набор допустимых вариантов. Например, заменяет только 0/O/О или убирает один случайный повтор символа, а затем снова выполняет точный поиск. Исправление принимается только при единственном совпадении. Если подходят два объекта, агент ничего не выбирает и просит уточнение.
Этот случай хорошо изменил моё отношение к слову «детерминированный». Строгое правило само по себе не гарантирует хороший результат. Оно просто делает поведение воспроизводимым. А правильность правила всё равно приходится проверять на реальных ошибках пользователей.
Какие ошибки мы теперь ищем отдельно
Со временем у нас сформировалось несколько классов ошибок. Они опасны тем, что ответ агента внешне выглядит аккуратным и правдоподобным.
Неуспешная проверка не равна отрицательному результату
Инструмент запросил данные и вернул пустой ответ. Причины могут быть разными: записи действительно нет, внешний сервис недоступен, запрос завершился по таймауту, не хватило прав или результат пришёл не полностью.
Для модели всё это раньше могло выглядеть одинаково: «данных нет». Это проявилось, например, при разборе инцидента с обменом. Пустой ответ проверки мог означать и отсутствие записи, и недоступность внешнего сервиса, и таймаут, и неполные права. Но без явного статуса агент мог сделать уверенный вывод, что обмен не выполнялся, настройка отсутствует или объект не существует.
Теперь у каждой проверки есть явный статус: завершилась ли она успешно и можно ли считать результат полным.
Если внешний вызов завершился ошибкой или вернул неоднозначный ответ, агент обязан сказать, что статус установить не удалось. Это менее эффектно, чем готовый диагноз, зато честно.
Правдоподобное техническое объяснение ещё не факт
Модель хорошо продолжает знакомые шаблоны. Если в похожей системе проблема обычно связана с определённой таблицей, настройкой или API, она может предложить очень убедительную конкретику. Иногда даже с названием поля и готовым запросом.
Проблема в том, что убедительность не равна подтверждению. У клиента может быть другая версия, индивидуальная доработка или вообще другой механизм.
Мы ввели простое правило: технический идентификатор можно включать в диагноз только тогда, когда он найден в текущем результате инструмента, документации или проверенной схеме. Аналогия с другим проектом и ответ другой модели источником не считаются. Если причина не установлена, так и пишем и указываем следующую проверку.
Чем больше инструкций, тем труднее предсказать поведение
Когда агент ошибается, естественно дописать ещё один запрет или исключение. Через некоторое время инструкции начинают повторяться и противоречить друг другу. В одном месте написано обязательно назвать наиболее вероятную причину, а в другом нельзя строить гипотезу без подтверждения. Один раздел требует сначала искать в общей документации, другой отправляет начинать с проектной.
Модель каждый раз пытается примирить этот набор правил. Иногда успешно, иногда нет.
Мы несколько раз чистили основные инструкции: убирали дубли, переносили общие правила в единый слой, оставляли в клиентских инструкциях только отличия. Это не самая заметная часть эксплуатации, но без неё каждый новый частный фикс постепенно делает агента менее управляемым.
Корректный служебный результат может быть плохим ответом человеку
После того как мы добились более строгой диагностики, появилась другая крайность. Агент правильно определял действие, собирал факты и формировал хорошую эскалацию, но пользователю отвечал канцелярским шаблоном, иногда повторяя уже сказанное.
То есть технически обращение обработано правильно, а диалог всё равно раздражает.
Мы отдельно смотрим на служебный результат для CRM и на ответ пользователю.
В ответе важны не только факты, но и контекст разговора: не переспрашивать то, что человек уже сообщил, объяснять следующий шаг и не прятать смысл за универсальным «ваш вопрос передан специалистам».
Почему качество агента со временем ухудшается
Поначалу мне казалось: если мы однажды добились хорошего ответа по определённой теме, дальше этот сценарий будет работать так же. Нужно только иногда обновлять документацию.
На практике качество агента не остаётся постоянным, даже если не менять модель.
Обновляется продукт, у клиентов появляются новые настройки, инструкции в базе знаний устаревают, интеграции начинают возвращать другой состав данных.
Меняется и сам поток: после расширения тем приходят формулировки, вложения и опечатки, которых не было в пилоте.
Параллельно мы сами постепенно усложняем агента. Исправили одну ошибку и добавили правило. Нашли исключение и добавили ещё одно. Изменили порядок источников для одного клиента, а это случайно повлияло на общий сценарий. Каждый отдельный фикс выглядит разумным, но их сумма со временем становится новой причиной ошибок.
Хуже всего, что такая деградация не похожа на аварию.
Агент продолжает отвечать и формально завершать запуски. Только чаще просит лишние данные, выбирает более общую эскалацию или выдаёт правдоподобную гипотезу вместо подтверждённого вывода.
По техническому мониторингу всё зелёное, а полезность уже снизилась.
Качество приходится поддерживать отдельно: версионировать инструкции и знания, смотреть не только на ошибки выполнения, переигрывать старые обращения и регулярно разбирать новые.
Выход в боевой режим ничего не фиксирует раз и навсегда. Это просто момент, после которого качество агента либо улучшается, либо постепенно падает.
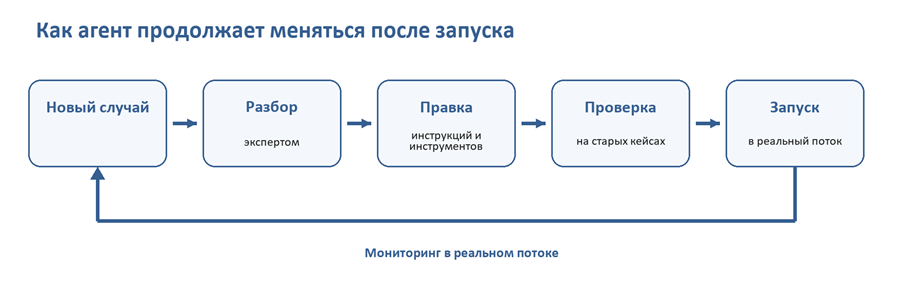
Рисунок 4. Цикл изменений после выхода агента в реальный поток
Старые решённые обращения стали нашими регрессионными тестами
Первые недели мы в основном проверяли свежие ответы вручную. Такой разбор полезен, но у него есть слабое место: сегодня поток один, завтра другой. После изменения инструкции можно не встретить тему, которую оно случайно сломало.
С тех пор реальные обращения, на которых агент уже ошибался или вёл себя неоднозначно, мы сохраняем как тестовые сценарии. Перед заметным изменением повторно запускаем их на новой версии и сравниваем:
• итоговое действие: решение, уточнение или эскалация;
• подтверждённые факты;
• выводы, которые агент не имел права делать;
• использованные источники и инструменты;
• полноту передачи инженеру;
• ответ пользователю;
• время и стоимость выполнения.
Даже десять кейсов, которые я описывала ранее, поймали две регрессии, которые прошли бы обычную техническую проверку. Дальше мы хотим расширять набор по темам и типам риска: неверное сопоставление объекта, ложный отрицательный результат, необоснованный диагноз, пропущенная проверка, неправильная эскалация, повторный вопрос пользователю.
Но есть другой риск: агент может просто «выучить» постоянный набор. Поэтому к старым контрольным кейсам нужно добавлять свежие обращения, которые раньше не использовались при настройке.
Как изменилась роль экспертов
На старте мы ожидали, что цифровой агент прежде всего сократит количество типовых вопросов к самым опытным инженерам. Это произошло, но работа экспертов не исчезла. Она переместилась из отдельных обращений в настройку всей системы.
Раньше эксперт мог несколько раз за неделю объяснить коллегам одну и ту же особенность клиента. Теперь ему нужно один раз разобрать случай, определить, чему здесь можно доверять, какую проверку выполнить первой, где заканчиваются полномочия агента и что нужно передать инженеру. После этого решение попадает в знания, инструкцию, инструмент или регрессионный набор.
В итоге одно решение эксперта может повлиять не на одно обращение, а на все следующие обращения этого класса.
Но экономия появляется не сразу. В начале эксперты, наоборот, тратят много времени на просмотр ответов, описание того, что раньше делали почти интуитивно, и разбор противоречий между документацией и реальной системой.
Агент хорошо обнаруживает пробелы в знаниях, но сам их не закрывает. Если два источника расходятся, всё равно нужен человек, который определит правильный вариант и возьмёт на себя ответственность за обновление. Если новое ограничение делает ответы безопаснее, но бесполезнее, эксперт должен заметить это на реальном кейсе.
Чтобы такой разбор не заканчивался замечанием в чате, мы сделали отдельного помощника по документации. Инженер передаёт ему краткое описание проблемы и примеры обращений, где она обсуждалась. Помощник готовит статью, задаёт уточняющие вопросы, если данных не хватает, а по итогам публикует материал в нужном разделе Confluence.
Следующий шаг: запустить отдельного агента, который будет проверять уже обработанные обращения и искать, чего не хватило для более быстрого решения. Это может быть устаревшая статья, отсутствующая инструкция, недоступная проверка или инструмент, которого пока нет.
Но автоматически менять базу знаний по таким выводам мы ему не дадим. Агент может найти пробел и подготовить материал, но эксперт должен проверить, правильно ли определена причина. Иначе есть риск закрепить в документации ошибочный вывод.
Так обращения постепенно превращаются в механизм развития поддержки: реальный случай показывает пробел, эксперт подтверждает его, цифровой помощник обновляет документацию, а старое обращение попадает в регрессионный набор.
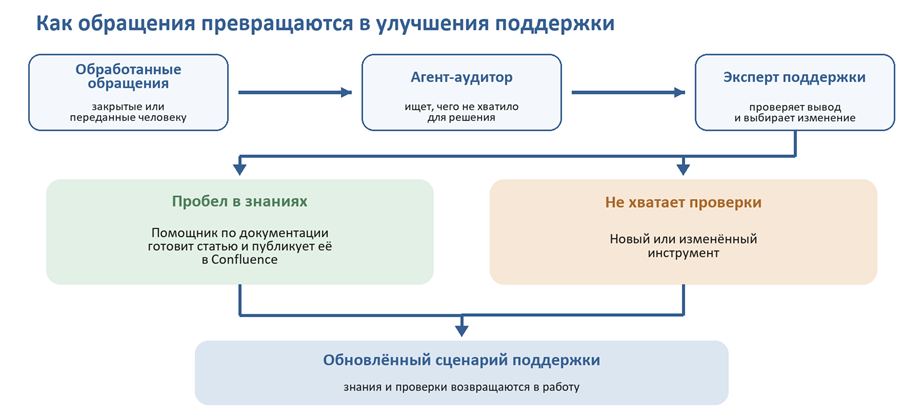
Рисунок 5. Как обращения превращаются в улучшения поддержки
У экспертов осталось и право остановить автоматизацию: убрать тему из клиентского потока, потребовать дополнительную проверку или вернуть обязательную эскалацию.
Мы не пытаемся вывести эксперта из процесса. Просто теперь он реже работает как внутренний поисковик и чаще отвечает за качество всего сценария.
База знаний стала основой для новых агентов
Ещё один результат мы сначала вообще не замечали. Пока учили агентов разбирать обращения, пришлось собрать вместе сведения о продуктах, проектах, индивидуальных доработках, договорах поддержки и уже решённых проблемах. До этого всё было разбросано по Confluence, CRM, проектным памяткам и головам экспертов.
В какой-то момент стало понятно, что эта база пригодится не только поддержке. Из неё можно собирать цифровой профиль проекта, готовить документацию и памятки, проверять границы поддержки по договору, консультировать по коду продукта и находить пробелы в знаниях.
Сейчас мы продолжаем добавлять агентов для других подразделений. Они используют то, что уже собрано, и заодно показывают, какой информации всё ещё не хватает. Похоже, у этой работы вообще нет конечной точки. Решаем новую задачу, пополняем знания, потом на этих знаниях собираем следующего агента. И уже не начинаем каждый раз с нуля.
В другой компании источники будут другими, но сама логика, думаю, сохранится. При этом за базой всё равно нужно следить: проверять источники, хранить версии и назначать ответственных за обновление. Иначе она начнёт так же быстро распространять устаревшую или ошибочную информацию.
Каких метрик нам всё ещё не хватает
Сейчас мы уже можем считать скорость реального решения, длинный хвост, маршруты обработки и долю обращений, которые агент решил или передал человеку.
Этого достаточно, чтобы увидеть, что процесс изменился. Но недостаточно, чтобы уверенно говорить о качестве.
Сейчас нам больше всего не хватает таких показателей:
• повторное обращение с той же проблемой через 72 часа и 7 дней;
• доля неполных, ошибочных и неоднозначных результатов инструментов;
• процент прохождения регрессионного набора после каждого изменения;
• время от обнаружения типовой ошибки до её исправления в инструкциях, знаниях или инструменте;
• доля массовых инцидентов в потоке, чтобы не выдавать их за улучшение обычной поддержки.
Ещё мы хотим смотреть не только на количество обращений, но и на повторяемость проблемы: сколько пользователей или объектов столкнулись с ней снова.
Одна массовая проблема может породить сотни быстро закрытых карточек. По отчёту цифровой агент поддержки будет выглядеть отлично. Для продукта, где возникла эта проблема, это, наоборот, сигнал, что пора устранять первопричину.
Такие проблемы мы хотим оценивать не только по количеству обращений. Важны повторяемость, число затронутых пользователей, влияние на работу и возможность вообще предотвратить проблему на стороне продукта.
Что я бы сделала иначе, если бы начинала сейчас
Если бы мы начинали сейчас, общий путь я бы не меняла. Но несколько вещей сделала бы раньше.
Метрику реального решения определила бы до запуска. Исторические данные удалось восстановить, но комментарии и статусы изначально создавались не для такого анализа. Если заранее фиксировать момент содержательного ответа и дальнейшую реакцию пользователя, результат будет надёжнее.
Набор старых обращений для повторной проверки тоже собрала бы заранее. Мы начали системно переигрывать их уже после нескольких изменений. Лучше иметь хотя бы по несколько сложных случаев на каждую тему с первого дня.
Обычный поток и массовые инциденты сразу считала бы отдельно. Иначе агент, который быстро разослал один согласованный ответ на сотни одинаковых обращений, выглядит эффективнее агента, который долго и правильно диагностировал десять разных проблем.
Инструкции и знания версионировала бы жёстче. Изменение одного абзаца может повлиять сразу на несколько сценариев. Нужно понимать, какая версия работала в конкретном обращении и что именно поменялось между двумя прогонами.
И я бы не пыталась одной цифрой ответить на вопрос «работает ли агент». У руководителя, пользователя, инженера и владельца продукта на самом деле разные вопросы. Одного общего процента автоматизации для ответа на них недостаточно.
Так внедрение успешно или нет?
Если смотреть на скорость типового обращения, то да: изменение большое. Медиана фактического решения сократилась с 21 ч 52 мин (0,91 суток) до 22 минут. Больше половины закрытых обращений в выбранном периоде прошли по маршруту, где агент решил вопрос без инженера. Даже после передачи человеку обращения в среднем двигались быстрее, чем поток без агента.
Оценок пользователей у нас исторически мало для статистики: пользователи ставят их неохотно. Там, где они есть, средняя оценка до и после запуска оставалась высокой — примерно 4,8–4,9 из 5. Этого недостаточно, чтобы заявлять о росте удовлетворённости, но по доступным оценкам мы не видим, что ускорение ухудшило пользовательское восприятие решения.
Всё это ещё не доказательство, что агент сделал поддержку в 59 раз лучше. Сравнение «до/после» не отделяет его вклад от изменения состава обращений и массовых инцидентов. Статус «решено» не гарантирует, что пользователь не вернётся с той же проблемой. А ускорение отдельного сценария иногда скрывает ухудшение ответа.
Поэтому мы не считаем внедрение завершённым. После выхода в реальный поток работа не закончилась, а просто стала другой.
Раньше мы в основном собирали агента и учили его работать с нашими системами.
Теперь мы измеряем результат, переигрываем старые случаи, разбираем регрессии, чистим инструкции и добавляем ограничения там, где правдоподобный ответ опаснее честной эскалации.
Для меня сейчас главный вывод проще: цифрового сотрудника нельзя один раз настроить и оставить работать.
После выхода в реальный поток он не становится «готовым». Он просто начинает сталкиваться с тем, чего не было в пилоте: новыми формулировками, изменившимися данными, редкими случаями и нашими же неудачными правками.
Чем больше решений мы ему доверяем, тем важнее смотреть не на одну красивую цифру, а на то, насколько предсказуемо он ведёт себя в сложных и редких случаях.


Для участия в Чате вам необходим бесплатный аккаунт pro-blockchain.com
Войти
Регистрация
Похожие новости
Подпишись на telegram канал и узнавай первым обо всех новостях