 Русский
 English
Cryptocurrencies:
8013 /
Markets: 108500
Market Cap: $ 2 480 947 632 137 /
24h Vol: $ 70 600 266 625 /
BTC
Dominance: 60.249331295815%
Новости
Синтетические плавки в ДСП-3: как сгенерировать данные и не обмануть себя
Привет, Хабр! Эта история началась с того, что меня позвали пообщаться на тему работы в металлургическую компанию. Спросили коротко: «Готов?». Я оценил свои силы, масштаб задачи и ответил прямо — готов зайти сразу на позицию Head of AI, чтобы выстроить процесс от и до.
И тут начался классический корпоративный футбол. Несмотря на предметный разговор, мне начали делать голову из‑за отсутствия профильной вышки по программированию. Для суровой индустрии диплом оказался важнее реального опыта и понимания процессов. Поняв, что стандартным путем эту бюрократию не пробить, я решил пойти напролом: за пару недель собрать работающее MVP, показать товар лицом и жестко выделиться на фоне остальных кандидатов с «правильными» дипломами.
Спойлер: красивого хэппи‑энда не будет. Моё MVP до высшего руководства так и не донесли, а меня в итоге просто развернули на пороге. Но не пропадать же добру? Проект получился слишком интересным, чтобы просто похоронить его на жестком диске.
Эта статья посвящена исключительно генератору. Мы разберем, как он устроен «под капотом», какие неочевидные ошибки я в нем допустил, и как проверить, что синтетика не врет сама себе. Обучение CatBoost и создание работающего микросервиса‑советника мы оставим для второй части.
Статья написана так, чтобы репозиторий вам не понадобился: весь код приведен прямо здесь, в том порядке, в котором его удобно читать и воспроизводить. Если вы захотите пропустить теоретические объяснения, в конце каждого раздела есть готовый рабочий фрагмент кода, который можно скопировать и запустить у себя.
Зачем вообще синтетика
На металлургических предприятиях данные есть, но выложить их в открытый доступ нельзя: это коммерческая тайна. В итоге у тех, кто учится или хочет проверить идею, нет ничего, на чём можно обучить модель и сравнить подходы. Синтетический набор не заменяет реальные данные, но позволяет отладить весь конвейер: от генерации и обучения до интерфейса, и потом подставить настоящие плавки.
Задача такая. При выпуске стали из печи в ковш сталевар добавляет ферросплавы, чтобы вернуть выгоревшие кремний и марганец в рамки ГОСТ. Часть сплава сгорает, и сколько именно, заранее неизвестно. Поэтому дозу берут с запасом, а запас стоит денег. Хочется по тому, что известно до добавки, оценить минимальную дозу, которой хватает.
Что получится в конце
генератор, воспроизводимый по seed
датасет на 2000 плавок с 18 колонками и пятью проверками годности по ГОСТ 977–88
Все цифры в статье получены на данных, которые создал этот же генератор. Они описывают симулятор, а не реальную печь, и я буду напоминать об этом там, где это важно.
Что мы моделируем
Моделируется выплавка отливки 1 группы из стали 35Л по ГОСТ 977–88, массой 3 тонны, в дуговой печи ДСП-3 с основной футеровкой. Сырьём служит лом чёрных металлов категорий 2А и 6А по ГОСТ 2787–2019 и передельный чугун. Лом 2А — это кусковая чистая тяжёлая сталь, основа шихты. 6А — брикеты прессованной стальной стружки: дешевое сырьё, но с маслом и окалиной, откуда берётся сера. Чугун нужен как науглероживатель, потому что в самом ломе углерода около 0,15%.
Завалка всегда ровно 3300 кг: недогруз печи убыточен. Около 10% металла уходит в угар, и на выпуске мы получаем около 3000 кг жидкой стали.
Этапы плавки
Завалка. Взвешивают и загружают лом 2А, брикеты 6А и чугун.
Расплавление. Дуги плавят шихту, углерод после расплавления полностью определяется завалкой.
Продувка кислородом. Кислород выжигает лишний углерод и уносит газы. Если передуть, металл переокислится.
Наведение шлака. Известь даёт основность. Высокая основность связывает серу и фосфор, кислый шлак (ниже 2,0) — нет.
Выпуск. Металл сливают в ковш при заданной температуре по погружной термопаре.
Легирование в ковше. Добавляют ферросилиций ФС75 и ферромарганец ФМн78. Часть кремния и марганца угарает, а доля усвоения зависит от температуры, кислорода и основности.
Контроль ОТК. Итоговый состав и перегрев проверяются по допускам.
Диапазоны входных параметров
Параметр | Диапазон | Единицы |
Лом 2А | 1600–2500 | кг |
Брикеты 6А | 400–1300 | кг |
Чугун | 200–400 | кг |
Кислород | 35–75 | м³ |
Основность шлака | 1,8–2,9 | — |
Температура выпуска | 1530–1660 | °C |
ФС75 | 15–30 | кг |
ФМн78 | 20–40 | кг |
Пять условий годности
Плавка считается годной, только если одновременно выполнены все пять условий:
Условие | Допуск |
Углерод | 0,32–0,40% |
Кремний | 0,20–0,52% |
Марганец | 0,45–0,90% |
Сера + фосфор (сумма) | не больше 0,040% |
Перегрев над ликвидусом | +45…+70 °C |
Если перегрев меньше 45 °C, металл густой и при заливке получится недолив. Если больше 70 °C, металл прожжёт форму и отливка покроется газовыми порами. Пометьте для себя: это упрощённая модель. В самом ГОСТе сера и фосфор нормируются по отдельности, а окно перегрева придумано мной для заливки в формы из ХТС и не взято из стандарта.
Диаграмма железо‑углерод и ликвидус
Температуру плавления стали мы считаем линейной аппроксимацией по химсоставу:
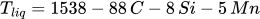
Здесь C, Si и Mn — массовые проценты. Это приближение, достаточное для симулятора. Для расчётов на реальной печи берут коэффициенты из справочника или термодинамического расчёта.
Первая попытка: независимый рандом
Первое, что приходит в голову, — взять каждый параметр равномерно из его диапазона, а результат посчитать по формулам. Вот сокращённая версия моего первого генератора:
np.random.seed(42)
n = 100

чугун = np.random.uniform(250, 400, n)
стружка = np.random.uniform(400, 1200, n)
лом = 3300 - чугун - стружка

кислород = np.random.uniform(35, 75, n)
основность = np.random.uniform(1.8, 2.9, n)
temp_выпуска = np.random.uniform(1530, 1660, n)

фс75 = np.random.uniform(15, 30, n)
фмн78 = np.random.uniform(20, 40, n)
На 100 плавках из этого получилась одна годная. На 2000 плавок после нескольких правок их стало 127, то есть 6,3%. Причина не в сложной физике, а в арифметике. Пять условий должны выполниться одновременно, а каждое из них при независимых параметрах выполняется с вероятностью от десятков процентов до долей. Окно перегрева шириной 25 °C попадало в случайную температуру из диапазона 130 °C редко, и в первой версии 82% плавок вылетали именно по перегреву.
Основные причины брака в той версии:
Условие | Плавок вне допуска |
Перегрев вне 45–70 °C | 82% |
Углерод вне 0,32–0,40% | 54% |
Кремний вне 0,20–0,52% | 42% |
Марганец вне 0,45–0,90% | 6% |
Сера и фосфор выше 0,040% | 0% |
Последняя строка отдельно неприятна: условие по сере и фосфору вообще никогда не срабатывало. Максимум по формуле был 0,030 при пороге 0,040, то есть критерий был мёртвым. Для обучения такой датасет бесполезен: модель видит один класс и не может выучить ничего про причины брака.
Принцип: оператор целится и ошибается
Каждый параметр, которым управляет человек, в симуляторе устроен одинаково: цель считается из предыдущего измерения, к ней добавляется шум (точность прибора или человеческий фактор), и результат зажимается в физические границы. Сравните:
# так не надо: температура не связана ни с чем
temp_выпуска = rng.uniform(1530, 1660, n)
# так лучше: целимся в ликвидус + перегрев и ошибаемся на термопаре
tap_temp = np.clip(
liquidus_plan + TARGET_SUPERHEAT + rng.normal(0, 5, n), *TAP_TEMP_RANGE
)По шагам это выглядит так:
Этап | Что мастер знает | Что он считает | Откуда шум |
Завалка | целевой углерод шихты | массу чугуна | погрешность весов, ±4 кг |
Продувка | углерод после расплавления | объём кислорода | расходомер, ±2 м³ |
Шлак | загрязнённость партии 6А по анализу | основность шлака | анализ ±0,04, дозатор извести ±0,08 |
Ферросплавы | остаточные Si и Mn, цель | дозы ФС75 и ФМн78 при номинальном усвоении | дозатор, ±1,2 и ±1,8 кг |
Выпуск | плановый химсостав | температуру выпуска | термопара и задержка, ±5 °C |
Обратите внимание на ферросплавы. Мастер считает дозу при номинальном усвоении (80% для марганца, 90% для кремния), потому что фактическое усвоение он узнает только после выпуска. Всё, что мешает усвоению (перегрев, передув, кислый шлак), потом уменьшает реальный результат, и именно эта разница между планом и фактом даёт и брак, и запас, который модель будет пытаться оценить.
Генератор: код по шагам
Проект — небольшой пакет eafsim. Структура:
eaf-melt-sim/
├── eafsim/
│   ├── __init__.py
│   ├── generator.py     # симулятор плавок
│   └── model.py         # цель, обучение CatBoost, инференс
├── app.py               # приложение Streamlit
├── tests/
│   └── test_pipeline.py
├── data/                # сюда пишется CSV
├── models/              # сюда пишется модель и метрики
└── requirements.txt
Зависимости:
numpy>=2.0
pandas>=2.2
scikit-learn>=1.5
catboost>=1.2
streamlit>=1.50
plotly>=5.20
Файл eafsim/__init__.py состоит из двух строк:
"""Synthetic electric arc furnace heats and a minimum FeMn78 dose model."""

__version__ = "0.1.0"
Константы и допуски
Все числа, которые описывают печь и технологию, вынесены в начало generator.py. Так видно, что именно можно крутить, и в коде нет «магических» чисел.
"""Synthetic heat records for a 3 t electric arc furnace with basic lining.

The simulated route is: charge -> melting -> oxygen blowing -> slag adjustment
-> ferroalloy addition in the ladle -> tapping -> quality check against
GOST 977-88 (steel 35L, group 1 castings, 3 t).

At every stage the operator aims at a value derived from the previous
measurements and adds instrument or handling noise. Ferroalloy recovery in the
ladle degrades smoothly with overheating, excess oxygen and low slag
basicity, and carries an unexplained heat-to-heat residual.
"""

from __future__ import annotations

import argparse
from pathlib import Path

import numpy as np
import pandas as pd

CHARGE_KG = 3300.0
LIQUID_STEEL_KG = 3000.0

SCRAP_2A_RANGE = (1600.0, 2500.0)
SCRAP_6A_RANGE = (400.0, 1300.0)
PIG_IRON_RANGE = (200.0, 400.0)
OXYGEN_RANGE = (35.0, 75.0)
BASICITY_RANGE = (1.8, 2.9)
TAP_TEMP_RANGE = (1530.0, 1660.0)
FESI_RANGE = (15.0, 30.0)
FEMN_RANGE = (20.0, 40.0)

PIG_IRON_CARBON = 0.042
SCRAP_CARBON = 0.0015
CARBON_REMOVED_PER_M3 = 0.0025

FESI_SI_CONTENT = 0.75
FEMN_MN_CONTENT = 0.78
NOMINAL_SI_RECOVERY = 0.90
NOMINAL_MN_RECOVERY = 0.80
RESIDUAL_SI = 0.05
RESIDUAL_MN = 0.12

TARGET_CARBON = 0.36
TARGET_SI = 0.36
TARGET_MN = 0.68
TARGET_SUPERHEAT = 57.5
TARGET_SP = 0.024

SP_BASE = 0.010
SP_PER_6A_SHARE = 0.14
SP_BASICITY_SLOPE = 0.010

GOST_CARBON = (0.32, 0.40)
GOST_SILICON = (0.20, 0.52)
GOST_MANGANESE = (0.45, 0.90)
GOST_SP_MAX = 0.040
GOST_SUPERHEAT = (45.0, 70.0)
Несколько пояснений к числам:
CARBON_REMOVED_PER_M3 = 0.0025 — каждый кубометр кислорода снимает 0,0025% углерода из ванны. Это упрощение, но оно даёт линейную и понятную связь.
FESI_SI_CONTENT и FEMN_MN_CONTENT — доля кремния в ФС75 и марганца в ФМн78.
RESIDUAL_SI и RESIDUAL_MN — сколько кремния и марганца остаётся в ванне перед легированием.
TARGET_* — на что целится мастер. Марганец он целит в 0,68%, то есть в середину окна 0,45–0,90%. Именно из‑за этого запаса у модели вообще есть что экономить.
SP_* — коэффициенты для серы и фосфора. Они подобраны так, чтобы порог 0,040% реально мог нарушаться (в первой версии он не нарушался никогда).
Словарь колонок
Датасет самодокументируется: у каждой колонки в коде есть единицы и описание на двух языках. Из этого словаря потом строятся метаданные для Kaggle и вкладка с данными в приложении. Пропустите блок, если не нужны подробности, он не влияет на расчёт.
COLUMNS: dict[str, dict[str, str]] = {
    "melt_id": {
        "unit": "-",
        "en": "Heat identifier.",
        "ru": "Номер плавки.",
    },
    "scrap_2a_kg": {
        "unit": "kg",
        "en": "Bulk scrap, category 2A, in the charge.",
        "ru": "Кусковой лом категории 2А в шихте.",
    },
    "scrap_6a_kg": {
        "unit": "kg",
        "en": "Scrap category 6A in the charge; the contaminated, cheaper feedstock in the simulation.",
        "ru": "Лом категории 6А в шихте; в модели это более грязное и дешёвое сырьё.",
    },
    "pig_iron_kg": {
        "unit": "kg",
        "en": "Pig iron used as carburiser.",
        "ru": "Передельный чугун как науглероживатель.",
    },
    "carbon_pct": {
        "unit": "%",
        "en": "Carbon in the bath after oxygen blowing.",
        "ru": "Углерод в ванне после продувки кислородом.",
    },
    "oxygen_m3": {
        "unit": "m3",
        "en": "Oxygen blown during the boil.",
        "ru": "Объём кислорода, вдутого на этапе кипения.",
    },
    "slag_basicity": {
        "unit": "-",
        "en": "Slag basicity before tapping.",
        "ru": "Основность шлака перед выпуском.",
    },
    "sulfur_phosphorus_pct": {
        "unit": "%",
        "en": "Combined sulfur and phosphorus in the steel.",
        "ru": "Суммарное содержание серы и фосфора в стали.",
    },
    "fesi75_kg": {
        "unit": "kg",
        "en": "FeSi75 added to the ladle.",
        "ru": "Ферросилиций ФС75, добавленный в ковш.",
    },
    "femn78_kg": {
        "unit": "kg",
        "en": "FeMn78 added to the ladle.",
        "ru": "Ферромарганец ФМн78, добавленный в ковш.",
    },
    "tap_temp_c": {
        "unit": "C",
        "en": "Tapping temperature.",
        "ru": "Температура выпуска.",
    },
    "mn_recovery": {
        "unit": "fraction",
        "en": "Manganese recovery from FeMn78 (not observable before tapping).",
        "ru": "Усвоение марганца из ФМн78 (до выпуска наблюдать нельзя).",
    },
    "si_recovery": {
        "unit": "fraction",
        "en": "Silicon recovery from FeSi75 (not observable before tapping).",
        "ru": "Усвоение кремния из ФС75 (до выпуска наблюдать нельзя).",
    },
    "silicon_pct": {
        "unit": "%",
        "en": "Final silicon in the ladle.",
        "ru": "Итоговое содержание кремния в ковше.",
    },
    "manganese_pct": {
        "unit": "%",
        "en": "Final manganese in the ladle.",
        "ru": "Итоговое содержание марганца в ковше.",
    },
    "liquidus_c": {
        "unit": "C",
        "en": "Liquidus temperature from the final composition.",
        "ru": "Температура ликвидус по итоговому химическому составу.",
    },
    "superheat_c": {
        "unit": "C",
        "en": "Tapping temperature minus liquidus.",
        "ru": "Температура выпуска минус ликвидус.",
    },
    "gost_pass": {
        "unit": "0/1",
        "en": "1 if carbon, silicon, manganese, sulfur+phosphorus and superheat are all within limits.",
        "ru": "1, если углерод, кремний, марганец, сера+фосфор и перегрев одновременно в допуске.",
    },
}
Обратите внимание на mn_recovery и si_recovery: в описании прямо сказано, что до выпуска их наблюдать нельзя. Это важно для модели, и мы к этому вернёмся.
Вспомогательные функции
Четыре маленькие функции, на которых держится вся физика:
def _sigmoid_penalty(x, center: float, scale: float, max_penalty: float):
    return max_penalty / (1.0 + np.exp(-(x - center) / scale))


def _dose(target: float, residual: float, content: float, recovery: float) -> float:
    return (target - residual) / 100.0 * LIQUID_STEEL_KG / (content * recovery)


def _pickup(dose, content: float, recovery) -> float:
    return dose * content * recovery / LIQUID_STEEL_KG * 100.0


def _liquidus(carbon, silicon, manganese):
return 1538.0 - 88.0 * carbon - 8.0 * silicon - 5.0 * manganesesigmoidpenalty — плавная ступенька. Вместо резкого «выше 1640 °C усвоение падает на 15%» штраф нарастает постепенно вокруг порога. Почему это принципиально, расскажу в разделе про грабли.
_dose отвечает на вопрос «сколько килограммов сплава надо добавить, чтобы довести элемент от остатка до цели при заданном усвоении».
_pickup решает обратную задачу: сколько процентов элемента даст такая доза.
_liquidus — формула ликвидуса из раздела выше.
В виде формул первые две выглядят так:
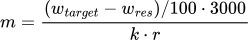
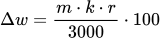
Здесь m — масса сплава в кг, w — содержание элемента в процентах, k — доля элемента в сплаве (0,75 для ФС75 и 0,78 для ФМн78), r — усвоение, 3000 — масса жидкой стали в кг.
Шихта
Это самое тонкое место первого этапа. Чугун здесь не случайная величина: мастер дозирует его так, чтобы после расплавления углерод оказался около 0,42–0,50%. Лом 2А и брикеты 6А на углерод почти не влияют (у обоих около 0,15%), поэтому их соотношение — экономический выбор, а не физика.
def _sample_charge(rng: np.random.Generator, n: int):
    scrap_2a: list[float] = []
    scrap_6a: list[float] = []
    pig_iron: list[float] = []
    carbon_per_kg_pig = PIG_IRON_CARBON - SCRAP_CARBON
    while len(scrap_2a) < n:
        batch = n * 3
        target_carbon = rng.uniform(0.42, 0.50, batch)
        pig_calc = (target_carbon / 100.0 - SCRAP_CARBON) * CHARGE_KG / carbon_per_kg_pig
        pig = np.clip(pig_calc + rng.normal(0, 4, batch), *PIG_IRON_RANGE)
        s6 = rng.uniform(*SCRAP_6A_RANGE, batch)
        s2 = CHARGE_KG - pig - s6
        keep = (s2 >= SCRAP_2A_RANGE[0]) & (s2 <= SCRAP_2A_RANGE[1])
        scrap_2a.extend(s2[keep])
        scrap_6a.extend(s6[keep])
        pig_iron.extend(pig[keep])
    return (
        np.array(scrap_2a[:n]),
        np.array(scrap_6a[:n]),
        np.array(pig_iron[:n]),
    )
Что здесь происходит:
Выбираем целевой углерод после расплавления из диапазона 0,42–0,50%.
Обратной формулой считаем, сколько чугуна для этого нужно, и добавляем шум весов ±4 кг. Формула следует из баланса углерода: масса чугуна, умноженная на разницу содержания углерода в чугуне и в ломе, плюс 3300 кг лома даёт целевое количество углерода.
Брикеты 6А выбираем случайно в их диапазоне 400–1300 кг, это выбор технолога по цене.
Лом 2А берём остатком до 3300 кг. Если он вылез за 1600–2500 кг, комбинацию отбрасываем и берём новую.
Завалка всегда сходится к 3300 кг, и каждый компонент остаётся в своих границах.
Функция simulate: шаг за шагом
Дальше идёт одна длинная функция. Я разрезаю её по этапам плавки; все куски стоят подряд внутри simulate с отступом в четыре пробела. В конце раздела есть команда, которая проверяет, что вы собрали всё правильно.
Шаг 1. Завалка и углерод после расплавления
def simulate(n: int = 2000, seed: int = 42) -> pd.DataFrame:
    """Generate ``n`` heats. The output is fully determined by ``seed``."""
    rng = np.random.default_rng(seed)

    scrap_2a, scrap_6a, pig_iron = _sample_charge(rng, n)
    carbon_melt = (
        (pig_iron * PIG_IRON_CARBON + (scrap_2a + scrap_6a) * SCRAP_CARBON)
        / CHARGE_KG
        * 100.0
    )
    contamination = rng.uniform(0.7, 1.4, n)
carbon_melt — углерод в ванне после расплавления, в процентах. contamination — скрытая загрязнённость конкретной партии брикетов 6А: 0,7 значит «чистая», 1,4 — «грязная». В датасет эта величина не попадёт, потому что в жизни мастер точно её не знает.
Шаг 2. Продувка кислородом
    oxygen_plan = (carbon_melt - TARGET_CARBON) / CARBON_REMOVED_PER_M3
    oxygen = np.clip(oxygen_plan + rng.normal(0, 2, n), *OXYGEN_RANGE)
    carbon = carbon_melt - oxygen * CARBON_REMOVED_PER_M3
Мастер видит пробу и считает, сколько кислорода нужно, чтобы дойти до 0,36%. Расходомер ошибается на ±2 м³. Последняя строка важна: итоговый углерод считается по фактически вдутому кислороду, а не по плановому. Только так шум расходомера реально попадает в химию.
Шаг 3. Шлак, сера и фосфор
    contamination_assay = contamination + rng.normal(0, 0.04, n)
    sp_load = scrap_6a / CHARGE_KG * SP_PER_6A_SHARE
    basicity_plan = (SP_BASE + sp_load * contamination_assay - TARGET_SP) / SP_BASICITY_SLOPE
    basicity = np.clip(basicity_plan + rng.normal(0, 0.08, n), *BASICITY_RANGE)
    sulfur_phosphorus = np.clip(
        SP_BASE + sp_load * contamination - basicity * SP_BASICITY_SLOPE, 0.006, None
    )
Сера и фосфор описываются линейной формулой: чем больше в шихте грязных брикетов, тем больше серы, а чем выше основность, тем больше она связывается шлаком:
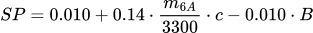
Здесь m — масса брикетов 6А, c — загрязнённость партии, B — основность. Мастер решает это уравнение относительно B, чтобы получить SP = 0,024 (запас под порогом 0,040), но подставляет в него загрязнённость по анализу (contamination_assay), а не истинную. Анализ ошибается на ±0,04, а дозатор извести на ±0,08. Итоговая sulfur_phosphorus считается уже по истинной загрязнённости и фактической основности. Именно эта разница даёт редкий брак по сере, близкий к реальному.
Шаг 4. Дозы ферросплавов
    fesi_plan = _dose(TARGET_SI, RESIDUAL_SI, FESI_SI_CONTENT, NOMINAL_SI_RECOVERY)
    femn_plan = _dose(TARGET_MN, RESIDUAL_MN, FEMN_MN_CONTENT, NOMINAL_MN_RECOVERY)
    fesi = np.clip(fesi_plan + rng.normal(0, 1.2, n), *FESI_RANGE)
    femn = np.clip(femn_plan + rng.normal(0, 1.8, n), *FEMN_RANGE)
Мастер считает дозу при номинальном усвоении: 80% для марганца и 90% для кремния. Для целевого марганца 0,68% это около 26,9 кг ФМн78. Для кремния 0,36% плановая доза выходит около 13,8 кг, но нижняя граница по ТЗ — 15 кг, поэтому np.clip поднимает почти все дозы ФС75 до 15. Это плата за выбор диапазонов: у кремния в данных почти нет вариации, и я отдельно пишу об этом в ограничениях.
Шаг 5. Температура выпуска
    si_plan = RESIDUAL_SI + _pickup(fesi_plan, FESI_SI_CONTENT, NOMINAL_SI_RECOVERY)
    mn_plan = RESIDUAL_MN + _pickup(femn_plan, FEMN_MN_CONTENT, NOMINAL_MN_RECOVERY)
    liquidus_plan = _liquidus(TARGET_CARBON, si_plan, mn_plan)
    tap_temp = np.clip(
        liquidus_plan + TARGET_SUPERHEAT + rng.normal(0, 5, n), *TAP_TEMP_RANGE
    )
Мастер считает ликвидус по плановому химсоставу (тому, который получится при номинальном усвоении) и добавляет целевой перегрев 57,5 °C, середину окна 45–70. Реальное усвоение он ещё не знает, поэтому даже идеально попавшая температура может потом дать неверный перегрев: химсостав смещается и ликвидус уходит в сторону.
Шаг 6. Реальное усвоение ферросплавов
Здесь план встречается с фактом:
    oxygen_r = np.round(oxygen, 1)
    basicity_r = np.round(basicity, 2)
    tap_temp_r = np.round(tap_temp, 0)

    mn_loss = (
        _sigmoid_penalty(tap_temp_r, 1640, 8, 0.15)
        + _sigmoid_penalty(oxygen_r, 60, 5, 0.15)
        + _sigmoid_penalty(-basicity_r, -2.0, 0.1, 0.10)
    )
    si_loss = (
        _sigmoid_penalty(tap_temp_r, 1640, 8, 0.10)
        + _sigmoid_penalty(oxygen_r, 60, 5, 0.15)
        + _sigmoid_penalty(-basicity_r, -2.0, 0.1, 0.05)
    )
    furnace_noise = rng.normal(-0.01, 0.02, n)
    mn_recovery = np.clip(NOMINAL_MN_RECOVERY - mn_loss + furnace_noise, 0.20, NOMINAL_MN_RECOVERY)
    si_recovery = np.clip(NOMINAL_SI_RECOVERY - si_loss + furnace_noise * 0.7, 0.20, NOMINAL_SI_RECOVERY)
Три детали, которые стоит заметить.
Сначала округление, потом штрафы. Кислород, основность и температура округляются до того, как влияют на усвоение. Тогда в датасете лежат те же значения, по которым считалась физика, и никаких расхождений между «внутренним» и «видимым» миром нет.
Три сигмоиды. Каждый штраф «включается» плавно вокруг своего порога: 1640 °C по температуре, 60 м³ по кислороду и 2,0 по основности. Для основности штраф растёт, когда она падает, поэтому аргумент со знаком минус. При основности 1,8 это около 0,088 доли усвоения, при 2,5 — уже почти ноль.
Необъяснимый остаток. furnace_noise — случайная составляющая, которую нельзя предсказать по трём датчикам: положение дуги, износ футеровки, турбулентность струи при переливе. Смещение на −0,01 означает, что «повезло больше номинала» почти не бывает: 80% уже верхний предел, а усвоить меньше плана можно всегда. Без этого шума модель научилась бы только восстанавливать вашу формулу, объяснившись с погрешностью, близкой к нулю.
Шаг 7. Итоговый состав и вердикт ОТК
    silicon = RESIDUAL_SI + _pickup(fesi, FESI_SI_CONTENT, si_recovery)
    manganese = RESIDUAL_MN + _pickup(femn, FEMN_MN_CONTENT, mn_recovery)

    carbon_r = np.round(carbon, 3)
    silicon_r = np.round(silicon, 3)
    manganese_r = np.round(manganese, 3)
    liquidus = np.round(_liquidus(carbon_r, silicon_r, manganese_r), 1)
    superheat = np.round(tap_temp_r - liquidus, 1)

    df = pd.DataFrame(
        {
            "melt_id": np.arange(1, n + 1),
            "scrap_2a_kg": np.round(scrap_2a, 0),
            "scrap_6a_kg": np.round(scrap_6a, 0),
            "pig_iron_kg": np.round(pig_iron, 0),
            "carbon_pct": carbon_r,
            "oxygen_m3": oxygen_r,
            "slag_basicity": basicity_r,
            "sulfur_phosphorus_pct": np.round(sulfur_phosphorus, 3),
            "fesi75_kg": np.round(fesi, 1),
            "femn78_kg": np.round(femn, 1),
            "tap_temp_c": tap_temp_r,
            "mn_recovery": np.round(mn_recovery, 3),
            "si_recovery": np.round(si_recovery, 3),
            "silicon_pct": silicon_r,
            "manganese_pct": manganese_r,
            "liquidus_c": liquidus,
            "superheat_c": superheat,
        }
    )
    passed = (
        df["carbon_pct"].between(*GOST_CARBON)
        & df["silicon_pct"].between(*GOST_SILICON)
        & df["manganese_pct"].between(*GOST_MANGANESE)
        & (df["sulfur_phosphorus_pct"] <= GOST_SP_MAX)
        & df["superheat_c"].between(*GOST_SUPERHEAT)
    )
    df["gost_pass"] = passed.astype(int)
    return df[list(COLUMNS)]
Состав считается по фактической дозе и фактическому усвоению, а ликвидус — по фактическому составу. Так итоговый перегрев зависит от того, насколько план мастера расходится с реальностью. Колонки mn_recovery и si_recovery остаются в таблице, потому что из них строится цель модели, но в признаки обучения они не попадут.
Сводка и запуск из командной строки
def summarize(df: pd.DataFrame) -> str:
    lines = [f"heats: {len(df)}", f"gost_pass rate: {df['gost_pass'].mean():.1%}", "", "reject causes (share of heats outside the limit):"]
    checks = {
        "carbon": ~df["carbon_pct"].between(*GOST_CARBON),
        "silicon": ~df["silicon_pct"].between(*GOST_SILICON),
        "manganese": ~df["manganese_pct"].between(*GOST_MANGANESE),
        "sulfur+phosphorus": df["sulfur_phosphorus_pct"] > GOST_SP_MAX,
        "superheat": ~df["superheat_c"].between(*GOST_SUPERHEAT),
    }
    for name, mask in checks.items():
        lines.append(f"  {name:<18} {mask.mean():6.1%}")
    return "\n".join(lines)


def main() -> None:
    parser = argparse.ArgumentParser(description="Generate synthetic EAF heat records.")
    parser.add_argument("--n", type=int, default=2000, help="number of heats")
    parser.add_argument("--seed", type=int, default=42, help="random seed")
    parser.add_argument("--out", type=Path, default=Path("data/eaf_melts_2000.csv"))
    args = parser.parse_args()

    df = simulate(args.n, args.seed)
    args.out.parent.mkdir(parents=True, exist_ok=True)
    df.to_csv(args.out, index=False)
    print(f"saved {len(df)} rows to {args.out}\n")
    print(summarize(df))


if __name__ == "__main__":
    main()
Запуск:
python -m eafsim.generator --n 2000 --seed 42Результат на моём прогоне:
saved 2000 rows to data/eaf_melts_2000.csv

heats: 2000
gost_pass rate: 89.4%

reject causes (share of heats outside the limit):
  carbon               0.0%
  silicon              0.0%
  manganese            0.0%
  sulfur+phosphorus    9.4%
  superheat            1.2%
С тем же ‑seed файл получается байт в байт: я проверил это, сравнив сгенерированный заново CSV с тем, что лежит в релизе.
Грабли: модель с ошибкой 0,02 кг, которая ничему не научилась
В одной из промежуточных версий я получил метрики, от которых хотелось радоваться: MAE на тесте 0,021 кг, RMSE 0,24 кг. Радоваться было рано.
В той версии усвоение марганца считалось ступеньками:
mn_loss = (np.where(df['temp_выпуска_C'] > 1640, 0.15, 0.0) +
           np.where(df['кислород_м3'] > 60, 0.15, 0.0) +
           np.where(df['основность_шлака'] < 2.0, 0.10, 0.0))
усвоение_Mn = np.clip(0.80 - mn_loss, 0.20, 0.80)
Три бинарных условия дают не больше восьми возможных значений усвоения. Цель модели считалась из усвоения, а входами модели были ровно те же три величины. Проверка занимает три строки:
df['femn78_min_kg'] = (0.45 - 0.12) * 30 / (0.78 * df['усвоение_Mn'])
print(df['femn78_min_kg'].round(4).nunique())
print(df['femn78_min_kg'].round(3).value_counts().head())
На 2000 плавок целевая переменная принимала четыре разных значения. CatBoost не учился закономерности, он выучил наизусть три условия if из моего же генератора. Такая модель выглядит идеально и бесполезна: стоит сместить порог, и она ничего не поймёт.
Как починил
Две правки в генераторе, обе уже есть в коде выше.
Ступеньки заменены сигмоидами. Штраф растёт плавно вокруг порога, поэтому цель принимает непрерывный набор значений. Физически это тоже честнее: усвоение не «обрушивается» ровно на 1640 °C, а ухудшается постепенно.
Добавлен необъяснимый остаток furnace_noise. В реальной печи на усвоение влияет то, чего нет в трёх датчиках, и модель не должна уметь воспроизводить его по признакам.
Проверка после правки:
df = pd.read_csv('data/eaf_melts_2000.csv')
print(df['mn_recovery'].nunique())
Теперь у цели 174 разных значения, а MAE на честном тесте около 0,35 кг. Ошибка не нулевая, и это правильно: часть изменчивости задана шумом, и никакая модель её не предскажет. Важность признаков тоже перестала быть вырожденной, хотя основность шлака по‑прежнему тянет на себя около 70%.
Эту проверку я вынес в тест, чтобы она не откатилась незаметно:
def test_recovery_has_many_distinct_values(heats):
    assert heats["mn_recovery"].nunique() > 50
Другие ошибки по пути
Подгонка шума под красивую цифру. Когда брака получилось слишком много, я начал менять амплитуды шума, чтобы получить «правдоподобные» 10–20% негодных. Это неправильный метод: процент брака должен получаться из процесса, а не быть целью настройки. Правильный порядок такой. Сначала понять, откуда берётся структурный брак, и только потом смотреть итоговую долю. В моём случае причина оказалась не в шуме, а в том, что чугун сыпался случайно, а не рассчитывался под нужный углерод. После этой правки брак по углероду упал с 20% до нуля.
Масштабирование шихты. Сначала я независимо выбирал вес каждого компонента, а затем масштабировал сумму до 3300 кг. После масштабирования границы из ТЗ нарушались: лом 2А доходил до 2608 кг при потолке 2500, чугун падал до 169 кг при нижней границе 200. Исправление: выбирать чугун и 6А, считать 2А остатком и отбрасывать комбинации, которые выходят за границы.
Мёртвый критерий. Критерий по сере и фосфору в первой версии никогда не срабатывал, потому что формула не могла дать значение выше порога. Простая проверка «а бывает ли вообще брак по этой причине» ловит такое сразу, и она есть в функции summarize.
Быстрый чек‑лист для любого синтетического датасета
Сколько уникальных значений у цели? Если единицы или десятки на тысячи строк, модель запомнит правило.
Есть ли в данных оба класса, и не слишком ли мало редкого?
Может ли каждый критерий годности реально нарушиться?
Укладываются ли все входные значения в диапазоны из описания?
Не создана ли цель из тех же величин, что и признаки, без шума?
Получается ли тот же файл при том же seed?
Что на самом деле лежит в данных
Этот раздел самый важный для честности. Ниже то, что я увидел, когда посмотрел на собственный датасет глазами, а не глазами метрики.
Колонка | Мин. | Среднее | Макс. |
scrap_2a_kg | 1721 | 2126,6 | 2500 |
scrap_6a_kg | 531 | 920,7 | 1300 |
pig_iron_kg | 211 | 252,8 | 293 |
carbon_pct | 0,321 | 0,355 | 0,376 |
oxygen_m3 | 35,0 | 42,2 | 61,6 |
slag_basicity | 1,80 | 2,42 | 2,90 |
tap_temp_c | 1541 | 1557,7 | 1573 |
fesi75_kg | 15,0 | 15,1 | 18,2 |
femn78_kg | 21,3 | 26,9 | 32,9 |
mn_recovery | 0,601 | 0,748 | 0,800 |
manganese_pct | 0,475 | 0,643 | 0,796 |
superheat_c | 39,6 | 57,1 | 73,2 |
femn78_min_kg | 15,9 | 17,0 | 21,1 |
femn78_headroom_kg | 1,6 | 9,8 | 16,6 |
Из таблицы следуют четыре вещи, и все печальные.
Температура выпуска не доходит до порога штрафа. Максимум 1573 °C при пороге 1640 °C. Штраф за перегрев в коде есть, но на этих данных он не срабатывает. Модель не могла выучить его влияние, потому что влияния в данных нет.
Кислород почти всегда у нижней границы. Среднее 42,2 м³ при полу 35 и пороге штрафа 60. Выше 60 ушло только несколько плавок (максимум 61,6).
ФС75 почти константа. Среднее 15,11 кг при нижней границе 15. У кремния по сути нет вариации, поэтому предсказывать его дозу нечего, и целевой переменной он не стал.
Основность шлака объясняет около 70% важности. Это не открытие о металлургии, а следствие того, что в моих правилах из трёх штрафов реально живёт один.
Отсюда выводы:
Модель, обученная на этих данных, восстанавливает правила генератора, а не поведение настоящей печи. Хорошая метрика на синтетике говорит о методике, а не о металлургии.
furnace_noise — случайная невязка, которую я добавил намеренно, чтобы остаток не был нулевым. Она по определению непредсказуема.
Ни один коэффициент не откалиброван по реальной печи. Все пороги (1640 °C, 60 м³, основность 2,0), все веса штрафов и все диапазоны шихты написаны мной по общему представлению о процессе.
Выбор порога 89,4% годных плавок не подгонялся. Он получился из правил после того, как я убрал ступенчатые функции, и совпал с тем, что называют нормальным уровнем брака для литейного цеха. Совпадение я не считаю доказательством.
Если использовать проект как основу, первое, что стоит сделать: заменить диапазоны и пороги в начале generator.py на свои, а потом проверить, что в сгенерированных данных штрафы начинают срабатывать, то есть повторить таблицу выше.
Итоги
Генератор умещается в один файл и воспроизводится одной командой с фиксированным seed. Главный урок: первая версия давала правдоподобные цифры и бесполезные данные. Поймать это помогли не метрики модели, а простые проверки самих данных: число уникальных значений, минимумы и максимумы, живы ли пороги.


Для участия в Чате вам необходим бесплатный аккаунт pro-blockchain.com
Войти
Регистрация
Похожие новости
Подпишись на telegram канал и узнавай первым обо всех новостях