 Русский
 English
Cryptocurrencies:
8086 /
Markets: 109515
Market Cap: $ 2 680 993 449 326 /
24h Vol: $ 72 444 019 587 /
BTC
Dominance: 60.043120200776%
Новости
Как сделать RAG по профессиональной документации
Привет, Хабр! Хотелось бы начать статью с такого вопроса: кто из нас еще не использовал чат ассистентов в своей работе и повседневной жизни? Вот и мы, команда Джеймикс, постоянно используем ИИ-агентов и ассистентов в своей рутине. Кто с нами не знаком — мы (Джеймикс, Jmix) open-source платформа с ИИ-инструментами для стандартизации разработки корпоративных приложений на Java. И так уж вышло, что у нас есть потребность в постоянной поддержке нашего сообщества в эксплуатации и разработке на нашей же технологии. На это мы постоянно выделяли одного разработчика-дежурного, который отвечал на все вопросы наших клиентов. Понимаете куда ведет это повествование? Конечно же, как только появились языковые модели, которые научились сносно отвечать на технические темы — сразу же возникла идея о делегировании самых базовых и простых вопросов ИИ. Ну и, конечно же, мы на поезде хайпа еще в конце 2023-го года создали собственного ИИ-ассистента на базе ChatGPT 4, который отвечал на темы, связанные только с платформой Джеймикса.
Время шло, мы вводили небольшие продуктовые изменения и наш ассистент стал что-то вроде системы индексатора и поисковика для мозга-нейросети. Нас устраивала точность ответов нашего ассистента — но был нюанс. Индексатор-поисковик был нужен еще для внешних агентов, которые вызывали его через отдельный MCP — и тут было больше подводных камней.
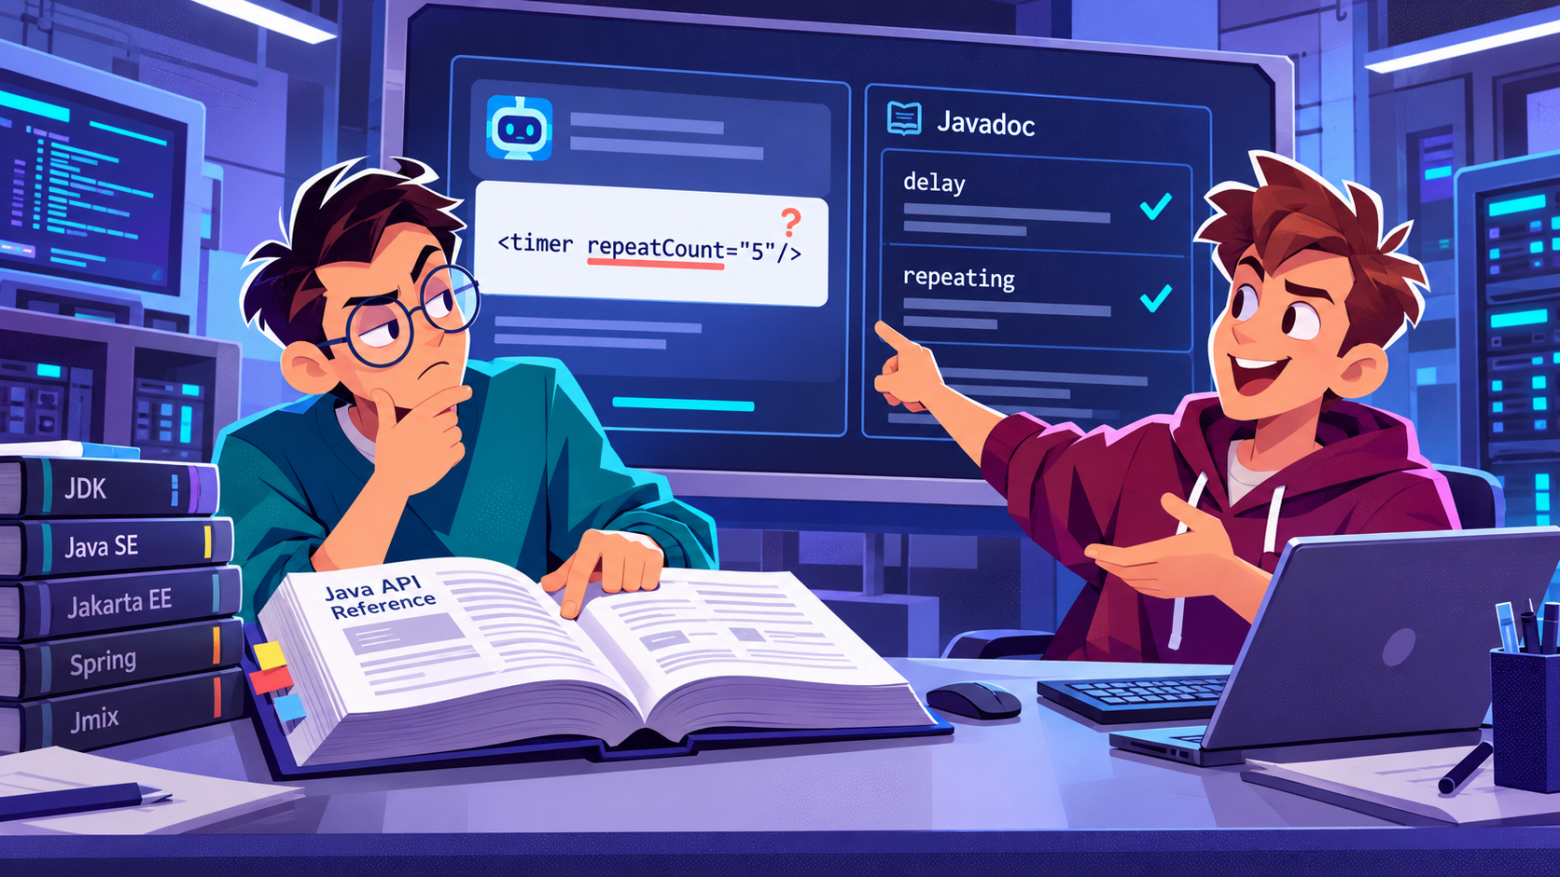
И вот прошло 3 года, и мы решили задать вопрос с подвохом (ну бывает же такое, когда хочется спросить что-то каверзное у ИИ). Звучал вопрос так: “какое значение repeatCount заставит таймер сработать пять раз”. Ассистент уверенно выдал готовый XML, хотя такого атрибута в Jmix нет. Чтобы ИИ-ассистент отвечал точнее, мы перестроили поиск.
Перекопали мы все: добавили в него Javadoc, разрезали документацию на законченные примеры, поменяли настройки и промпт. На наборе контрольных вопросов новая конфигурация получила 71 зачёт из 74. Предыдущая конфигурация получала зачёт реже. Так, часть просадок оказалась ошибками модели-оценщика, который являлся автопилотом для оценки качества ответов на контрольные вопросы. Один эталон противоречил официальной документации, и это тоже мы учли.
Ниже — история того, как мы меняли систему, чтобы добиться лучшего результата ответа от одной и той же модели нейросети.
Итак, далее будут идти прикладные примеры и инструкции, как можно модернизировать систему RAG, чтобы кардинально повысить качество ответов и quality of life ваших клиентов, не меняя при этом внутреннюю ИИ-модель.
Сначала мы читали ответы
Итак, ассистент помогает тем, кто пишет на Джеймикс (для справки: Jmix — высокоуровневый Java-фреймворк для энтерпрайз-разработки и тут много технологий: Spring Boot, Spring AI, Embabel, JPA EclipseLink, Vaadin Flow и другие. В общем, огромная база знаний в каждой из сфер разработки). Далее — сам разработчик задаёт вопрос в чате, ассистент ищет ответ в документации и примерах нужной версии фреймворка и отвечает своими словами.
Сначала качество мы проверяли вручную. Задавали сами свои вопросы, читали ответы, ставили лайк или дизлайк. После каждой правки системного промпта или поисковика/индексатора ассистент снова выдавал убедительный текст, и понять, стало ли лучше, было нельзя. В общем, наши пользователи приходили, задавали свои вопросы и получали ответ. Насколько он точно отвечал с “желаемого” первого раза — мы не знали.
Далее мы подумали о точности ответов и пришли к выводу, что на вопрос о принципах можно ответить своими словами. На вопрос об API нельзя! Метод и XML-атрибут должны существовать в выбранной версии фреймворка, а код — собираться и запускаться. Где старый поиск не справлялся, хорошо видно на двух вопросах.
В первом вопросе мы попросили ассистента перечислить перегрузки FetchPlanBuilder.add, которые принимают вложенный план загрузки. План загрузки задаёт, какие свойства сущности и связанные объекты читать из базы. Ассистент не нашёл нужные методы и отказался импровизировать. Ответ был честным, но за сигнатурами разработчику всё равно пришлось бы идти в Javadoc.
Во второй вопрос мы специально заложили коварную для LLM ловушку: «Какое значение repeatCount заставит таймер сработать пять раз?». Ассистент не усомнился и предложил:
<timer delay="1000" repeating="true" repeatCount="5"/>У таймера в Jmix 2.8 такого атрибута нет. Чтобы таймер сработал пять раз, ему ставят repeating="true", считают срабатывания в обработчике TimerActionEvent через обычное и тривиальное ветвление и после пятого срабатывания вызывают stop(). Отказ хотя бы отправлял разработчика в Javadoc. Готовый XML с несуществующим атрибутом опаснее, так как его хочется скопировать.
Нас не устраивали три вещи:
ассистент путал имена API;
поиск приносил в контекст целые страницы на десятки тысяч токенов;
правки над всей системой нечем было оценить.
Потому, чтобы улучшать поиск, сначала пришлось бы научиться сравнивать ответы старой системы с новой.
Как был устроен поиск
Сравнивать ответы имеет смысл, только когда понимаешь, откуда они берутся. Поэтому сначала мы разберёмся, как ассистент находит знания и почему перегрузки FetchPlanBuilder.add прошли мимо него.
Ассистент построен по схеме RAG (retrieval-augmented generation, генерация с опорой на найденные документы). Если по-простому, прежде чем ответить, модель ищет подходящие тексты и опирается на них. Для этого страницы документации мы заранее разрезаем на фрагменты. Модель эмбеддингов (ИИ, который превращает текст в векторное представление. Так в векторы переводятся и страницы, и поисковый запрос, а затем поиск находит близкие к запросу фрагменты) переводит каждый текстовый фрагмент в вектор, а pgvector, расширение PostgreSQL, хранит эти самые векторизованные тексты.
Дальше в дело вступает чат-модель, и именно она решает, в какой момент искать. Модель вызывает поисковый инструмент и передаёт ему поисковую фразу. Бэкенд находит близкие по смыслу фрагменты. Затем реранкер, небольшая отдельная модель (у нас gpt-5.4-nano), заново сортирует их по пользе для вопроса, и лучшие попадают в контекст чат-модели.
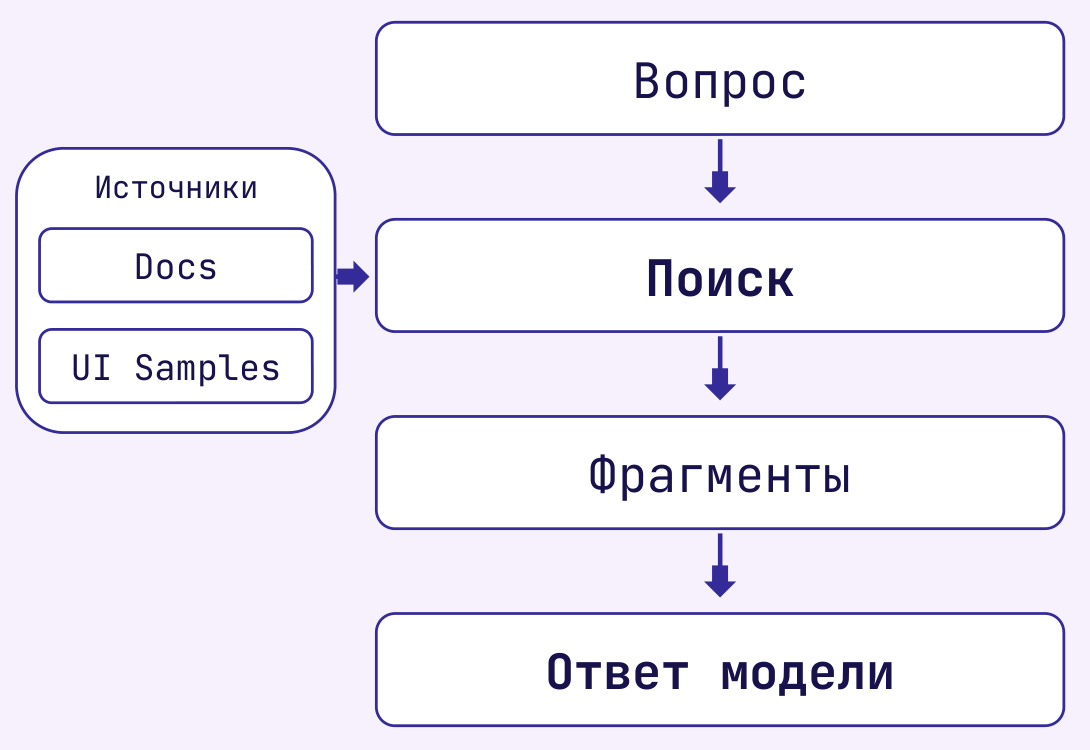
Исходная конфигурация — поиск по двум корпусам: документации (Docs) и примерам интерфейса (UI Samples)
Как видно на схеме выше, до изменений поиск работал всего по двум корпусам. Корпусом мы называем набор фрагментов одного вида, и для каждой версии Джеймикс он собран отдельно (например, корпус docs - набор всех записей-векторов в базу данных, которые относятся ТОЛЬКО к документации; альтернативно – корпус ui-samples будет набором всех векторизированных текстов про ui-samples). В docs лежала официальная документация (страница HTML за страницей в текстовом виде), в ui-samples — примеры интерфейсов, тоже в виде текста. За один вызов поиск брал 10 или 5 кандидатов, в зависимости от корпуса, и после реранкера оставлял три.
Отсюда и история с FetchPlanBuilder. Поиска по Java API не было, поэтому сигнатуры ассистент мог взять только со страниц документации. А если сигнатуры на странице нет, никакая нарезка её не создаст.
Для полноты картины: тем же индексом пользуется не только чат. Search API отдаёт найденные фрагменты по HTTP, а отдельный MCP-сервер (Model Context Protocol) передаёт их сторонним ИИ-агентам. Ответ там пишет уже модель клиента. В эксперименте мы измеряли только чат. Выдачу старого и нового MCP-сервера мы лишь показали ИИ-агенту, и новая ему понравилась больше (мнение, очевидно, субъективное).
План после этого вырисовался сам: дать поиску Javadoc, документацию резать так, чтобы примеры не рвались, а заодно поправить настройки и промпт.
Что изменили
Кратко что было и что стало:
Было | Стало | |
Корпуса | docs, uisamples | docs-snippets, uisamples-snippets, javaapi-enriched |
Кандидатов за вызов | 10 или 5 | до 12 |
Остаётся после реранкера | 3 | 6 |
Промпт | прежний | короче ответы, проверка имён API и предпосылок вопроса |
Всё это мы поменяли разом, поэтому сравнивали конфигурации целиком. Чат-модель осталась прежней. Да, так не узнать, что дало каждое изменение по отдельности. К этому мы вернёмся в конце статьи.
Как новые части связаны между собой, видно на схеме:
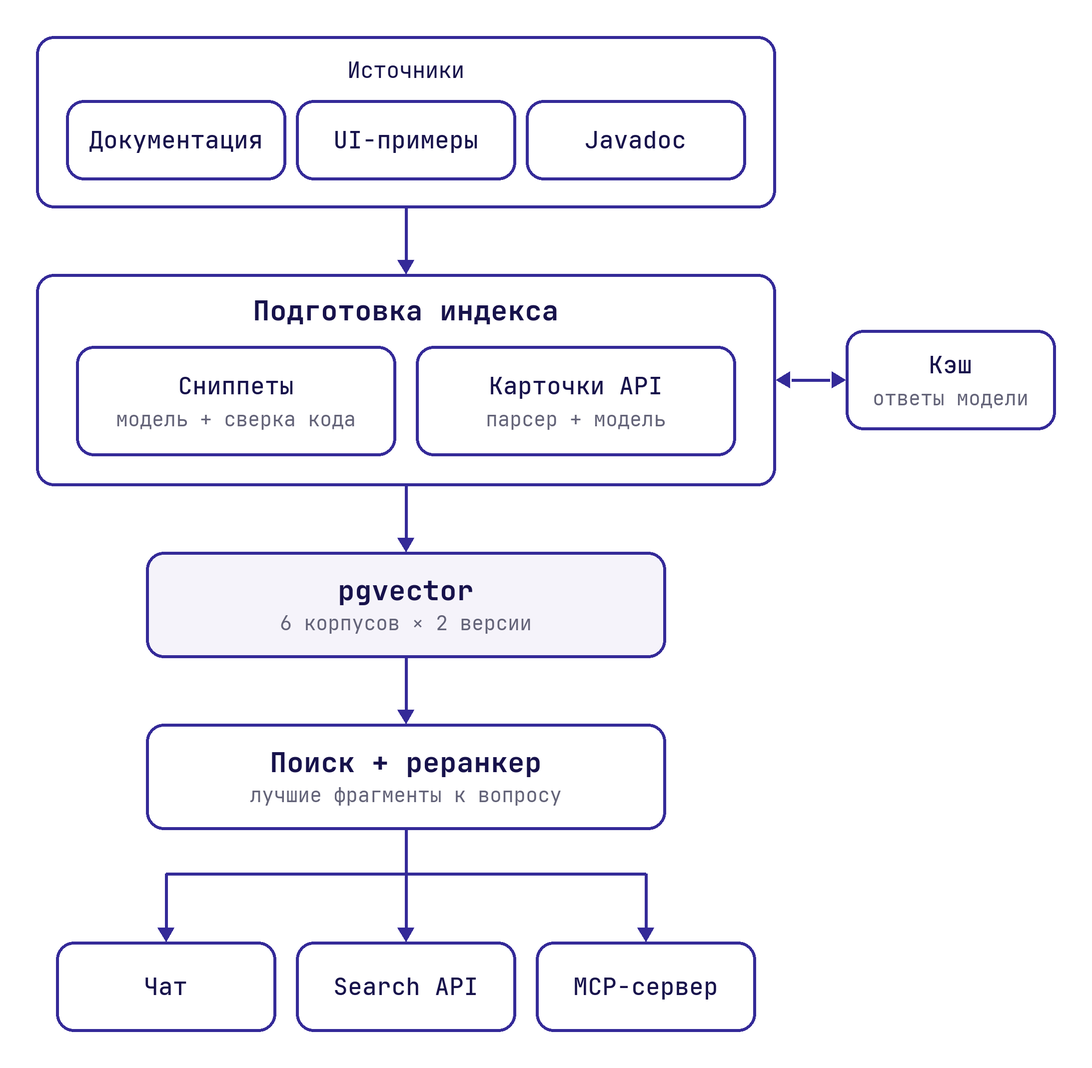
Как знания попадают к ассистенту. Кэш хранит ответы модели, чтобы при переиндексации не генерировать их заново
Сниппеты: законченные примеры вместо кусков страниц
Начнём с документации и с того, как она раньше попадала в индекс. Во время индексации мы обходили весь сайт документации Джеймикс страницу за страницей, все разом и сохраняли индексы в базу почти целиком, практически ничего не сокращая. Модель эмбеддингов превращала страницу в вектор. Если страница была слишком длинной для одного вектора, мы её разделяли. Начало шло в один вектор, остаток — в следующий. Такие куски мы и называли фрагментами (chunks для более технической аудитории).
Делили мы по длине, а не по смыслу. Граница чанка проходила там, где кончалось место, и ей было всё равно, что в этом месте написано. Аннотация могла остаться в одном чанке, а тело метода уехать в другой. XML-элемент мог разрезаться посередине. Если поиск находил только половину примера, вторую половину модели приходилось додумывать.
Тогда мы решили резать по смыслу и выделять каждый логический кусок документации в отдельный фрагмент. Искать такие куски мы поручили модели (тоже gpt-5.4-nano). Она находит на странице законченные примеры, коротко описывает каждый и переносит код дословно. Такой фрагмент мы называем сниппетом.
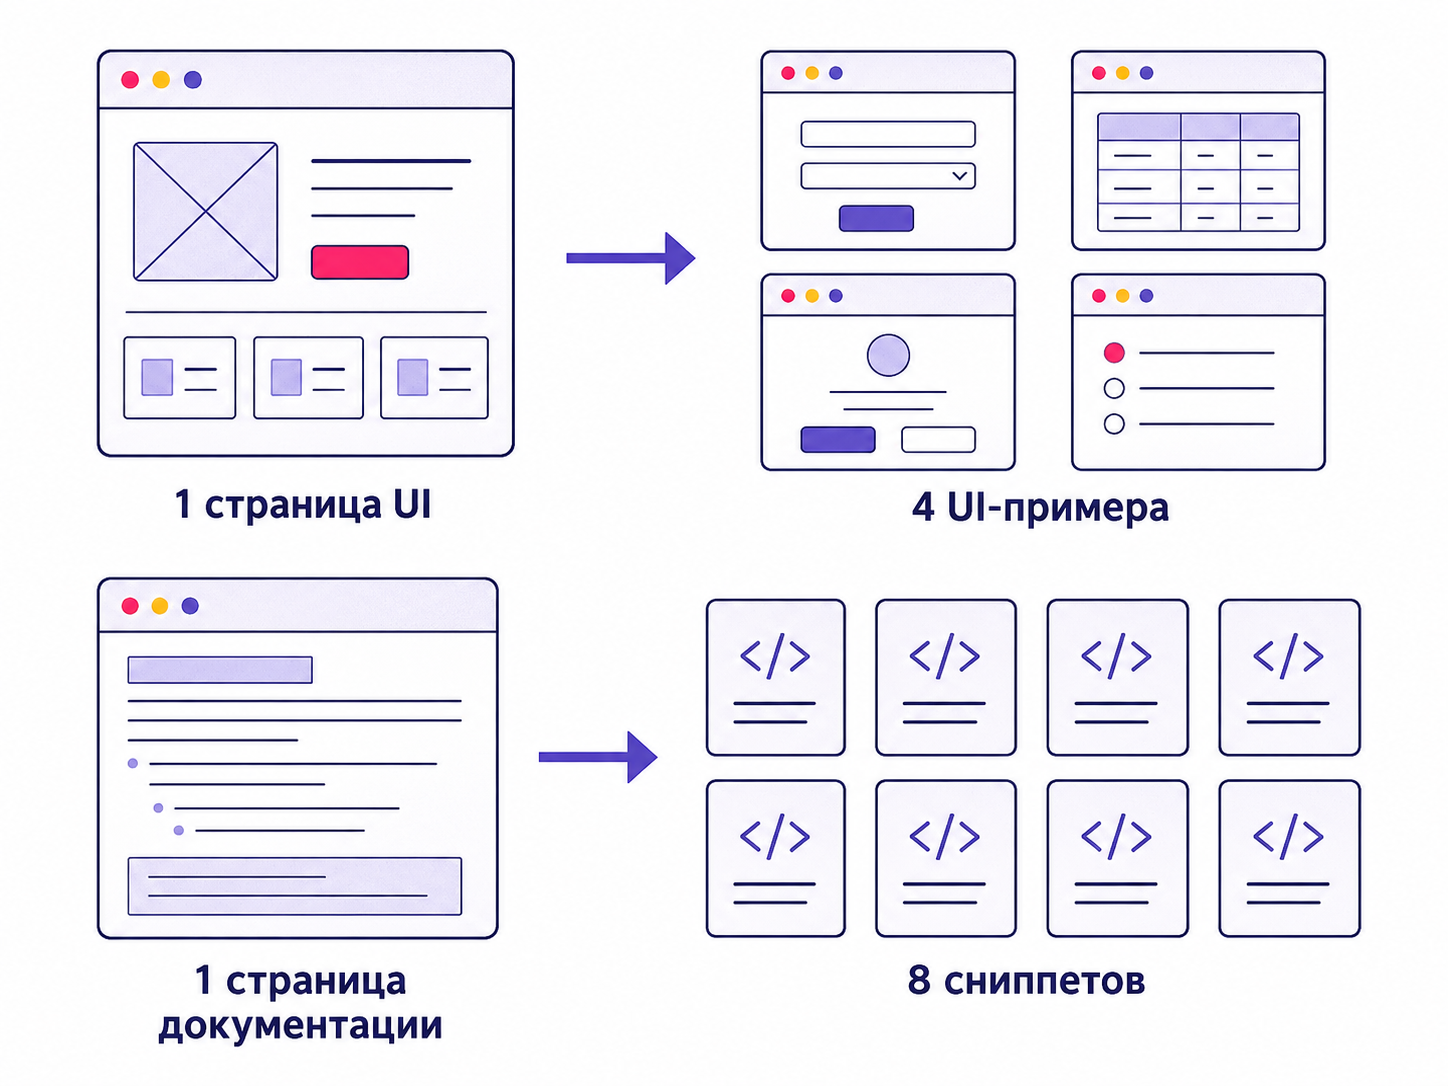
Модель находит на странице законченные примеры
Гладко вышло не сразу. Однажды модель вынесла в сниппет тело userMenuButtonRenderer, но потеряла аннотацию, которая связывает метод с компонентом интерфейса. После этого мы прямо запретили в промпте разделять такие элементы.
@Install(to = "userMenu", subject = "buttonRenderer")
private Component userMenuButtonRenderer(UserDetails userDetails) {
    // ...
    return avatar;
}
Модели мы, конечно, на слово не верим. Она может незаметно «улучшить» пример: переименовать переменную или дописать строчку от себя. Поэтому каждый блок кода из сниппета мы ищем на исходной странице дословно, как подстроку. Нашёлся — сниппет проходит. Не нашёлся — значит, модель код поменяла. Во время эксперимента одно такое несовпадение отбрасывало все сниппеты страницы, сейчас отбрасывается только испорченный.
Но сниппеты покрывают только примеры, а между ними на странице есть обычный текст: объяснения, оговорки, таблицы. Чтобы он не потерялся, в тот же корпус мы кладём и полный текст страницы, нарезанный по длине, как раньше, кусками по 8000 символов. Это страховка. Если модель со страницей не справилась, страница всё равно находится поиском, а при следующей переиндексации модель попробует снова.
У сверки есть предел. Она подтверждает, что код взят со страницы, но не говорит, правилен ли он и безопасен ли. Если ошибка есть на самой странице, сверка её пропустит. Поэтому такой конвейер годится только для доверенных источников вроде нашей документации и Javadoc. Сниппеты мы сложили в корпуса docs-snippets и uisamples-snippets, исходные docs и uisamples остались рядом.
С примерами сниппеты помогли. А вот сигнатур FetchPlanBuilder.add в документации от этого не прибавилось.
Карточки из Javadoc
Сигнатуры живут в Javadoc, туда мы и отправились. Javadoc Джеймикс опубликован как обычный HTML-сайт, по странице на класс, а на странице allclasses-index.html лежит список всех классов. С этого списка и начинает наш парсер. Он открывает страницу каждого класса и забирает оттуда типы, конструкторы, методы, поля и константы перечислений. Объявления он копирует как есть, ничего не пересказывая.
Из этого парсер собирает карточку класса: имя типа, ссылку на страницу Javadoc и объявления в едином формате. Модель здесь не участвует, поэтому выдумать метод некому: из одного и того же Javadoc всегда получаются одни и те же карточки. Они лежат в корпусе javaapi.
Но голые сигнатуры плохо находятся по живому вопросу. Разработчик пишет «как загрузить заказ вместе с его позициями», а в карточке FetchPlanBuilder только объявления вроде add(String property, FetchPlanBuilder builder). Слов из вопроса в карточке нет, и векторный поиск может её не найти.
Поэтому для второго корпуса, javaapi-enriched, модель дописывает к каждой карточке описание класса и пример использования. Пример есть всегда, если в карточке перечислен хотя бы один метод, конструктор, поле или константа. Собирать его модель может только из того, что есть в карточке. Методы других типов, например у параметров или возвращаемых объектов, она не угадывает, а прячет за заглушкой /* ... */. Сигнатуры по-прежнему берутся из Javadoc. Но в конфигурации, которую мы тестировали, текст модели тоже попадал в контекст чата.
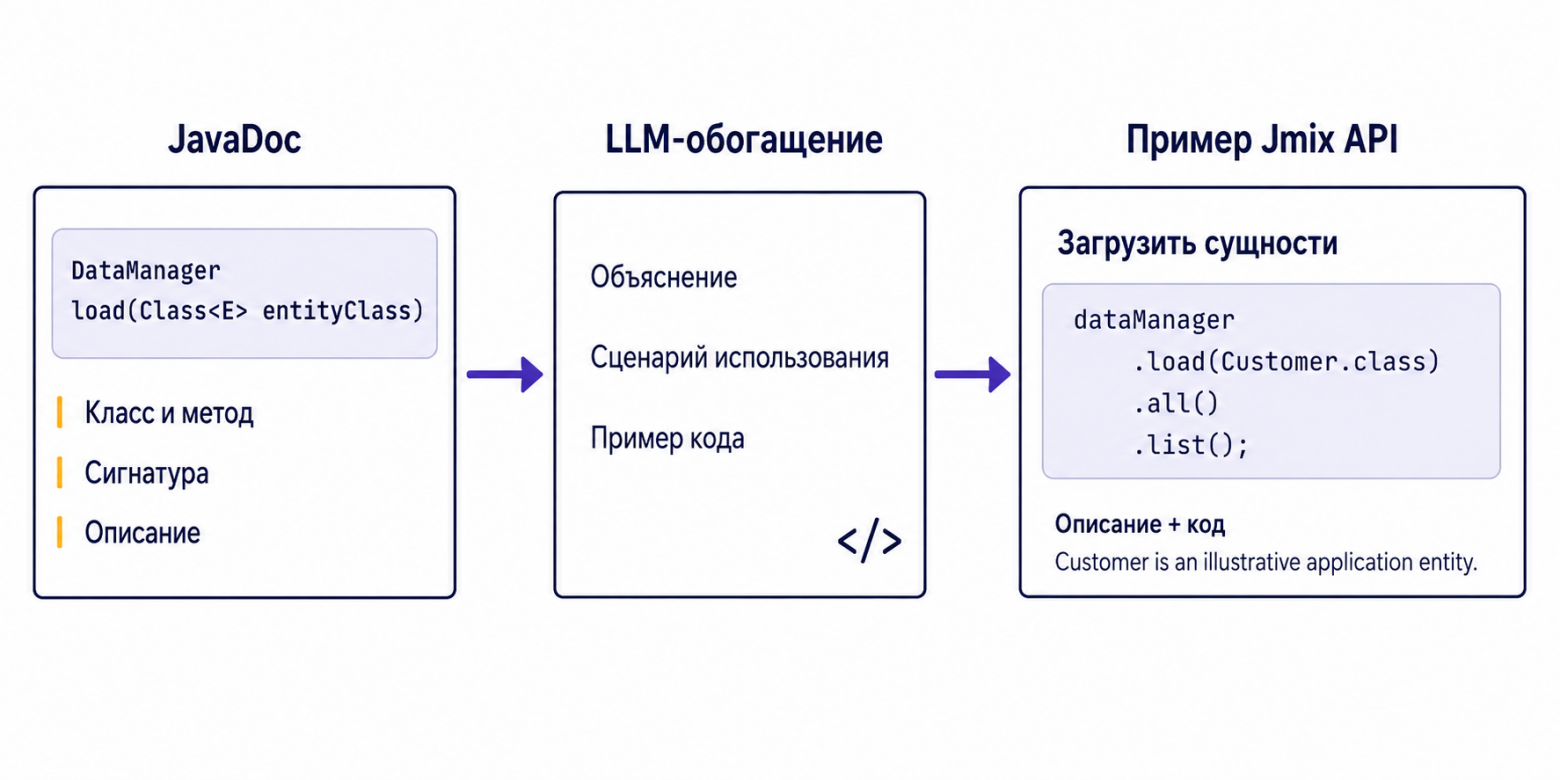
Сигнатуры берутся из Javadoc, описание и пример пишет модель
Отдельная история — большие классы. У некоторых классов методов столько, что карточка целиком не влезает в один фрагмент: у модели эмбеддингов есть предел, около 8 тысяч токенов. Да и чем фрагмент короче, тем точнее его вектор. Карточки самых больших классов расходятся на десяток частей.
Такие карточки мы режем без модели, по границам строк, чтобы объявление метода не разорвалось. Заголовок и ссылку повторяем в каждой части, так что любая часть понятна и сама по себе. Поиск возвращает ограниченное число результатов (top-k), и все части большого класса в контекст могут не попасть. Поэтому в каждой части есть ссылка на полную страницу Javadoc.
Тут нас ждал сюрприз: вместе с сигнатурами в индекс попал внутренний API, который разработчикам лучше не предлагать. Тут мы решили это исправить и вспомнили, что аннотацией @Internal в Джеймикс помечают классы и пакеты, которые технически доступны, но не предназначены для прикладного кода. Отфильтровать их по HTML не вышло: в опубликованном Javadoc этой аннотации не видно.
Поэтому список внутренних классов мы собрали по исходникам фреймворка. Фильтр затронул 220 страниц из 2608. Одиннадцать классов мы всё же оставили: официальная документация прямо учит ими пользоваться.
Настройки поиска и промпт
Новые корпуса потребовали и новых настроек. Сниппеты и карточки короче страниц, поэтому в тот же объём контекста их помещается больше. Новая конфигурация берёт до 12 кандидатов и оставляет шесть после реранкера.
Ещё мы дали модели самой решать, сколько результатов ей нужно. У поискового инструмента появился необязательный параметр maxResults, не больше 50. А чтобы модели было от чего отталкиваться, в описании инструмента указан средний размер документа в токенах. Так она может прикинуть, сколько фрагментов поместится в контекст.
Промпт мы тоже переписали. Теперь он требует отвечать короче, проверять имена API, замечать ложные предпосылки в вопросе и не достраивать код по догадке. Последние два пункта — прямой привет repeatCount.
Чтобы всё это можно было откатить, старые и новые корпуса лежат в pgvector одновременно. Поисковых инструментов у чат-модели три: по документации, по UI-примерам и по Java API. Куда идти с вопросом, подсказывает системный промпт. Например, вопрос об API — к javaapi_retriever. В каком корпусе ищет каждый инструмент, задаёт один параметр:
documentation_retriever:
  vectorType: docs-snippets
uisamples_retriever:
  vectorType: uisamples-snippets
javaapi_retriever:
  enabled: true
  vectorType: javaapi-enriched
Вернуть прежнюю конфигурацию можно без переиндексации и деплоя.
Кэш и переиндексация
Осталась часть, которую пользователь не видит, — подготовка индекса. В индексе получилось шесть корпусов для двух версий Джеймикс, всего 23 128 фрагментов. Чтобы их собрать, модель режет на сниппеты тысячи страниц документации и дописывает описания к карточкам. Делать это заново при каждой переиндексации долго и дорого, поэтому ответы модели мы кэшируем.
Запись в кэше привязана к странице, версии Джеймикс, модели и версии промпта, а рядом хранится хэш страницы. Поэтому при переиндексации модель вызывается только для новых и изменившихся страниц или после смены промпта. Сам индекс мы перестраиваем так, чтобы поиск не ломался на полпути: старые фрагменты страницы удаляем только после того, как вставили новые.
Как сравнивали
Теперь можно вернуться к третьей претензии из начала: правки нечем было оценить. Чтобы их оценить, мы устроили обеим конфигурациям одинаковый экзамен.
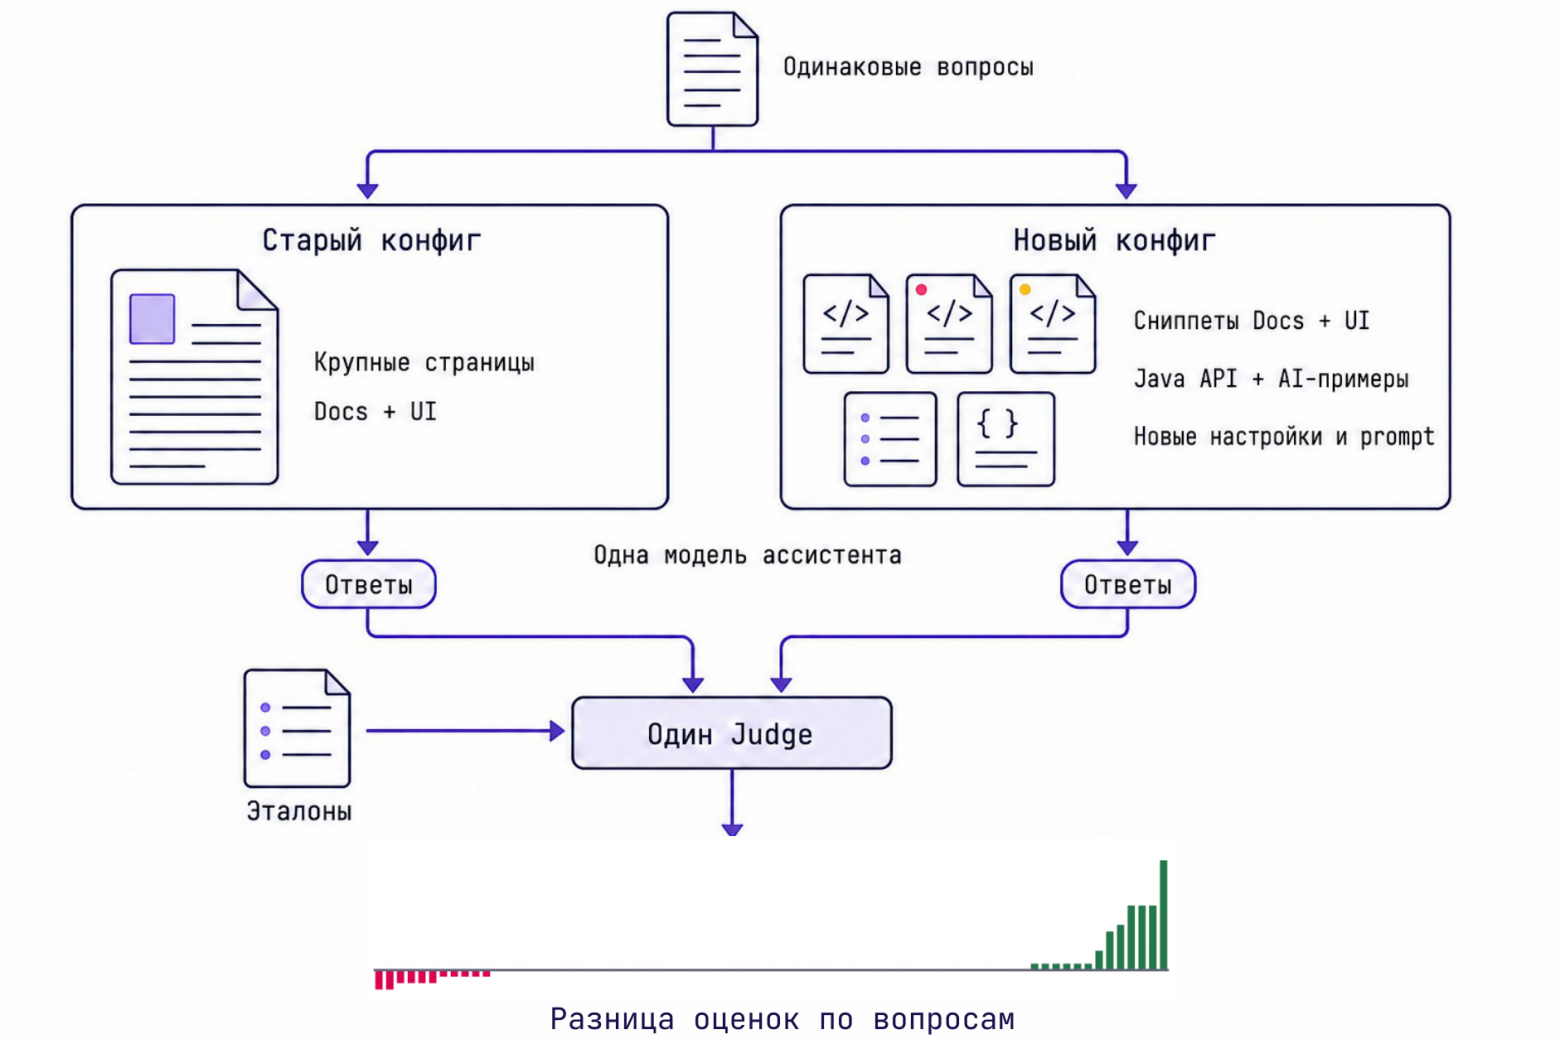
Обе конфигурации отвечают на одни и те же вопросы одной моделью, ответы проверяет один оценщик. «Старый конфиг» на схеме — исходная конфигурация, Judge — модель-оценщик. Внизу — разница баллов по вопросам, о ней ниже
Проверочный прогон устроен просто. У каждого вопроса из набора есть эталон — правильный ответ, который мы написали заранее. Бэкенд по очереди задаёт ассистенту все вопросы так же, как их задал бы пользователь, со всеми этапами поиска. Ответы сохраняются, а потом модель-оценщик сравнивает каждый ответ с эталоном и ставит балл (ниже опишем, как именно). Каждую конфигурацию мы прогнали дважды на одном экземпляре сервиса и одном векторном хранилище.
«Исходная» конфигурация — копия прежних корпусов и параметров, запущенная на том же, уже обновлённом бэкенде. Так разница между прогонами зависит от корпусов, настроек и промпта, а не от остального кода. В обеих отвечала gpt-5.1 в режиме low reasoning, эмбеддинги считала text-embedding-3-small.
Результаты прогонов удобнее всего смотреть рядом, для этого в бэкенде есть отдельный экран:
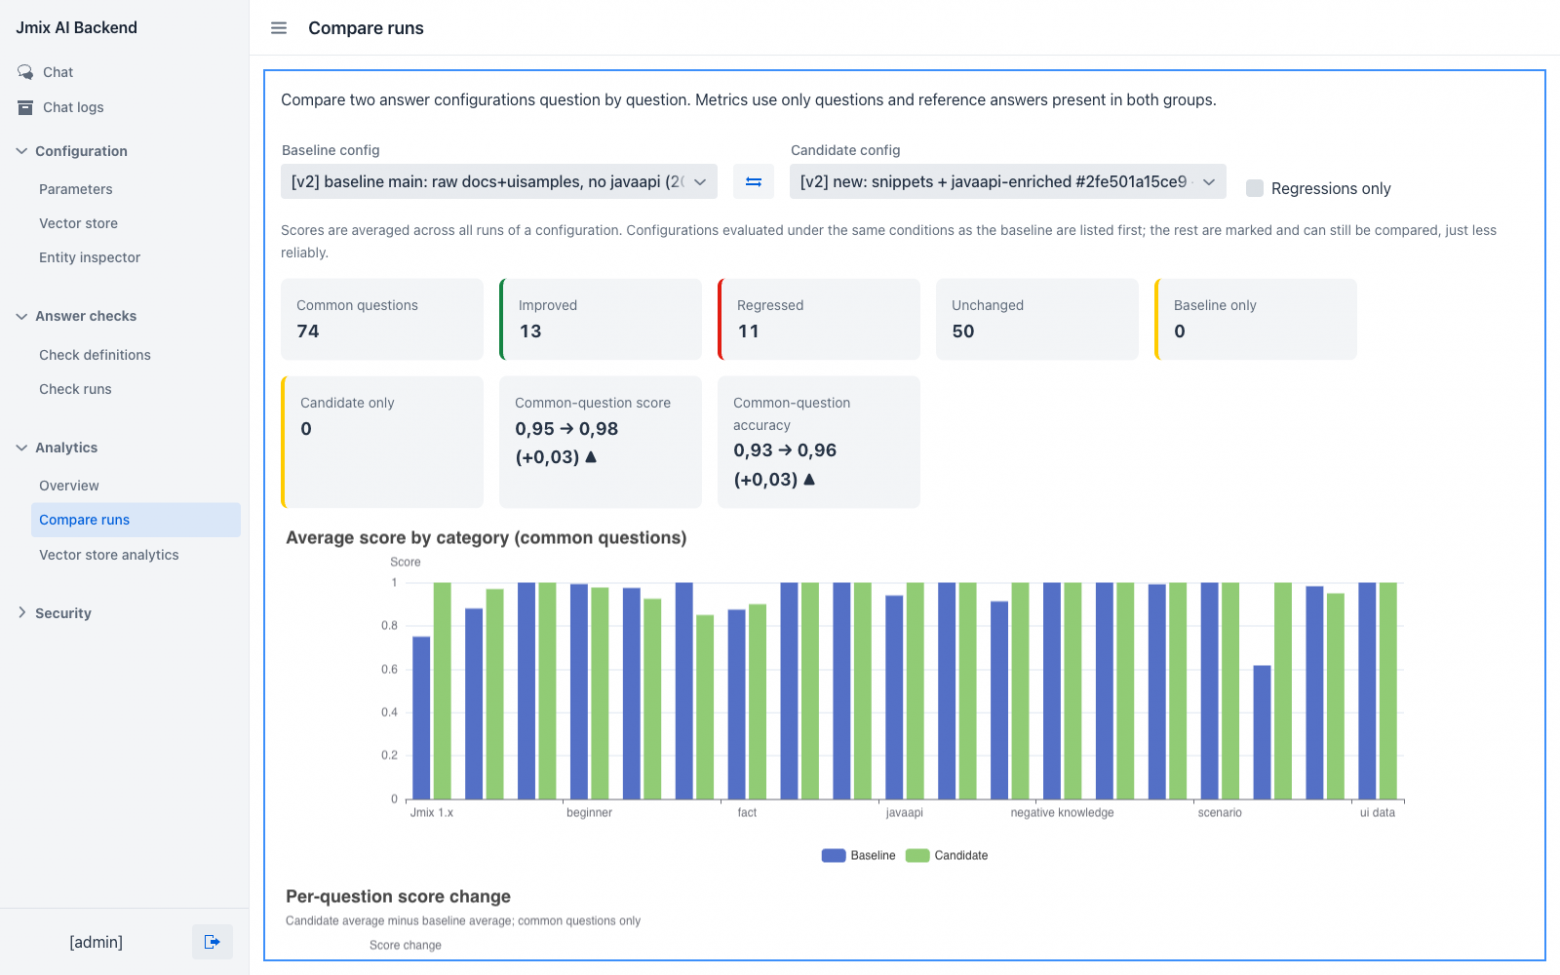
Экран сравнения прогонов. Настройки, историю прогонов и такие экраны мы сделали на самом Джеймикс, доступ к ним ограничен ролями. Категория Jmix 1.x на графике — вопросы о первой версии фреймворка: на них ассистент тоже должен отвечать правильно
Вопросы
Экзамен хорош настолько, насколько хороши вопросы. В наборе 74 вопроса, которые спрашивают о практических сценариях, коде, точных сигнатурах; составные задачи-ловушки с несуществующим API. Ну и куда без подставы про более старые версии – вопросы о Jmix 1.x. Пятнадцать вопросов написаны от лица новичка: проблема описана словами пользователя, без названия нужного механизма. Эталоны ко всем вопросам мы писали сами, и, как выяснится дальше, тоже не без ошибок.
Несколько примеров:
Тип | Вопрос | Что проверяем |
Данные | Заказы в статусе NEW, свежие сверху | Фильтр и сортировку |
Java API | Перегрузки FetchPlanBuilder.add() | Сигнатуры и типы |
UI-сценарий | Создать запись в диалоге | Обновление dataGrid |
Ловушка API | Как задать repeatCount="5"? | Ответ «такого атрибута нет» |
Оценщик
Остаётся вопрос, кто ставит оценки. Две конфигурации по два прогона на 74 вопроса — почти три сотни ответов, и читать их все после каждой правки мы не готовы. Поэтому ответы оценивала модель-оценщик gpt-5-mini. Она получает вопрос, эталон, ответ ассистента и общие критерии оценки и возвращает балл с объяснением.
Найденных поиском документов оценщик не видит. Он сверяет ответ с эталоном, но не знает, всё ли нашёл поиск и опирается ли ответ на найденное.
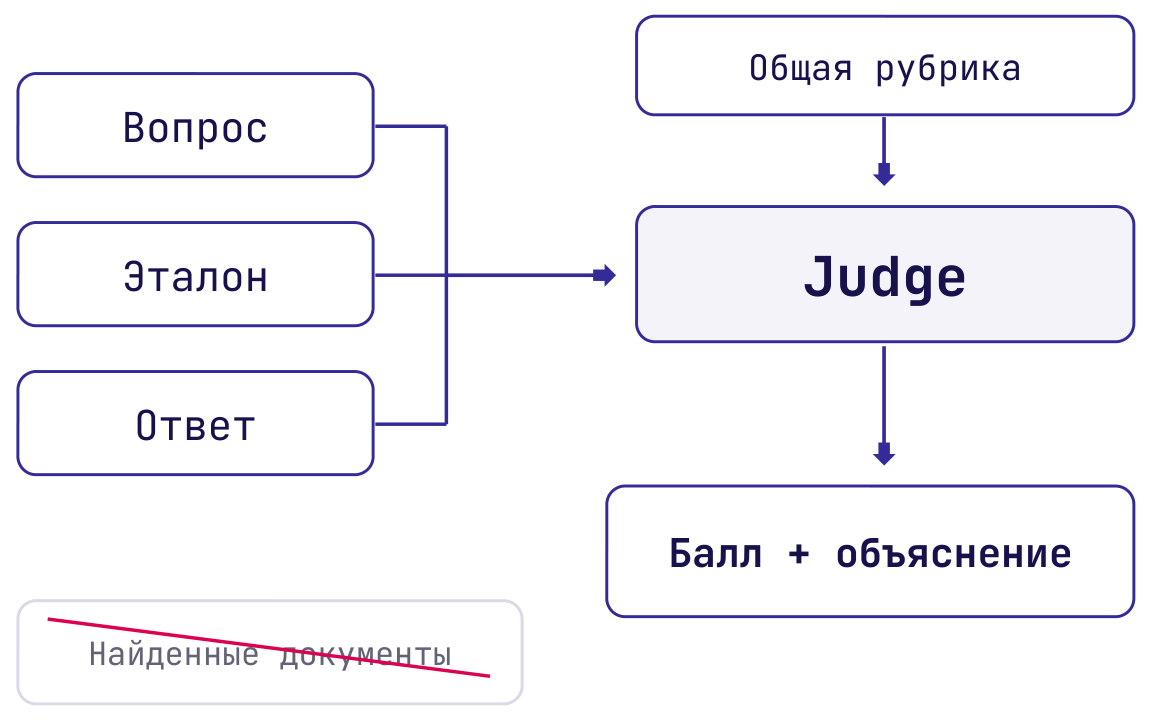
Оценщик (Judge) получает вопрос, эталон, ответ ассистента и общие критерии оценки, на схеме это «рубрика». Найденные поиском документы ему не передаются
Шкала у оценщика такая:
Балл | Значение |
1,0 | Всё верно |
0,9 | Мелкая ошибка |
0,7 | Частично верно |
0,3 | В основном неверно |
0,0 | Неверно |
Порог зачёта мы поставили на 0,8. Ответ с баллом 0,8 и выше — это ответ, который не стыдно показать клиенту. В таком ответе либо мелкая ошибка, либо оценщик придрался к правильному ответу. А ответ «частично верно» показывать уже нельзя. Поэтому 0,9 проходит, а 0,7 — нет.
На вопрос про repeatCount исходная конфигурация в одном из прогонов предложила repeatCount="5". Оценщик поставил 0,0 и объяснил, что ответ использует несуществующий атрибут. По таким объяснениям видно, за что снят балл, и по ним же мы находили ошибки самого оценщика. Почти одинаковые ответы он иногда оценивает по-разному, поэтому каждую конфигурацию мы и прогнали дважды.
71 новых правильных ответов против 68 и 70 старых показателей
Два прогона на конфигурацию дали такую таблицу:
Новая | Исходная | |
Зачёты, прогон 1 | 71 из 74 | 68 из 74 |
Зачёты, прогон 2 | 71 из 74 | 70 из 74 |
Средний балл, прогон 1 | 0,98 | 0,94 |
Средний балл, прогон 2 | 0,98 | 0,96 |
Зачёты за оба прогона | 142 из 148 | 138 из 148 |
Новая конфигурация обошла исходную в обоих прогонах: на три зачёта и на один. Радоваться, впрочем, рано, так как два прогона исходной разошлись между собой на два зачёта. Двух повторов и оценщика, которого мы не сверяли с оценками людей, мало, чтобы доказать преимущество. Это снимок одного регрессионного теста.
К тому же сумма зачётов прячет, на каких вопросах что поменялось. Поэтому для каждого вопроса мы усреднили баллы двух прогонов и вычли среднее исходной конфигурации из среднего новой. У 13 вопросов балл вырос, у 11 упал, у 50 не изменился. Сильнее всего вырос балл вопроса о перегрузках FetchPlanBuilder.add — на 0,85.
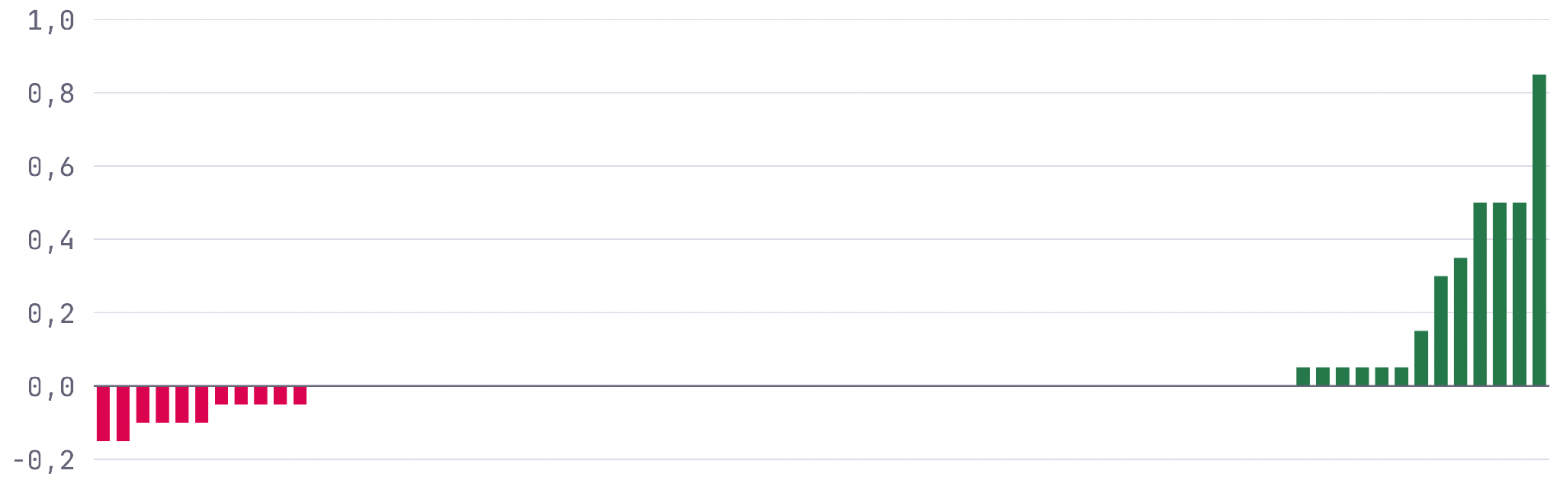
Один столбец — один вопрос: средний балл новой конфигурации минус средний балл исходной. Слева 11 вопросов, где балл упал, справа 13, где вырос, между ними 50 без изменений
Что скрыла средняя оценка
За 24 столбцами на графике стоят 24 разные истории, и по высоте столбца не понять, где виноват поиск, а где оценщик. Поэтому все 24 вопроса, где балл изменился, мы разобрали по отдельности: вопрос, эталон и четыре ответа. Вопросы без изменений мы тоже просмотрели, чтобы не попасть в ловушку ошибки выжившего. Оценщик мог одинаково зачесть неверные ответы обеих конфигураций.
И да, первым всё это читал не человек. Сначала мы натравили на стенд Claude Code. Он прочитал все ответы и отметил подозрительные. Нейрослоп должен разбирать другой ИИ, чтобы люди не тратили время впустую. Около 15 подозрительных вопросов мы потом разобрали вручную, в остальных согласились с оценщиком.
Что стало лучше
Начнём с приятного. Из 13 вопросов, где балл вырос, у семи он вырос в обоих новых прогонах. У остальных шести рост держался на одном прогоне, и его легко списать на разброс. Три из семи устойчивых — о точном API FetchPlanBuilder, UserRepository и UnconstrainedDataManager.load. По одной документации ассистент не мог перечислить все нужные методы UserRepository и три перегрузки load с типами возврата. Новая конфигурация справилась в обоих прогонах. На вопрос о FetchPlanBuilder.add она перечислила все шесть перегрузок с вложенным планом:
FetchPlanBuilder add(String property, FetchPlanBuilder builder)
FetchPlanBuilder add(String property, FetchPlanBuilder builder, FetchMode fetchMode)
FetchPlanBuilder add(String property, String fetchPlanName)
FetchPlanBuilder add(String property, String fetchPlanName, FetchMode fetchMode)
FetchPlanBuilder add(String property, Consumer<FetchPlanBuilder> consumer)
FetchPlanBuilder add(String property, Consumer<FetchPlanBuilder> consumer, FetchMode fetchMode)
Седьмая перегрузка, add(String property), добавляет простое свойство и в ответ не входит.
И, конечно, repeatCount. Новая конфигурация в обоих прогонах ответила, что такого атрибута нет, и предложила счётчик в обработчике и stop() после пятого срабатывания. Исходная тоже ответила верно в одном прогоне из двух, поэтому её средний балл здесь 0,5, а не 0.
Что стало хуже
С просадками интереснее. Одиннадцать штук мы разложили по причинам:
Причина | Вопросов |
Разброс оценщика | 4 |
Разовая ошибка модели | 2 |
Ответ пропустил важные детали | 3 |
Неверный эталон | 1 |
Причину не нашли | 1 |
Категории мы придумали, уже прочитав ответы, поэтому метрикой их не считаем. Вот четыре показательных случая.
Оценщик ошибся. В вопросе о заказах NEW средний балл упал с 0,95 до 0,85. Один из новых ответов получил 0,7 с объяснением «в JPQL нужно указывать select и from»:
return dataManager.load(Order.class)
        .query("e.status = :status order by e.createDate desc")
        .parameter("status", OrderStatus.NEW)
        .list();
Довод неверен: DataManager допускает сокращённый запрос с алиасом e. Другие замечания, например об имени поля createDate, зависят от модели данных приложения. Поэтому идеальным мы этот ответ не объявили, а балл задним числом не меняли.
Оценщик непоследователен. В вопросе о ленивой загрузке дочерних строк в TreeDataGrid три почти одинаковых ответа, включая один исходный, получили 0,9, 1,0 и 0,7. Пока мы не прочитали тексты, это выглядело как регрессия новой конфигурации!
Неожиданный ответ ассистента. Вопрос был о том, как посчитать сущности по условию через DataManager, API Джеймикс для доступа к данным. Ответы разошлись так:
исходная конфигурация оба раза ответила привычным
loadValue("select count(...)", Long.class);новая оба раза выбрала другой допустимый путь,
dataManager.getCount(LoadContext), где LoadContext хранит тип сущности и параметры загрузки:
в одном ответе запрос собран правильно, через
ctx.setQuery(LoadContext.createQuery(...));в другом модель сложила реальные имена из разных API в неожиданную цепочку
ctx.setQuery(ctx.setQueryString(...)).
Похоже, карточки из Javadoc сделали getCount заметнее, но по четырём ответам этого не доказать. Правильные объявления лежали в корпусе, но в ответе всё равно появились спорные решения.
Ошибся эталон. Вопрос проверял, для чего нужна аннотация @Install, а эталон запрещал использовать её для userMenu.buttonRenderer. Оштрафованный пример модель не выдумала: он дословно есть в официальной документации. Исправлять здесь нужно было проверочный набор, а не поиск.
По среднему баллу разброс оценщика, настоящую галлюцинацию и ошибку в эталоне не различить. В чате мы оставили новую конфигурацию. Исходную и корпус javaapi без текста модели сохранили для сравнения и отката.
Что могло исказить картину
Прежде чем делать выводы, честно перечислим, что могло нас обмануть:
мы поменяли корпуса, поиск и промпт разом и не знаем, что дало каждое изменение;
на каждую конфигурацию пришлось два прогона, статистическую значимость мы не проверяли;
оценщика не сверяли с оценками людей, и найденных документов он не видит;
мы измеряли только чат, а выдачу Search API и MCP-сервера не измеряли;
в javaapi-enriched текст модели попадал в контекст ответа;
с тех пор набор вырос до 98 вопросов, а настройки поиска поменялись, так что цифры выше относятся к моменту эксперимента.
Загадка setQuery(setQueryString(...)) и что дальше
Откуда ассистент взял цепочку ctx.setQuery(ctx.setQueryString(...)), мы так и не поняли. Текстов найденных фрагментов в журнале прогона не было, так что для нас это пока чистая магия. Когда-нибудь мы попробуем добавить BM25 (классический поиск по словам), гибридный поиск и точное совпадение Java-идентификаторов, но это дело будущего.
Нейрослоп выбивают нейрослопом
Если отойти на шаг назад, картина получается забавная.
Модели выдают сниппеты, карточки и баллы пачками, а проверять их всё равно приходится человеку
Одна модель резала документацию на сниппеты и дописывала описания к карточкам, вторая отвечала по ним, третья ставила баллы, а отдельный независимый Claude оценил это системно, исключив человека из излишней работы. Но окончательно проверять примеры и баллы всё равно пришлось нам – оценщик ошибается, а эталоны мы тоже пишем с ошибками.
Модель ассистента при этом менять не пришлось. Ответы стали лучше, потому что мы переделали всё вокруг неё: корпуса, поиск, промпт и саму проверку с вопросами, эталонами и ручным разбором.
Счёт 71 из 74 помог выбрать конфигурацию, но доверять коду в ответах по нему нельзя! Правильные объявления лежали в индексе, а ассистент всё равно собрал неожиданную цепочку методов.
Вывод
Надеюсь, читатель сделал какие-то выводы из данной статьи или, по крайней мере, её было интересно читать. Хотелось бы сказать пару финальных слов про ИИ – сейчас, пока на дворе 2026 год, кажется, что индустрия еще не устоялась и на разработчика падает много ответственности. Теперь надо придумывать хитрые механизмы интеграции и эксплуатации ИИ. Насколько эффективно будет работать система, во многом зависит от подхода и изобретательности инженера. На наш взгляд, индустрия только больше стала нуждаться именно в инженерах и красивой инженерии!
Возвращаясь к нашей системе – счёт 71 из 74 сначала нас не успокоил, так как по одной цифре не понять, где ассистент стал лучше, а где ошибся оценщик. Мы создали интересную и удобную систему оценки моделей, прочитали ответы ллм, разобрались, сделали выводы и провели работу над ошибками. Ассистент больше не попадается на repeatCount и перечисляет сигнатуры прямо из Javadoc, и качественно ответы стали короче и точнее попадать в термин “идеальный ответ с первого раза”. Выжимать ещё пару процентов точности ради идеального счёта, мы пока не будем – текущее состояние ассистента нас устраивает.
А если хотите построить свою систему поиска и ответов по документации на базе ИИ-чата попробуйте Джеймикс сами – мы как раз завезли готовые аддоны (Spring Boot Starters) для получения из коробки готовой системы. С вас только настройка поведения, промптов и бизнес-логики. Мы, кстати, тоже используем эти же аддоны в нашем ассистенте! Если есть вопросы по статье или использованию Джеймикс – ждем вас в комментариях и нашем тг-чате.
Во второй части расскажем, как этот поиск за три дня написал Claude Code и почему ревью заняло три недели.


Для участия в Чате вам необходим бесплатный аккаунт pro-blockchain.com
Войти
Регистрация
Похожие новости
Подпишись на telegram канал и узнавай первым обо всех новостях